Traducción
{#if fw === 'pt'}
{:else}
{/if}
Ahora, profundicemos en la traducción. Esta es otra tarea de secuencia a secuencia, lo que significa que es un problema que se puede formular como ir de una secuencia a otra. En ese sentido, el problema es bastante similar a la generación de resúmenes, y podrías adaptar lo que veremos aquí a otros problemas de secuencia a secuencia, como:
- Transferencia de estilo: Crear un modelo que traduzca textos escritos en un estilo determinado a otro (por ejemplo, de formal a informal o de inglés shakesperiano a inglés moderno).
- Generación de respuestas a preguntas: Crear un modelo que genere respuestas a preguntas, dado un contexto.
Si tienes un corpus lo suficientemente grande de textos en dos (o más) idiomas, puedes entrenar un nuevo modelo de traducción desde cero, como haremos en la sección sobre modelado causal del lenguaje. Sin embargo, será más rápido ajustar un modelo de traducción existente, ya sea uno multilingüe como mT5 o mBART que quieras ajustar a un par de idiomas específico, o incluso un modelo especializado en la traducción de un idioma a otro que quieras ajustar a tu corpus específico.
En esta sección, ajustaremos un modelo Marian preentrenado para traducir del inglés al francés (ya que muchos empleados de Hugging Face hablan ambos idiomas) en el conjunto de datos KDE4, que es un conjunto de datos de archivos localizados para las aplicaciones KDE. El modelo que usaremos ha sido preentrenado en un gran corpus de textos en francés e inglés tomados del conjunto de datos Opus, que en realidad contiene el conjunto de datos KDE4. Pero incluso si el modelo preentrenado que usamos ha visto esos datos durante su preentrenamiento, veremos que podemos obtener una mejor versión de él después del ajuste fino.
Una vez que hayamos terminado, tendremos un modelo capaz de hacer predicciones como esta:
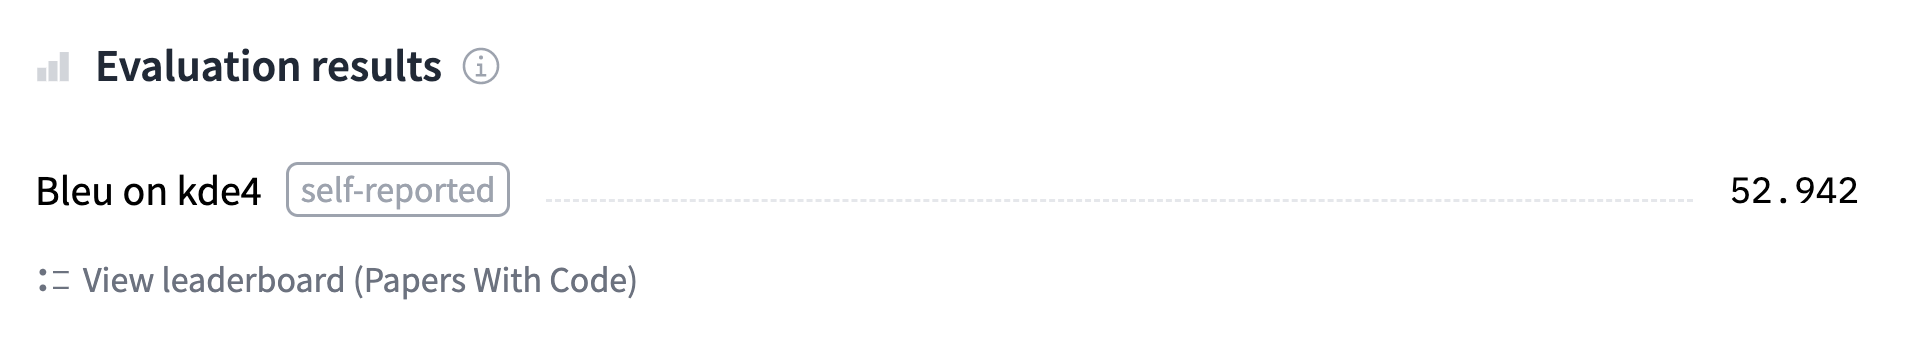
Como en las secciones anteriores, puedes encontrar el modelo real que entrenaremos y subiremos al Hub usando el código a continuación y verificar sus predicciones aquí.
Preparación de los datos[[preparing-the-data]]
Para ajustar o entrenar un modelo de traducción desde cero, necesitaremos un conjunto de datos adecuado para la tarea. Como se mencionó anteriormente, usaremos el conjunto de datos KDE4 en esta sección, pero puedes adaptar el código para usar tus propios datos con bastante facilidad, siempre y cuando tengas pares de oraciones en los dos idiomas de origen y destino. Consulta el Capítulo 5 si necesitas un recordatorio de cómo cargar tus datos personalizados en un Dataset.
El conjunto de datos KDE4[[the-kde4-dataset]]
Como de costumbre, descargamos nuestro conjunto de datos usando la función load_dataset():
from datasets import load_dataset

raw_datasets = load_dataset("kde4", lang1="en", lang2="fr")
Si quieres trabajar con un par de idiomas diferente, puedes especificarlos por sus códigos. Hay un total de 92 idiomas disponibles para este conjunto de datos; puedes verlos todos expandiendo las etiquetas de idioma en su tarjeta de conjunto de datos.
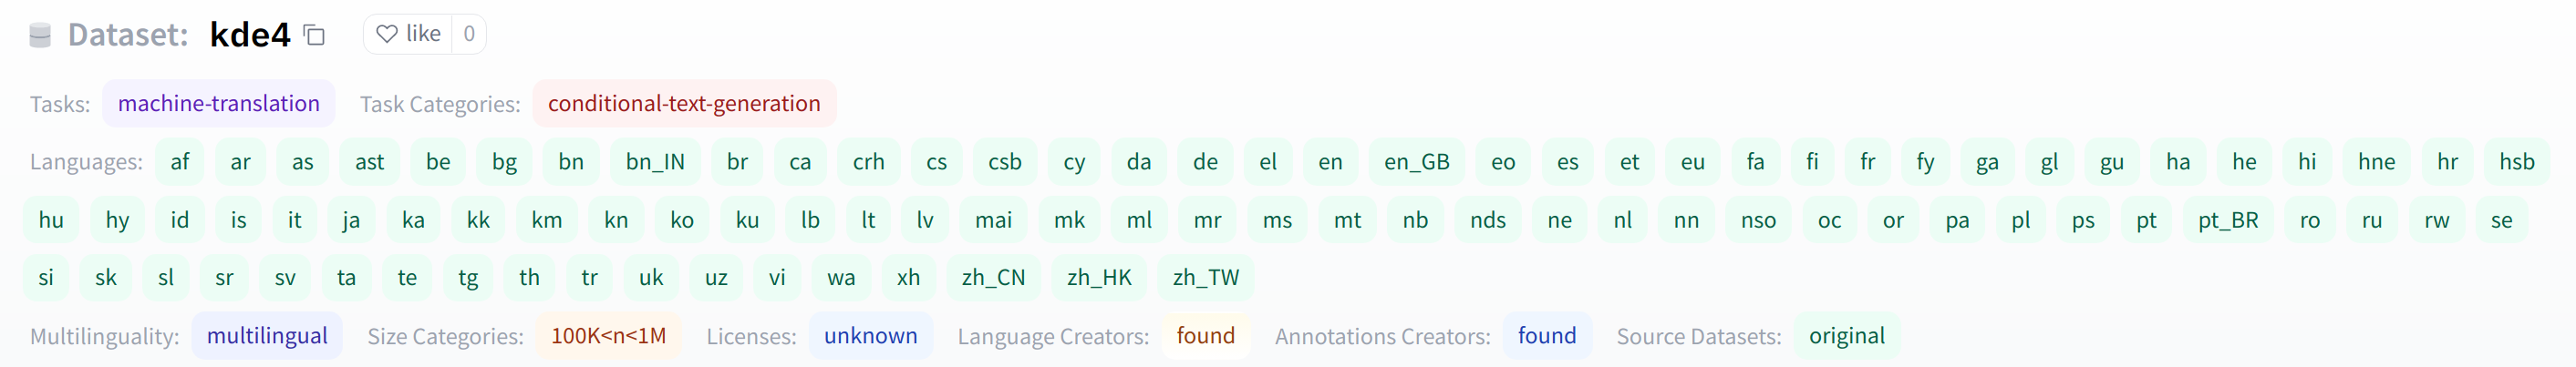
Echemos un vistazo al conjunto de datos:
raw_datasets
DatasetDict({
    train: Dataset({
        features: ['id', 'translation'],
        num_rows: 210173
    })
})
Tenemos 210,173 pares de oraciones, pero en una sola división, por lo que tendremos que crear nuestro propio conjunto de validación. Como vimos en el Capítulo 5, un Dataset tiene un método train_test_split() que puede ayudarnos. Proporcionaremos una semilla para la reproducibilidad:
split_datasets = raw_datasets["train"].train_test_split(train_size=0.9, seed=20)
split_datasets
DatasetDict({
    train: Dataset({
        features: ['id', 'translation'],
        num_rows: 189155
    })
    test: Dataset({
        features: ['id', 'translation'],
        num_rows: 21018
    })
})
Podemos renombrar la clave "test" a "validation" así:
split_datasets["validation"] = split_datasets.pop("test")
Ahora echemos un vistazo a un elemento del conjunto de datos:
split_datasets["train"][1]["translation"]
{'en': 'Default to expanded threads',
 'fr': 'Par défaut, développer les fils de discussion'}
Obtenemos un diccionario con dos oraciones en el par de idiomas que solicitamos. Una particularidad de este conjunto de datos lleno de términos técnicos de informática es que todos están completamente traducidos al francés. Sin embargo, los ingenieros franceses dejan la mayoría de las palabras específicas de informática en inglés cuando hablan. Aquí, por ejemplo, la palabra "threads" bien podría aparecer en una oración en francés, especialmente en una conversación técnica; pero en este conjunto de datos se ha traducido a la más correcta "fils de discussion". El modelo preentrenado que usamos, que ha sido preentrenado en un corpus más grande de oraciones en francés e inglés, toma la opción más fácil de dejar la palabra tal cual:
from transformers import pipeline

model_checkpoint = "Helsinki-NLP/opus-mt-en-fr"
translator = pipeline("translation", model=model_checkpoint)
translator("Default to expanded threads")
[{'translation_text': 'Par défaut pour les threads élargis'}]
Otro ejemplo de este comportamiento se puede ver con la palabra "plugin", que no es oficialmente una palabra francesa, pero que la mayoría de los hablantes nativos entenderán y no se molestarán en traducir. En el conjunto de datos KDE4, esta palabra se ha traducido al francés como la más oficial "module d'extension":
split_datasets["train"][172]["translation"]
{'en': 'Unable to import %1 using the OFX importer plugin. This file is not the correct format.',
 'fr': "Impossible d'importer %1 en utilisant le module d'extension d'importation OFX. Ce fichier n'a pas un format correct."}
Nuestro modelo preentrenado, sin embargo, se apega a la palabra inglesa compacta y familiar:
translator(
    "Unable to import %1 using the OFX importer plugin. This file is not the correct format."
)
[{'translation_text': "Impossible d'importer %1 en utilisant le plugin d'importateur OFX. Ce fichier n'est pas le bon format."}]
Será interesante ver si nuestro modelo ajustado capta esas particularidades del conjunto de datos (alerta de spoiler: lo hará).
[!TIP] ✏️ ¡Tu turno! Otra palabra inglesa que se usa a menudo en francés es "email". Encuentra la primera muestra en el conjunto de datos de entrenamiento que usa esta palabra. ¿Cómo se traduce? ¿Cómo traduce el modelo preentrenado la misma oración en inglés?
Procesamiento de los datos[[processing-the-data]]
Ya deberías saber el procedimiento: todos los textos deben convertirse en conjuntos de IDs de token para que el modelo pueda entenderlos. Para esta tarea, necesitaremos tokenizar tanto las entradas como los objetivos. Nuestra primera tarea es crear nuestro objeto tokenizer. Como se señaló anteriormente, usaremos un modelo Marian preentrenado de inglés a francés. Si estás probando este código con otro par de idiomas, asegúrate de adaptar el checkpoint del modelo. La organización Helsinki-NLP proporciona más de mil modelos en varios idiomas.
from transformers import AutoTokenizer

model_checkpoint = "Helsinki-NLP/opus-mt-en-fr"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint, return_tensors="pt")
También puedes reemplazar el model_checkpoint con cualquier otro modelo que prefieras del Hub, o una carpeta local donde hayas guardado un modelo y un tokenizador preentrenados.
[!TIP] 💡 Si estás utilizando un tokenizador multilingüe como mBART, mBART-50 o M2M100, deberás establecer los códigos de idioma de tus entradas y objetivos en el tokenizador configurando
tokenizer.src_langytokenizer.tgt_langcon los valores correctos.
La preparación de nuestros datos es bastante sencilla. Solo hay una cosa que recordar; debes asegurarte de que el tokenizador procese los objetivos en el idioma de salida (aquí, francés). Puedes hacerlo pasando los objetivos al argumento text_targets del método __call__ del tokenizador.
Para ver cómo funciona esto, procesemos una muestra de cada idioma en el conjunto de entrenamiento:
en_sentence = split_datasets["train"][1]["translation"]["en"]
fr_sentence = split_datasets["train"][1]["translation"]["fr"]

inputs = tokenizer(en_sentence, text_target=fr_sentence)
inputs
{'input_ids': [47591, 12, 9842, 19634, 9, 0], 'attention_mask': [1, 1, 1, 1, 1, 1], 'labels': [577, 5891, 2, 3184, 16, 2542, 5, 1710, 0]}
Como podemos ver, la salida contiene los IDs de entrada asociados con la oración en inglés, mientras que los IDs asociados con la francesa se almacenan en el campo labels. Si olvidas indicar que estás tokenizando etiquetas, serán tokenizadas por el tokenizador de entrada, lo que en el caso de un modelo Marian no saldrá nada bien:
wrong_targets = tokenizer(fr_sentence)
print(tokenizer.convert_ids_to_tokens(wrong_targets["input_ids"]))
print(tokenizer.convert_ids_to_tokens(inputs["labels"]))
['▁Par', '▁dé', 'f', 'aut', ',', '▁dé', 've', 'lop', 'per', '▁les', '▁fil', 's', '▁de', '▁discussion', '</s>']
['▁Par', '▁défaut', ',', '▁développer', '▁les', '▁fils', '▁de', '▁discussion', '</s>']
Como podemos ver, usar el tokenizador de inglés para preprocesar una oración en francés resulta en muchos más tokens, ya que el tokenizador no conoce ninguna palabra en francés (excepto aquellas que también aparecen en el idioma inglés, como "discussion").
Dado que inputs es un diccionario con nuestras claves habituales (IDs de entrada, máscara de atención, etc.), el último paso es definir la función de preprocesamiento que aplicaremos a los conjuntos de datos:
max_length = 128


def preprocess_function(examples):
    inputs = [ex["en"] for ex in examples["translation"]]
    targets = [ex["fr"] for ex in examples["translation"]]
    model_inputs = tokenizer(
        inputs, text_target=targets, max_length=max_length, truncation=True
    )
    return model_inputs
Ten en cuenta que establecemos la misma longitud máxima para nuestras entradas y salidas. Dado que los textos con los que estamos tratando parecen bastante cortos, usamos 128.
[!TIP] 💡 Si estás utilizando un modelo T5 (más específicamente, uno de los checkpoints
t5-xxx), el modelo esperará que las entradas de texto tengan un prefijo que indique la tarea en cuestión, comotranslate: English to French:.
[!WARNING] ⚠️ No prestamos atención a la máscara de atención de los objetivos, ya que el modelo no la esperará. En su lugar, las etiquetas correspondientes a un token de relleno deben establecerse en
-100para que se ignoren en el cálculo de la pérdida. Esto lo hará nuestro recopilador de datos más adelante, ya que estamos aplicando relleno dinámico, pero si usas relleno aquí, debes adaptar la función de preprocesamiento para establecer todas las etiquetas que corresponden al token de relleno en-100.
Ahora podemos aplicar ese preprocesamiento de una sola vez a todas las divisiones de nuestro conjunto de datos:
tokenized_datasets = split_datasets.map(
    preprocess_function,
    batched=True,
    remove_columns=split_datasets["train"].column_names,
)
Ahora que los datos han sido preprocesados, ¡estamos listos para ajustar nuestro modelo preentrenado!
{#if fw === 'pt'}
Ajuste fino del modelo con la API Trainer[[fine-tuning-the-model-with-the-trainer-api]]
El código real que usa el Trainer será el mismo que antes, con solo un pequeño cambio: aquí usamos un Seq2SeqTrainer, que es una subclase de Trainer que nos permitirá manejar correctamente la evaluación, usando el método generate() para predecir salidas a partir de las entradas. Profundizaremos en esto con más detalle cuando hablemos del cálculo de la métrica.
Lo primero es lo primero, necesitamos un modelo real para ajustar. Usaremos la API habitual AutoModel:
from transformers import AutoModelForSeq2SeqLM

model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
{:else}
Ajuste fino del modelo con Keras[[fine-tuning-the-model-with-keras]]
Lo primero es lo primero, necesitamos un modelo real para ajustar. Usaremos la API habitual AutoModel:
from transformers import TFAutoModelForSeq2SeqLM

model = TFAutoModelForSeq2SeqLM.from_pretrained(model_checkpoint, from_pt=True)
💡 El checkpoint Helsinki-NLP/opus-mt-en-fr solo tiene pesos de PyTorch, por lo que
obtendrás un error si intentas cargar el modelo sin usar el
argumento from_pt=True en el método from_pretrained(). Cuando especificas
from_pt=True, la biblioteca descargará y convertirá automáticamente los
pesos de PyTorch por ti. Como puedes ver, ¡es muy sencillo cambiar entre
frameworks en 🤗 Transformers!
{/if}
Ten en cuenta que esta vez estamos usando un modelo que fue entrenado en una tarea de traducción y que ya se puede usar, por lo que no hay advertencias sobre pesos faltantes o recién inicializados.
Colación de datos[[data-collation]]
Necesitaremos un recopilador de datos para manejar el relleno para el procesamiento por lotes dinámico. No podemos usar simplemente un DataCollatorWithPadding como en el Capítulo 3 en este caso, porque eso solo rellena las entradas (IDs de entrada, máscara de atención e IDs de tipo de token). Nuestras etiquetas también deben rellenarse a la longitud máxima encontrada en las etiquetas. Y, como se mencionó anteriormente, el valor de relleno utilizado para rellenar las etiquetas debe ser -100 y no el token de relleno del tokenizador, para asegurarse de que esos valores rellenados se ignoren en el cálculo de la pérdida.
Todo esto lo hace un DataCollatorForSeq2Seq. Al igual que el DataCollatorWithPadding, toma el tokenizer utilizado para preprocesar las entradas, pero también toma el model. Esto se debe a que este recopilador de datos también será responsable de preparar los IDs de entrada del decodificador, que son versiones desplazadas de las etiquetas con un token especial al principio. Dado que este desplazamiento se realiza de manera ligeramente diferente para diferentes arquitecturas, el DataCollatorForSeq2Seq necesita conocer el objeto model:
{#if fw === 'pt'}
from transformers import DataCollatorForSeq2Seq

data_collator = DataCollatorForSeq2Seq(tokenizer, model=model)
{:else}
from transformers import DataCollatorForSeq2Seq

data_collator = DataCollatorForSeq2Seq(tokenizer, model=model, return_tensors="tf")
{/if}
Para probar esto en algunas muestras, simplemente lo llamamos en una lista de ejemplos de nuestro conjunto de entrenamiento tokenizado:
batch = data_collator([tokenized_datasets["train"][i] for i in range(1, 3)])
batch.keys()
dict_keys(['attention_mask', 'input_ids', 'labels', 'decoder_input_ids'])
Podemos verificar que nuestras etiquetas se han rellenado a la longitud máxima del lote, usando -100:
batch["labels"]
tensor([[  577,  5891,     2,  3184,    16,  2542,     5,  1710,     0,  -100,
          -100,  -100,  -100,  -100,  -100,  -100],
        [ 1211,     3,    49,  9409,  1211,     3, 29140,   817,  3124,   817,
           550,  7032,  5821,  7907, 12649,     0]])
Y también podemos echar un vistazo a los IDs de entrada del decodificador, para ver que son versiones desplazadas de las etiquetas:
batch["decoder_input_ids"]
tensor([[59513,   577,  5891,     2,  3184,    16,  2542,     5,  1710,     0,
         59513, 59513, 59513, 59513, 59513, 59513],
        [59513,  1211,     3,    49,  9409,  1211,     3, 29140,   817,  3124,
           817,   550,  7032,  5821,  7907, 12649]])
Aquí están las etiquetas para el primer y segundo elemento de nuestro conjunto de datos:
for i in range(1, 3):
    print(tokenized_datasets["train"][i]["labels"])
[577, 5891, 2, 3184, 16, 2542, 5, 1710, 0]
[1211, 3, 49, 9409, 1211, 3, 29140, 817, 3124, 817, 550, 7032, 5821, 7907, 12649, 0]
{#if fw === 'pt'}
Pasaremos este data_collator al Seq2SeqTrainer. A continuación, echemos un vistazo a la métrica.
{:else}
Ahora podemos usar este data_collator para convertir cada uno de nuestros conjuntos de datos en un tf.data.Dataset, listo para el entrenamiento:
tf_train_dataset = model.prepare_tf_dataset(
    tokenized_datasets["train"],
    collate_fn=data_collator,
    shuffle=True,
    batch_size=32,
)
tf_eval_dataset = model.prepare_tf_dataset(
    tokenized_datasets["validation"],
    collate_fn=data_collator,
    shuffle=False,
    batch_size=16,
)
{/if}
Métricas[[metrics]]
{#if fw === 'pt'}
La característica que Seq2SeqTrainer añade a su superclase Trainer es la capacidad de usar el método generate() durante la evaluación o predicción. Durante el entrenamiento, el modelo usará el decoder_input_ids con una máscara de atención que asegura que no use los tokens después del token que está tratando de predecir, para acelerar el entrenamiento. Durante la inferencia no podremos usar esos ya que no tendremos etiquetas, por lo que es una buena idea evaluar nuestro modelo con la misma configuración.
Como vimos en el Capítulo 1, el decodificador realiza la inferencia prediciendo tokens uno por uno, algo que se implementa detrás de escena en 🤗 Transformers mediante el método generate(). El Seq2SeqTrainer nos permitirá usar ese método para la evaluación si configuramos predict_with_generate=True.
{/if}
La métrica tradicional utilizada para la traducción es la puntuación BLEU, introducida en un artículo de 2002 por Kishore Papineni et al. La puntuación BLEU evalúa qué tan cerca están las traducciones de sus etiquetas. No mide la inteligibilidad o la corrección gramatical de las salidas generadas por el modelo, sino que utiliza reglas estadísticas para asegurar que todas las palabras en las salidas generadas también aparezcan en los objetivos. Además, hay reglas que penalizan las repeticiones de las mismas palabras si no se repiten también en los objetivos (para evitar que el modelo genere oraciones como "the the the the the") y las oraciones de salida que son más cortas que las de los objetivos (para evitar que el modelo genere oraciones como "the").
Una debilidad de BLEU es que espera que el texto ya esté tokenizado, lo que dificulta la comparación de puntuaciones entre modelos que usan diferentes tokenizadores. Por lo tanto, la métrica más utilizada para comparar modelos de traducción hoy en día es SacreBLEU, que aborda esta debilidad (y otras) estandarizando el paso de tokenización. Para usar esta métrica, primero necesitamos instalar la biblioteca SacreBLEU:
!pip install sacrebleu
Luego podemos cargarlo a través de evaluate.load() como hicimos en el Capítulo 3:
metric = evaluate.load("sacrebleu")
Esta métrica tomará textos como entradas y objetivos. Está diseñada para aceptar varios objetivos aceptables, ya que a menudo hay múltiples traducciones aceptables de la misma oración; el conjunto de datos que estamos usando solo proporciona una, pero no es raro en PNL encontrar conjuntos de datos que dan varias oraciones como etiquetas. Por lo tanto, las predicciones deben ser una lista de oraciones, pero las referencias deben ser una lista de listas de oraciones.
Probemos un ejemplo:
predictions = [
    "This plugin lets you translate web pages between several languages automatically."
]
references = [
    [
        "This plugin allows you to automatically translate web pages between several languages."
    ]
]
metric.compute(predictions=predictions, references=references)
{'score': 46.750469682990165,
 'counts': [11, 6, 4, 3],
 'totals': [12, 11, 10, 9],
 'precisions': [91.67, 54.54, 40.0, 33.33],
 'bp': 0.9200444146293233,
 'sys_len': 12,
 'ref_len': 13}
Esto obtiene una puntuación BLEU de 46.75, lo cual es bastante bueno; como referencia, el modelo Transformer original en el artículo "Attention Is All You Need" logró una puntuación BLEU de 41.8 en una tarea de traducción similar entre inglés y francés. (Para obtener más información sobre las métricas individuales, como counts y bp, consulta el repositorio de SacreBLEU). Por otro lado, si probamos con los dos tipos de predicciones malas (muchas repeticiones o demasiado cortas) que a menudo provienen de modelos de traducción, obtendremos puntuaciones BLEU bastante malas:
predictions = ["This This This This"]
references = [
    [
        "This plugin allows you to automatically translate web pages between several languages."
    ]
]
metric.compute(predictions=predictions, references=references)
{'score': 1.683602693167689,
 'counts': [1, 0, 0, 0],
 'totals': [4, 3, 2, 1],
 'precisions': [25.0, 16.67, 12.5, 12.5],
 'bp': 0.10539922456186433,
 'sys_len': 4,
 'ref_len': 13}
predictions = ["This plugin"]
references = [
    [
        "This plugin allows you to automatically translate web pages between several languages."
    ]
]
metric.compute(predictions=predictions, references=references)
{'score': 0.0,
 'counts': [2, 1, 0, 0],
 'totals': [2, 1, 0, 0],
 'precisions': [100.0, 100.0, 0.0, 0.0],
 'bp': 0.004086771438464067,
 'sys_len': 2,
 'ref_len': 13}
La puntuación puede ir de 0 a 100, y cuanto más alta, mejor.
{#if fw === 'tf'}
Para pasar de las salidas del modelo a los textos que la métrica puede usar, utilizaremos el método tokenizer.batch_decode(). Solo tenemos que limpiar todos los -100 en las etiquetas; el tokenizador hará automáticamente lo mismo para el token de relleno. Definamos una función que tome nuestro modelo y un conjunto de datos y calcule las métricas en él. También vamos a usar un truco que aumenta drásticamente el rendimiento: compilar nuestro código de generación con XLA, el compilador de álgebra lineal acelerada de TensorFlow. XLA aplica varias optimizaciones al grafo de cómputo del modelo, y resulta en mejoras significativas en la velocidad y el uso de la memoria. Como se describe en el blog de Hugging Face, XLA funciona mejor cuando las formas de nuestras entradas no varían demasiado. Para manejar esto, rellenaremos nuestras entradas a múltiplos de 128, y haremos un nuevo conjunto de datos con el recopilador de relleno, y luego aplicaremos el decorador @tf.function(jit_compile=True) a nuestra función de generación, que marca toda la función para su compilación con XLA.
from tqdm import tqdm

generation_data_collator = DataCollatorForSeq2Seq(
    tokenizer, model=model, return_tensors="tf", pad_to_multiple_of=128
)

tf_generate_dataset = model.prepare_tf_dataset(
    tokenized_datasets["validation"],
    collate_fn=generation_data_collator,
    shuffle=False,
    batch_size=8,
)


@tf.function(jit_compile=True)
def generate_with_xla(batch):
    return model.generate(
        input_ids=batch["input_ids"],
        attention_mask=batch["attention_mask"],
        max_new_tokens=128,
    )


def compute_metrics():
    all_preds = []
    all_labels = []

    for batch, labels in tqdm(tf_generate_dataset):
        predictions = generate_with_xla(batch)
        decoded_preds = tokenizer.batch_decode(predictions, skip_special_tokens=True)
        labels = labels.numpy()
        labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
        decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)
        decoded_preds = [pred.strip() for pred in decoded_preds]
        decoded_labels = [[label.strip()] for label in decoded_labels]
        all_preds.extend(decoded_preds)
        all_labels.extend(decoded_labels)

    result = metric.compute(predictions=all_preds, references=all_labels)
    return {"bleu": result["score"]}
{:else}
Para pasar de las salidas del modelo a los textos que la métrica puede usar, utilizaremos el método tokenizer.batch_decode(). Solo tenemos que limpiar todos los -100 en las etiquetas (el tokenizador hará automáticamente lo mismo para el token de relleno):
def compute_metrics(eval_preds):
    preds, labels = eval_preds
    # In case the model returns more than the prediction logits
    if isinstance(preds, tuple):
        preds = preds[0]

    decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)

    # Replace -100s in the labels as we can't decode them
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

    # Some simple post-processing
    decoded_preds = [pred.strip() for pred in decoded_preds]
    decoded_labels = [[label.strip()] for label in decoded_labels]

    result = metric.compute(predictions=decoded_preds, references=decoded_labels)
    return {"bleu": result["score"]}
{/if}
Ahora que esto está hecho, ¡estamos listos para ajustar nuestro modelo!
Ajuste fino del modelo[[fine-tuning-the-model]]
El primer paso es iniciar sesión en Hugging Face, para que puedas subir tus resultados al Model Hub. Hay una función de conveniencia para ayudarte con esto en un notebook:
from huggingface_hub import notebook_login

notebook_login()
Esto mostrará un widget donde puedes ingresar tus credenciales de inicio de sesión de Hugging Face.
Si no estás trabajando en un notebook, simplemente escribe la siguiente línea en tu terminal:
huggingface-cli login
{#if fw === 'tf'}
Antes de empezar, veamos qué tipo de resultados obtenemos de nuestro modelo sin ningún entrenamiento:
print(compute_metrics())
{'bleu': 33.26983701454733}
Una vez hecho esto, podemos preparar todo lo necesario para compilar y entrenar nuestro modelo. Observa el uso de tf.keras.mixed_precision.set_global_policy("mixed_float16"); esto le indicará a Keras que entrene usando float16, lo que puede proporcionar una aceleración significativa en GPUs que lo soporten (Nvidia 20xx/V100 o más recientes).
from transformers import create_optimizer
from transformers.keras_callbacks import PushToHubCallback


# The number of training steps is the number of samples in the dataset, divided by the batch size then multiplied
# by the total number of epochs. Note that the tf_train_dataset here is a batched tf.data.Dataset,
# not the original Hugging Face Dataset, so its len() is already num_samples // batch_size.
num_epochs = 3
num_train_steps = len(tf_train_dataset) * num_epochs

optimizer, schedule = create_optimizer(
    init_lr=5e-5,
    num_warmup_steps=0,
    num_train_steps=num_train_steps,
    weight_decay_rate=0.01,
)
model.compile(optimizer=optimizer)

# Train in mixed-precision float16
tf.keras.mixed_precision.set_global_policy("mixed_float16")
A continuación, definimos un PushToHubCallback para subir nuestro modelo al Hub durante el entrenamiento, como vimos en la sección 2, y luego simplemente ajustamos el modelo con esa devolución de llamada:
from transformers.keras_callbacks import PushToHubCallback

callback = PushToHubCallback(
    output_dir="marian-finetuned-kde4-en-to-fr", tokenizer=tokenizer
)

model.fit(
    tf_train_dataset,
    validation_data=tf_eval_dataset,
    callbacks=[callback],
    epochs=num_epochs,
)
Ten en cuenta que puedes especificar el nombre del repositorio al que quieres enviar con el argumento hub_model_id (en particular, tendrás que usar este argumento para enviar a una organización). Por ejemplo, cuando enviamos el modelo a la organización huggingface-course, añadimos hub_model_id="huggingface-course/marian-finetuned-kde4-en-to-fr" a Seq2SeqTrainingArguments. Por defecto, el repositorio utilizado estará en tu espacio de nombres y se nombrará según el directorio de salida que hayas establecido, por lo que aquí será "sgugger/marian-finetuned-kde4-en-to-fr" (que es el modelo al que enlazamos al principio de esta sección).
[!TIP] 💡 Si el directorio de salida que estás usando ya existe, debe ser un clon local del repositorio al que quieres enviar. Si no lo es, obtendrás un error al llamar a
model.fit()y tendrás que establecer un nuevo nombre.
Finalmente, veamos cómo se ven nuestras métricas ahora que el entrenamiento ha terminado:
print(compute_metrics())
{'bleu': 57.334066271545865}
En esta etapa, puedes usar el widget de inferencia en el Model Hub para probar tu modelo y compartirlo con tus amigos. ¡Has ajustado con éxito un modelo en una tarea de traducción, felicidades!
{:else}
Una vez hecho esto, podemos definir nuestro Seq2SeqTrainingArguments. Al igual que para el Trainer, usamos una subclase de TrainingArguments que contiene algunos campos más:
from transformers import Seq2SeqTrainingArguments

args = Seq2SeqTrainingArguments(
    f"marian-finetuned-kde4-en-to-fr",
    evaluation_strategy="no",
    save_strategy="epoch",
    learning_rate=2e-5,
    per_device_train_batch_size=32,
    per_device_eval_batch_size=64,
    weight_decay=0.01,
    save_total_limit=3,
    num_train_epochs=3,
    predict_with_generate=True,
    fp16=True,
    push_to_hub=True,
)
Aparte de los hiperparámetros habituales (como la tasa de aprendizaje, el número de épocas, el tamaño del lote y algo de decaimiento de peso), aquí hay algunos cambios en comparación con lo que vimos en las secciones anteriores:
- No establecemos ninguna evaluación regular, ya que la evaluación lleva un tiempo; simplemente evaluaremos nuestro modelo una vez antes del entrenamiento y después.
- Establecemos
fp16=True, lo que acelera el entrenamiento en GPUs modernas. - Establecemos
predict_with_generate=True, como se discutió anteriormente. - Usamos
push_to_hub=Truepara subir el modelo al Hub al final de cada época.
Ten en cuenta que puedes especificar el nombre completo del repositorio al que quieres enviar con el argumento hub_model_id (en particular, tendrás que usar este argumento para enviar a una organización). Por ejemplo, cuando enviamos el modelo a la organización huggingface-course, añadimos hub_model_id="huggingface-course/marian-finetuned-kde4-en-to-fr" a Seq2SeqTrainingArguments. Por defecto, el repositorio utilizado estará en tu espacio de nombres y se nombrará según el directorio de salida que hayas establecido, por lo que en nuestro caso será "sgugger/marian-finetuned-kde4-en-to-fr" (que es el modelo al que enlazamos al principio de esta sección).
[!TIP] 💡 Si el directorio de salida que estás usando ya existe, debe ser un clon local del repositorio al que quieres enviar. Si no lo es, obtendrás un error al definir tu
Seq2SeqTrainery tendrás que establecer un nuevo nombre.
Finalmente, simplemente pasamos todo al Seq2SeqTrainer:
from transformers import Seq2SeqTrainer

trainer = Seq2SeqTrainer(
    model,
    args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    data_collator=data_collator,
    tokenizer=tokenizer,
    compute_metrics=compute_metrics,
)
Antes de entrenar, primero veremos la puntuación que obtiene nuestro modelo, para verificar que no estamos empeorando las cosas con nuestro ajuste fino. Este comando tardará un poco, así que puedes tomar un café mientras se ejecuta:
trainer.evaluate(max_length=max_length)
{'eval_loss': 1.6964408159255981,
 'eval_bleu': 39.26865061007616,
 'eval_runtime': 965.8884,
 'eval_samples_per_second': 21.76,
 'eval_steps_per_second': 0.341}
Una puntuación BLEU de 39 no está nada mal, lo que refleja el hecho de que nuestro modelo ya es bueno traduciendo oraciones en inglés a francés.
A continuación, el entrenamiento, que también llevará un tiempo:
trainer.train()
Ten en cuenta que mientras ocurre el entrenamiento, cada vez que se guarda el modelo (aquí, cada época) se sube al Hub en segundo plano. De esta manera, podrás reanudar tu entrenamiento en otra máquina si es necesario.
Una vez finalizado el entrenamiento, evaluamos nuestro modelo de nuevo. ¡Esperemos que veamos alguna mejora en la puntuación BLEU!
trainer.evaluate(max_length=max_length)
{'eval_loss': 0.8558505773544312,
 'eval_bleu': 52.94161337775576,
 'eval_runtime': 714.2576,
 'eval_samples_per_second': 29.426,
 'eval_steps_per_second': 0.461,
 'epoch': 3.0}
Eso es una mejora de casi 14 puntos, lo cual es genial.
Finalmente, usamos el método push_to_hub() para asegurarnos de subir la última versión del modelo. El Trainer también redacta una tarjeta de modelo con todos los resultados de la evaluación y la sube. Esta tarjeta de modelo contiene metadatos que ayudan al Model Hub a elegir el widget para la demostración de inferencia. Normalmente, no es necesario decir nada, ya que puede inferir el widget correcto de la clase del modelo, pero en este caso, la misma clase de modelo se puede usar para todo tipo de problemas de secuencia a secuencia, por lo que especificamos que es un modelo de traducción:
trainer.push_to_hub(tags="translation", commit_message="Training complete")
Este comando devuelve la URL del commit que acaba de hacer, si quieres inspeccionarlo:
'https://huggingface.co/sgugger/marian-finetuned-kde4-en-to-fr/commit/3601d621e3baae2bc63d3311452535f8f58f6ef3'
En esta etapa, puedes usar el widget de inferencia en el Model Hub para probar tu modelo y compartirlo con tus amigos. ¡Has ajustado con éxito un modelo en una tarea de traducción, felicidades!
Si quieres profundizar un poco más en el bucle de entrenamiento, ahora te mostraremos cómo hacer lo mismo usando 🤗 Accelerate.
{/if}
{#if fw === 'pt'}
Un bucle de entrenamiento personalizado[[a-custom-training-loop]]
Ahora echemos un vistazo al bucle de entrenamiento completo, para que puedas personalizar fácilmente las partes que necesites. Se parecerá mucho a lo que hicimos en la sección 2 y el Capítulo 3.
Preparando todo para el entrenamiento[[preparing-everything-for-training]]
Ya has visto todo esto varias veces, así que revisaremos el código bastante rápido. Primero construiremos los DataLoaders a partir de nuestros conjuntos de datos, después de configurar los conjuntos de datos al formato "torch" para obtener tensores de PyTorch:
from torch.utils.data import DataLoader

tokenized_datasets.set_format("torch")
train_dataloader = DataLoader(
    tokenized_datasets["train"],
    shuffle=True,
    collate_fn=data_collator,
    batch_size=8,
)
eval_dataloader = DataLoader(
    tokenized_datasets["validation"], collate_fn=data_collator, batch_size=8
)
Luego, volvemos a instanciar nuestro modelo para asegurarnos de no continuar el fine-tuning anterior, sino de empezar de nuevo desde el modelo preentrenado:
model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
Después, necesitaremos un optimizador:
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=2e-5)
Una vez que tengamos todos esos objetos, podemos enviarlos al método accelerator.prepare(). Recuerda que si quieres entrenar en TPUs en un notebook de Colab, necesitarás mover todo este código a una función de entrenamiento, y esta no debería ejecutar ninguna celda que instancie un Accelerator.
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
Ahora que hemos enviado nuestro train_dataloader a accelerator.prepare(), podemos usar su longitud para calcular el número de pasos de entrenamiento. Recuerda que siempre debemos hacer esto después de preparar el dataloader, ya que ese método cambiará la longitud del DataLoader. Usamos una programación lineal clásica desde la tasa de aprendizaje hasta 0:
from transformers import get_scheduler

num_train_epochs = 3
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
Por último, para subir nuestro modelo al Hub, necesitaremos crear un objeto Repository en una carpeta de trabajo. Primero inicia sesión en Hugging Face Hub, si no lo has hecho ya. Determinaremos el nombre del repositorio a partir del ID del modelo que queremos darle a nuestro modelo (siéntete libre de reemplazar el repo_name con tu propia elección; solo necesita contener tu nombre de usuario, que es lo que hace la función get_full_repo_name()):
from huggingface_hub import Repository, get_full_repo_name

model_name = "marian-finetuned-kde4-en-to-fr-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'sgugger/marian-finetuned-kde4-en-to-fr-accelerate'
Luego podemos clonar ese repositorio en una carpeta local. Si ya existe, esta carpeta local debería ser un clon del repositorio con el que estamos trabajando:
output_dir = "marian-finetuned-kde4-en-to-fr-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
Ahora podemos subir cualquier cosa que guardemos en output_dir llamando al método repo.push_to_hub(). Esto nos ayudará a subir los modelos intermedios al final de cada época.
Bucle de entrenamiento[[training-loop]]
Ahora estamos listos para escribir el bucle de entrenamiento completo. Para simplificar su parte de evaluación, definimos esta función postprocess() que toma predicciones y etiquetas y las convierte en las listas de cadenas que nuestro objeto metric esperará:
def postprocess(predictions, labels):
    predictions = predictions.cpu().numpy()
    labels = labels.cpu().numpy()

    decoded_preds = tokenizer.batch_decode(predictions, skip_special_tokens=True)

    # Replace -100 in the labels as we can't decode them.
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

    # Some simple post-processing
    decoded_preds = [pred.strip() for pred in decoded_preds]
    decoded_labels = [[label.strip()] for label in decoded_labels]
    return decoded_preds, decoded_labels
El bucle de entrenamiento se parece mucho a los de la sección 2 y el Capítulo 3, con algunas diferencias en la parte de evaluación, ¡así que centrémonos en eso!
Lo primero a tener en cuenta es que usamos el método generate() para calcular las predicciones, pero este es un método de nuestro modelo base, no del modelo envuelto que 🤗 Accelerate creó en el método prepare(). Por eso primero desempaquetamos el modelo y luego llamamos a este método.
Lo segundo es que, al igual que con la clasificación de tokens, dos procesos pueden haber rellenado las entradas y etiquetas con diferentes formas, por lo que usamos accelerator.pad_across_processes() para que las predicciones y etiquetas tengan la misma forma antes de llamar al método gather(). Si no hacemos esto, la evaluación dará un error o se colgará indefinidamente.
from tqdm.auto import tqdm


progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # Training
    model.train()
    for batch in train_dataloader:
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # Evaluation
    model.eval()
    for batch in tqdm(eval_dataloader):
        with torch.no_grad():
            generated_tokens = accelerator.unwrap_model(model).generate(
                batch["input_ids"],
                attention_mask=batch["attention_mask"],
                max_length=128,
            )
        labels = batch["labels"]

        # Necessary to pad predictions and labels for being gathered
        generated_tokens = accelerator.pad_across_processes(
            generated_tokens, dim=1, pad_index=tokenizer.pad_token_id
        )
        labels = accelerator.pad_across_processes(labels, dim=1, pad_index=-100)

        predictions_gathered = accelerator.gather(generated_tokens)
        labels_gathered = accelerator.gather(labels)

        decoded_preds, decoded_labels = postprocess(predictions_gathered, labels_gathered)
        metric.add_batch(predictions=decoded_preds, references=decoded_labels)

    results = metric.compute()
    print(f"epoch {epoch}, BLEU score: {results['score']:.2f}")

    # Save and upload
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
epoch 0, BLEU score: 53.47
epoch 1, BLEU score: 54.24
epoch 2, BLEU score: 54.44
Una vez hecho esto, deberías tener un modelo con resultados bastante similares al entrenado con el Seq2SeqTrainer. Puedes revisar el que entrenamos usando este código en huggingface-course/marian-finetuned-kde4-en-to-fr-accelerate. Y si quieres probar cualquier ajuste al bucle de entrenamiento, ¡puedes implementarlos directamente editando el código mostrado arriba!
{/if}
Usando el modelo fine-tuned[[using-the-fine-tuned-model]]
Ya te hemos mostrado cómo puedes usar el modelo que ajustamos en el Model Hub con el widget de inferencia. Para usarlo localmente en un pipeline, solo tenemos que especificar el identificador de modelo adecuado:
from transformers import pipeline

# Replace this with your own checkpoint
model_checkpoint = "huggingface-course/marian-finetuned-kde4-en-to-fr"
translator = pipeline("translation", model=model_checkpoint)
translator("Default to expanded threads")
[{'translation_text': 'Par défaut, développer les fils de discussion'}]
Como era de esperar, nuestro modelo preentrenado adaptó su conocimiento al corpus en el que lo ajustamos, y en lugar de dejar la palabra en inglés "threads" sola, ahora la traduce a la versión oficial en francés. Lo mismo ocurre con "plugin":
translator(
    "Unable to import %1 using the OFX importer plugin. This file is not the correct format."
)
[{'translation_text': "Impossible d'importer %1 en utilisant le module externe d'importation OFX. Ce fichier n'est pas le bon format."}]
¡Otro gran ejemplo de adaptación de dominio!
[!TIP] ✏️ ¡Tu turno! ¿Qué devuelve el modelo en la muestra con la palabra "email" que identificaste antes?