Interpretación de las curvas de aprendizaje
Ahora que has aprendido a implementar el fine-tuning usando tanto la API Trainer como los bucles de entrenamiento personalizados, es crucial entender cómo interpretar los resultados. Las curvas de aprendizaje son herramientas invaluables que te ayudan a evaluar el rendimiento de tu modelo durante el entrenamiento e identificar posibles problemas antes de que reduzcan el rendimiento.
En esta sección, exploraremos cómo leer e interpretar las curvas de precisión y pérdida, entender qué nos dicen las diferentes formas de las curvas sobre el comportamiento de nuestro modelo y aprender cómo abordar problemas comunes de entrenamiento.
¿Qué son las curvas de aprendizaje?[[what-are-learning-curves]]
Las curvas de aprendizaje son representaciones visuales de las métricas de rendimiento de tu modelo a lo largo del tiempo durante el entrenamiento. Las dos curvas más importantes a monitorear son:
- Curvas de pérdida: Muestran cómo el error del modelo (pérdida) cambia a lo largo de los pasos o épocas de entrenamiento.
- Curvas de precisión: Muestran el porcentaje de predicciones correctas a lo largo de los pasos o épocas de entrenamiento.
Estas curvas nos ayudan a entender si nuestro modelo está aprendiendo eficazmente y pueden guiarnos para hacer ajustes que mejoren el rendimiento. En Transformers, estas métricas se calculan individualmente para cada lote y luego se registran en el disco. Luego podemos usar bibliotecas como Weights & Biases para visualizar estas curvas y seguir el rendimiento de nuestro modelo a lo largo del tiempo.
Curvas de pérdida[[loss-curves]]
La curva de pérdida muestra cómo el error del modelo disminuye con el tiempo. En una ejecución de entrenamiento exitosa típica, verás una curva similar a la siguiente:
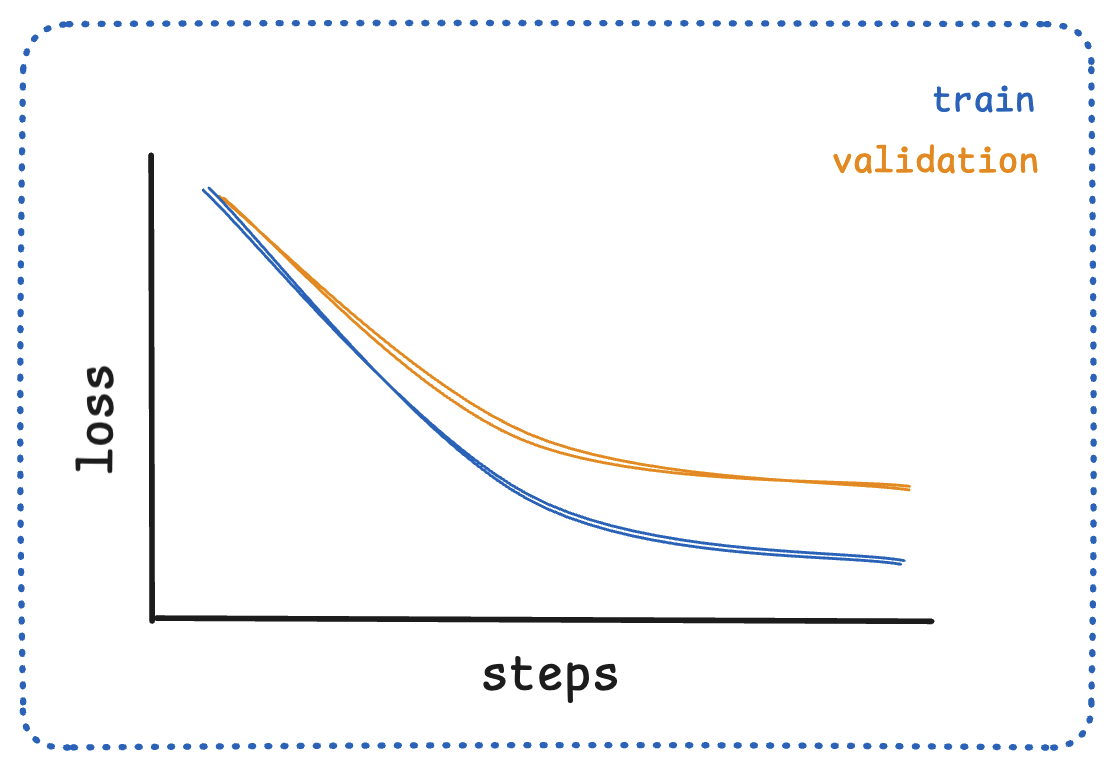
- Pérdida inicial alta: El modelo comienza sin optimización, por lo que las predicciones son inicialmente deficientes.
- Pérdida decreciente: A medida que avanza el entrenamiento, la pérdida debería disminuir generalmente.
- Convergencia: Eventualmente, la pérdida se estabiliza en un valor bajo, lo que indica que el modelo ha aprendido los patrones en los datos.
Como en capítulos anteriores, podemos usar la API Trainer para rastrear estas métricas y visualizarlas en un panel. A continuación, se muestra un ejemplo de cómo hacerlo con Weights & Biases.
# Example of tracking loss during training with the Trainer
from transformers import Trainer, TrainingArguments


# Initialize Weights & Biases for experiment tracking
wandb.init(project="transformer-fine-tuning", name="bert-mrpc-analysis")

training_args = TrainingArguments(
    output_dir="./results",
    eval_strategy="steps",
    eval_steps=50,
    save_steps=100,
    logging_steps=10,  # Log metrics every 10 steps
    num_train_epochs=3,
    per_device_train_batch_size=16,
    per_device_eval_batch_size=16,
    report_to="wandb",  # Send logs to Weights & Biases
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    data_collator=data_collator,
    processing_class=tokenizer,
    compute_metrics=compute_metrics,
)

# Train and automatically log metrics
trainer.train()
Curvas de precisión[[accuracy-curves]]
La curva de precisión muestra el porcentaje de predicciones correctas a lo largo del tiempo. A diferencia de las curvas de pérdida, las curvas de precisión generalmente deberían aumentar a medida que el modelo aprende y típicamente pueden incluir más pasos que la curva de pérdida.
- Comienza baja: La precisión inicial debería ser baja, ya que el modelo aún no ha aprendido los patrones en los datos.
- Aumenta con el entrenamiento: La precisión debería mejorar generalmente a medida que el modelo aprende si es capaz de aprender los patrones en los datos.
- Puede mostrar mesetas: La precisión a menudo aumenta en saltos discretos en lugar de suavemente, ya que el modelo hace predicciones que están cerca de las etiquetas verdaderas.
[!TIP] 💡 Por qué las curvas de precisión son "escalonadas": A diferencia de la pérdida, que es continua, la precisión se calcula comparando predicciones discretas con etiquetas verdaderas. Pequeñas mejoras en la confianza del modelo podrían no cambiar la predicción final, haciendo que la precisión permanezca plana hasta que se cruza un umbral.
Convergencia[[convergence]]
La convergencia ocurre cuando el rendimiento del modelo se estabiliza y las curvas de pérdida y precisión se nivelan. Esta es una señal de que el modelo ha aprendido los patrones en los datos y está listo para ser usado. En términos simples, nuestro objetivo es que el modelo converja a un rendimiento estable cada vez que lo entrenamos.
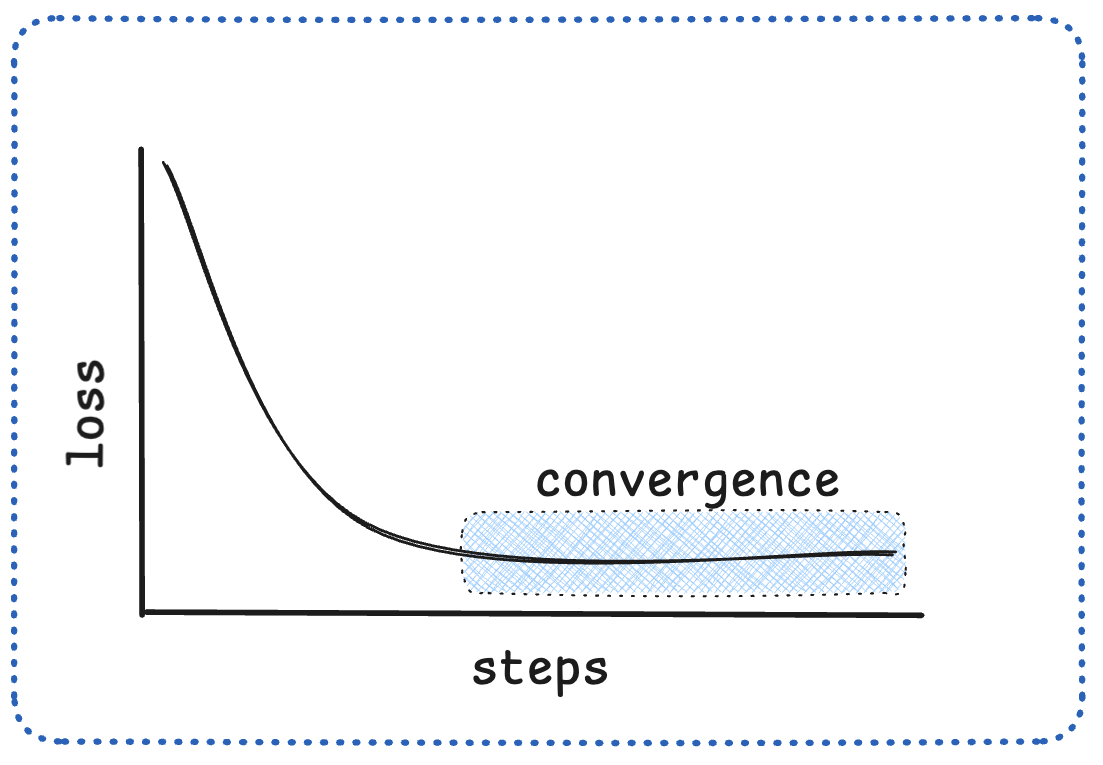
Una vez que los modelos han convergido, podemos usarlos para hacer predicciones sobre nuevos datos y consultar las métricas de evaluación para entender qué tan bien se está desempeñando el modelo.
Interpretación de patrones de curvas de aprendizaje[[interpreting-learning-curve-patterns]]
Las diferentes formas de las curvas revelan distintos aspectos del entrenamiento de tu modelo. Examinemos los patrones más comunes y lo que significan.
Curvas de aprendizaje saludables[[healthy-learning-curves]]
Una ejecución de entrenamiento bien comportada típicamente muestra formas de curva similares a la siguiente:
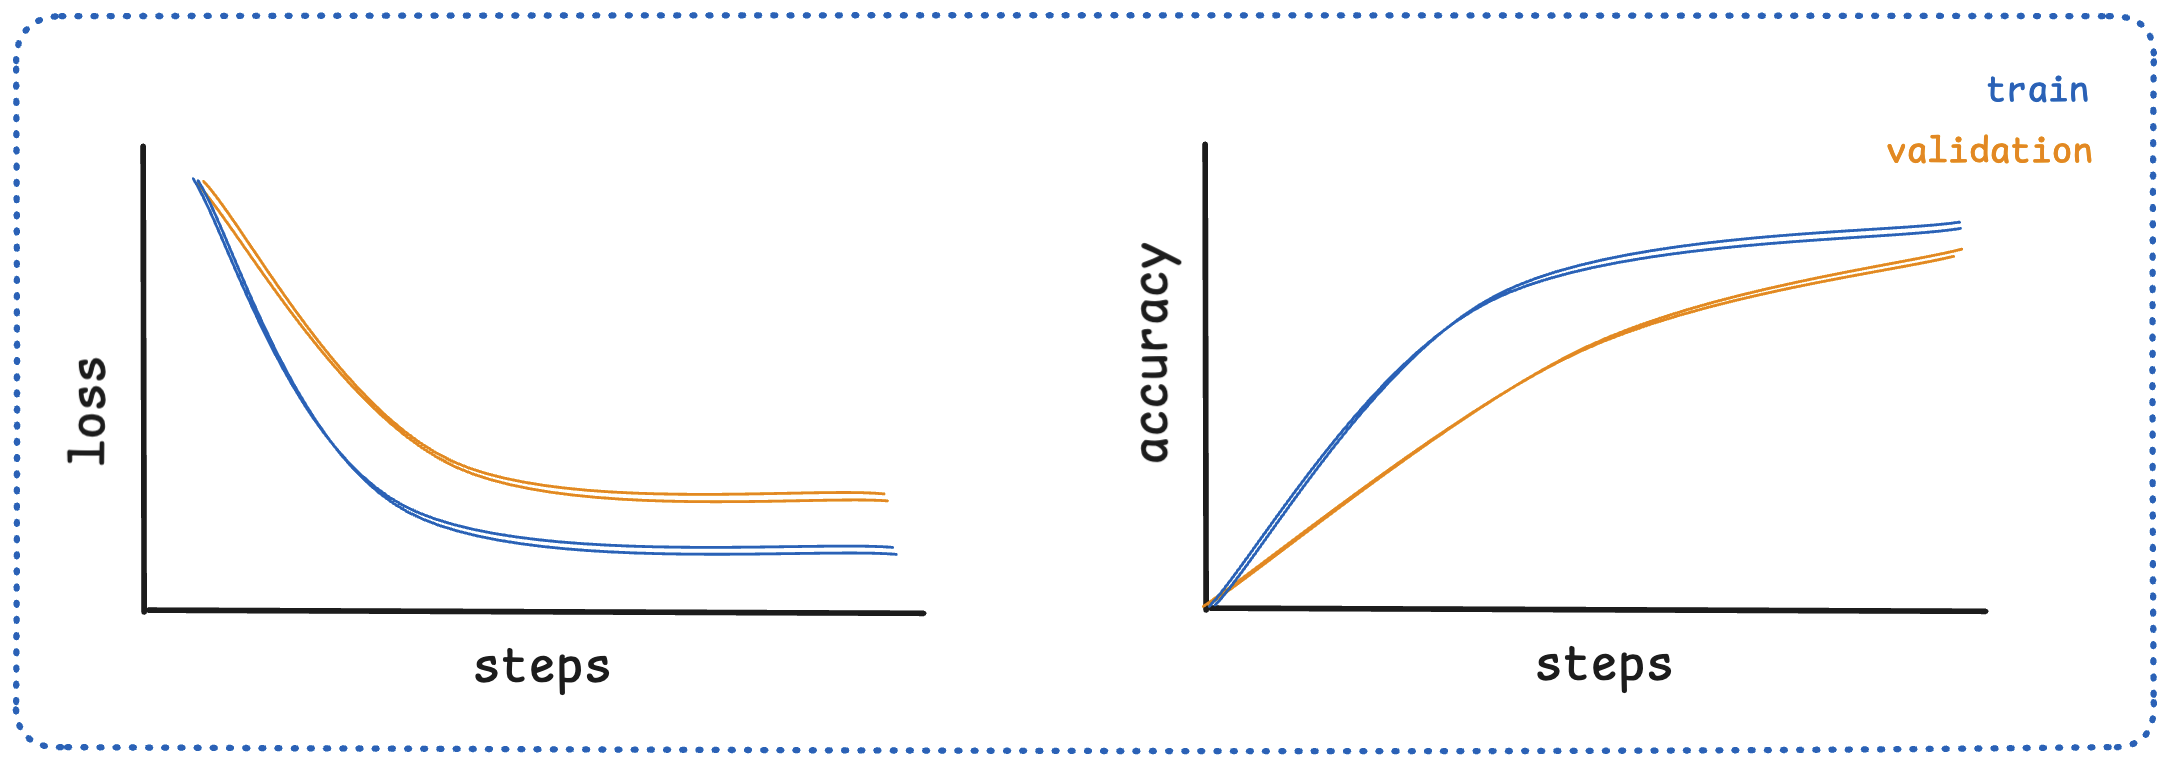
Veamos la ilustración anterior. Muestra tanto la curva de pérdida (a la izquierda) como la curva de precisión correspondiente (a la derecha). Estas curvas tienen características distintas.
La curva de pérdida muestra el valor de la pérdida del modelo a lo largo del tiempo. Inicialmente, la pérdida es alta y luego disminuye gradualmente, lo que indica que el modelo está mejorando. Una disminución en el valor de la pérdida sugiere que el modelo está haciendo mejores predicciones, ya que la pérdida representa el error entre la salida predicha y la salida verdadera.
Ahora, centrémonos en la curva de precisión. Representa la precisión del modelo a lo largo del tiempo. La curva de precisión comienza con un valor bajo y aumenta a medida que avanza el entrenamiento. La precisión mide la proporción de instancias clasificadas correctamente. Por lo tanto, a medida que la curva de precisión sube, significa que el modelo está haciendo más predicciones correctas.
Una diferencia notable entre las curvas es la suavidad y la presencia de "mesetas" en la curva de precisión. Mientras que la pérdida disminuye suavemente, las mesetas en la curva de precisión indican saltos discretos en la precisión en lugar de un aumento continuo. Este comportamiento se atribuye a cómo se mide la precisión. La pérdida puede mejorar si la salida del modelo se acerca al objetivo, incluso si la predicción final sigue siendo incorrecta. La precisión, sin embargo, solo mejora cuando la predicción cruza el umbral para ser correcta.
Por ejemplo, en un clasificador binario que distingue gatos (0) de perros (1), si el modelo predice 0.3 para una imagen de un perro (valor verdadero 1), esto se redondea a 0 y es una clasificación incorrecta. Si en el siguiente paso predice 0.4, sigue siendo incorrecto. La pérdida habrá disminuido porque 0.4 está más cerca de 1 que 0.3, pero la precisión permanece sin cambios, creando una meseta. La precisión solo saltará cuando el modelo prediga un valor mayor que 0.5 que se redondee a 1.
[!TIP] Características de las curvas saludables:
- Disminución suave de la pérdida: Tanto la pérdida de entrenamiento como la de validación disminuyen constantemente.
- Rendimiento cercano de entrenamiento/validación: Pequeña brecha entre las métricas de entrenamiento y validación.
- Convergencia: Las curvas se nivelan, indicando que el modelo ha aprendido los patrones.
Ejemplos prácticos[[practical-examples]]
Trabajemos con algunos ejemplos prácticos de curvas de aprendizaje. Primero, destacaremos algunos enfoques para monitorear las curvas de aprendizaje durante el entrenamiento. A continuación, desglosaremos los diferentes patrones que se pueden observar en las curvas de aprendizaje.
Durante el entrenamiento[[during-training]]
Durante el proceso de entrenamiento (después de que hayas presionado trainer.train()), puedes monitorear estos indicadores clave:
- Convergencia de la pérdida: ¿La pérdida sigue disminuyendo o se ha estabilizado?
- Señales de sobreajuste: ¿La pérdida de validación está empezando a aumentar mientras la pérdida de entrenamiento disminuye?
- Tasa de aprendizaje: ¿Las curvas son demasiado erráticas (tasa de aprendizaje demasiado alta) o demasiado planas (tasa de aprendizaje demasiado baja)?
- Estabilidad: ¿Hay picos o caídas repentinas que indiquen problemas?
Después del entrenamiento[[after-training]]
Una vez completado el proceso de entrenamiento, puedes analizar las curvas completas para comprender el rendimiento del modelo.
- Rendimiento final: ¿El modelo alcanzó niveles de rendimiento aceptables?
- Eficiencia: ¿Se podría lograr el mismo rendimiento con menos épocas?
- Generalización: ¿Qué tan cerca están el rendimiento de entrenamiento y validación?
- Tendencias: ¿Un entrenamiento adicional probablemente mejoraría el rendimiento?
[!TIP] 🔍 Características del panel de W&B: Weights & Biases crea automáticamente gráficos hermosos e interactivos de tus curvas de aprendizaje. Puedes:
- Comparar múltiples ejecuciones lado a lado
- Agregar métricas y visualizaciones personalizadas
- Configurar alertas para comportamientos anómalos
- Compartir resultados con tu equipo
Aprende más en la documentación de Weights & Biases.
Sobreajuste[[overfitting]]
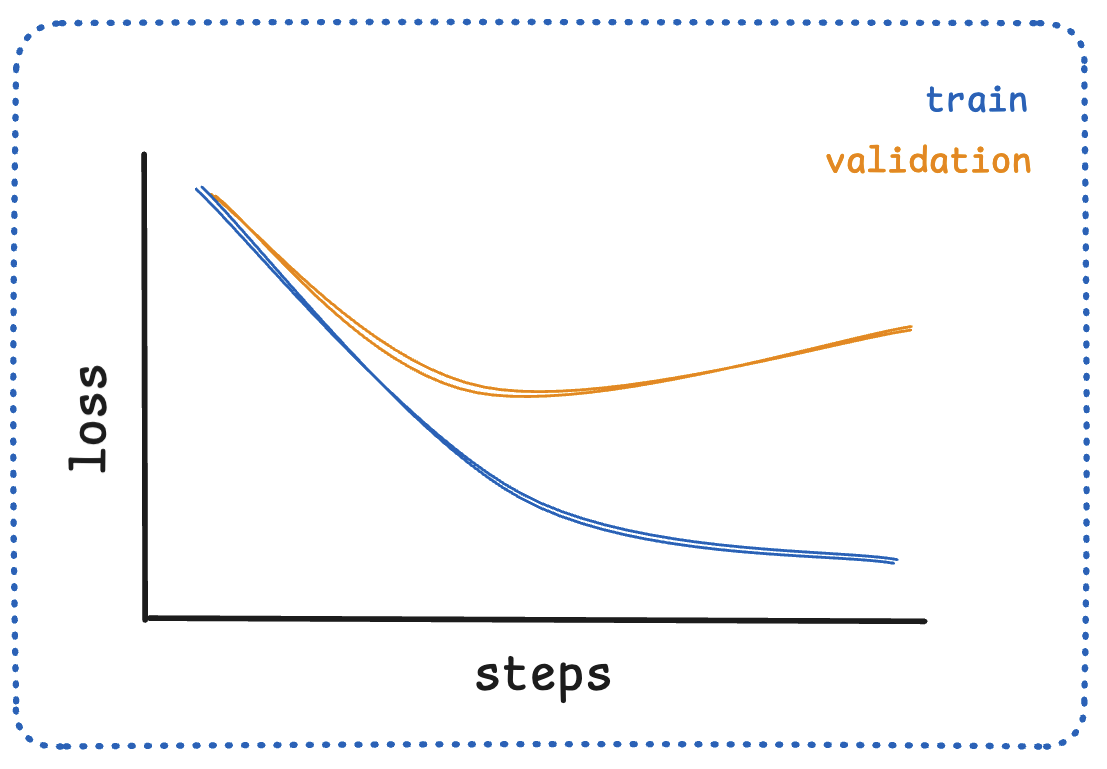
El sobreajuste ocurre cuando el modelo aprende demasiado de los datos de entrenamiento y no puede generalizar a datos diferentes (representados por el conjunto de validación).
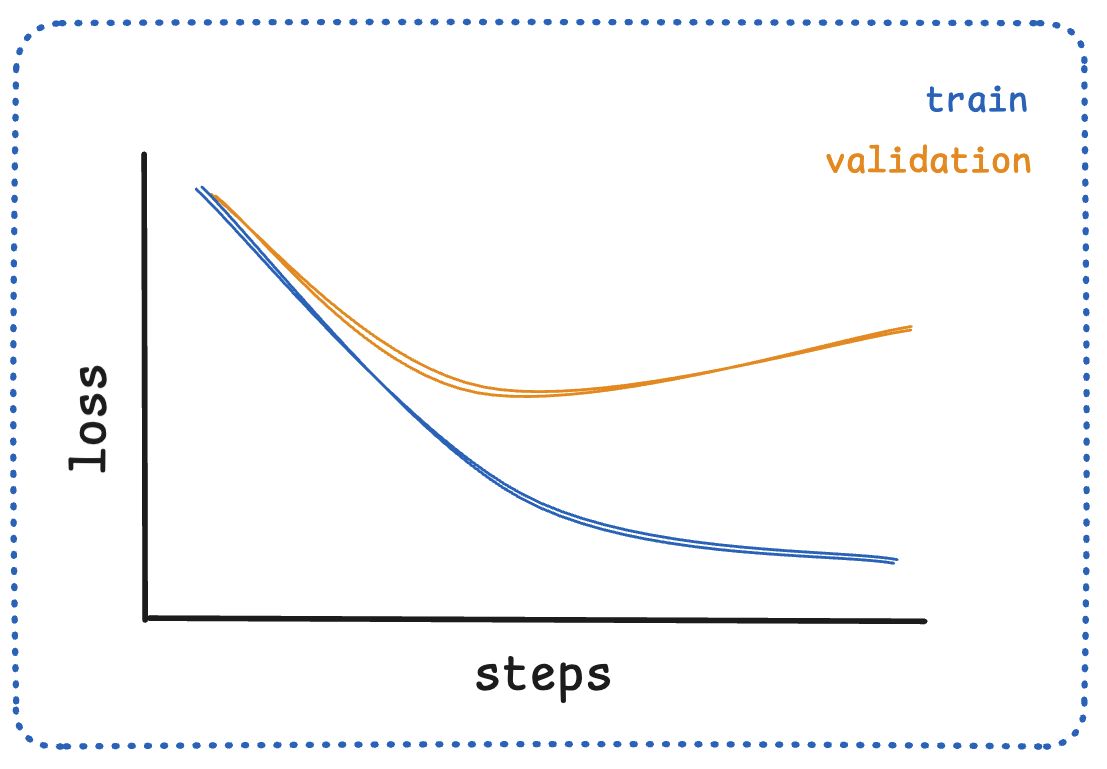
Síntomas:
- La pérdida de entrenamiento sigue disminuyendo mientras que la pérdida de validación aumenta o se estabiliza.
- Gran diferencia entre la precisión de entrenamiento y la de validación.
- La precisión de entrenamiento es mucho mayor que la precisión de validación.
Soluciones para el sobreajuste:
- Regularización: Agrega dropout, decaimiento de peso u otras técnicas de regularización.
- Parada temprana: Detén el entrenamiento cuando el rendimiento de validación deje de mejorar.
- Aumento de datos: Aumenta la diversidad de los datos de entrenamiento.
- Reduce la complejidad del modelo: Usa un modelo más pequeño o menos parámetros.
En el siguiente ejemplo, usamos la parada temprana para prevenir el sobreajuste. Establecemos el early_stopping_patience en 3, lo que significa que si la pérdida de validación no mejora durante 3 épocas consecutivas, el entrenamiento se detendrá.
# Example of detecting overfitting with early stopping
from transformers import EarlyStoppingCallback

training_args = TrainingArguments(
    output_dir="./results",
    eval_strategy="steps",
    eval_steps=100,
    save_strategy="steps",
    save_steps=100,
    load_best_model_at_end=True,
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    num_train_epochs=10,  # Set high, but we'll stop early
)

# Add early stopping to prevent overfitting
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    data_collator=data_collator,
    processing_class=tokenizer,
    compute_metrics=compute_metrics,
    callbacks=[EarlyStoppingCallback(early_stopping_patience=3)],
)
2. Subajuste[[underfitting]]
El subajuste ocurre cuando el modelo es demasiado simple para capturar los patrones subyacentes en los datos. Esto puede suceder por varias razones:
- El modelo es demasiado pequeño o carece de capacidad para aprender los patrones.
- La tasa de aprendizaje es demasiado baja, lo que provoca un aprendizaje lento.
- El conjunto de datos es demasiado pequeño o no es representativo del problema.
- El modelo no está debidamente regularizado.
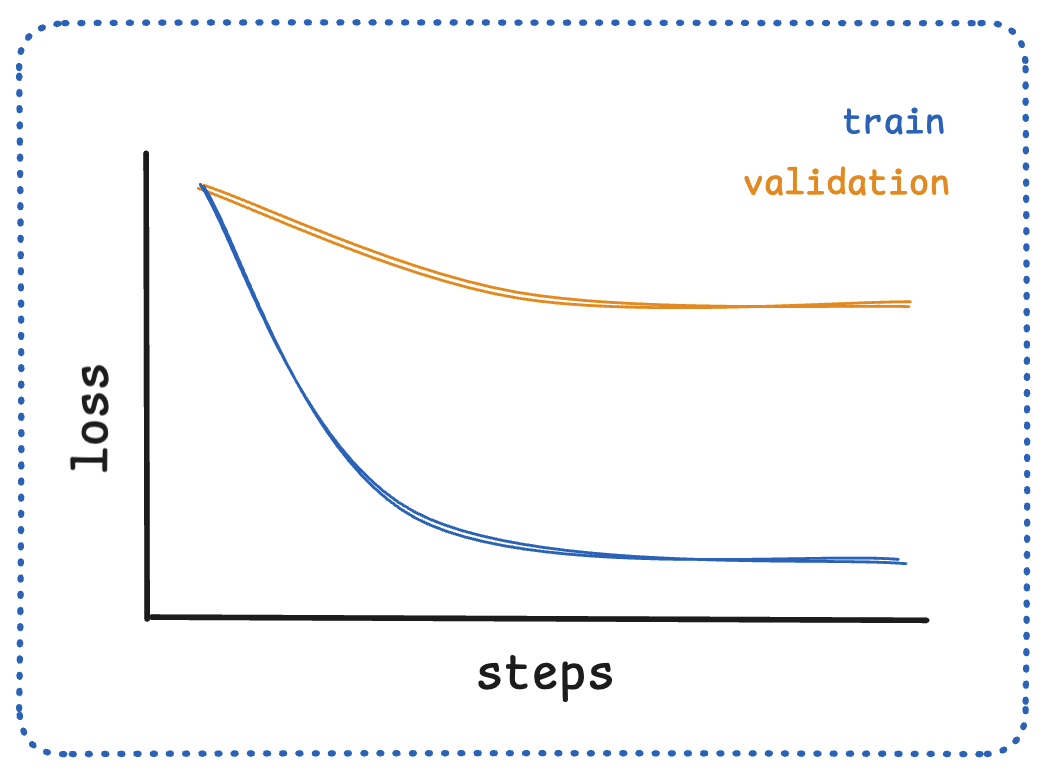
Síntomas:
- Tanto la pérdida de entrenamiento como la de validación permanecen altas.
- El rendimiento del modelo se estabiliza temprano en el entrenamiento.
- La precisión de entrenamiento es menor de lo esperado.
Soluciones para el subajuste:
- Aumenta la capacidad del modelo: Usa un modelo más grande o más parámetros.
- Entrena por más tiempo: Aumenta el número de épocas.
- Ajusta la tasa de aprendizaje: Prueba diferentes tasas de aprendizaje.
- Verifica la calidad de los datos: Asegúrate de que tus datos estén preprocesados correctamente.
En el siguiente ejemplo, entrenamos por más épocas para ver si el modelo puede aprender los patrones en los datos.
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="./results",
    -num_train_epochs=5,
    +num_train_epochs=10,
)
3. Curvas de aprendizaje erráticas[[erratic-learning-curves]]
Las curvas de aprendizaje erráticas ocurren cuando el modelo no está aprendiendo eficazmente. Esto puede suceder por varias razones:
- La tasa de aprendizaje es demasiado alta, lo que hace que el modelo sobrepase los parámetros óptimos.
- El tamaño del lote es demasiado pequeño, lo que hace que el modelo aprenda lentamente.
- El modelo no está debidamente regularizado, lo que hace que se sobreajuste a los datos de entrenamiento.
- El conjunto de datos no está debidamente preprocesado, lo que hace que el modelo aprenda del ruido.
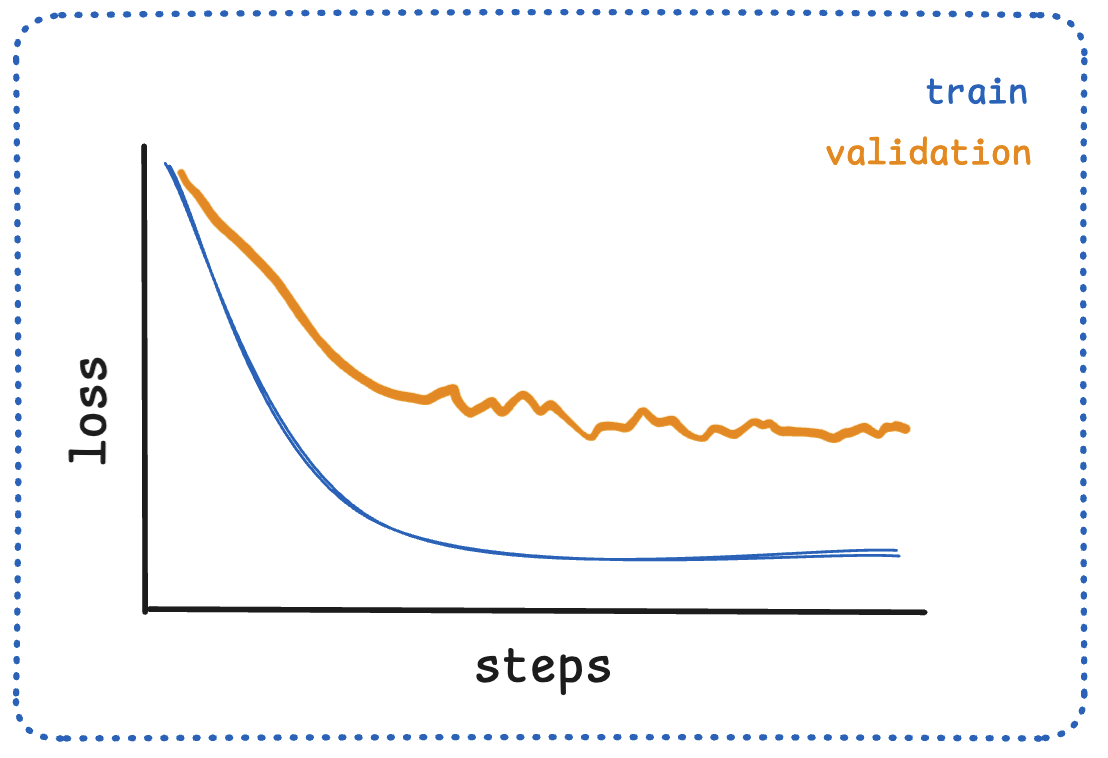
Síntomas:
- Fluctuaciones frecuentes en la pérdida o la precisión.
- Las curvas muestran alta varianza o inestabilidad.
- El rendimiento oscila sin una tendencia clara.
Tanto las curvas de entrenamiento como las de validación muestran un comportamiento errático.
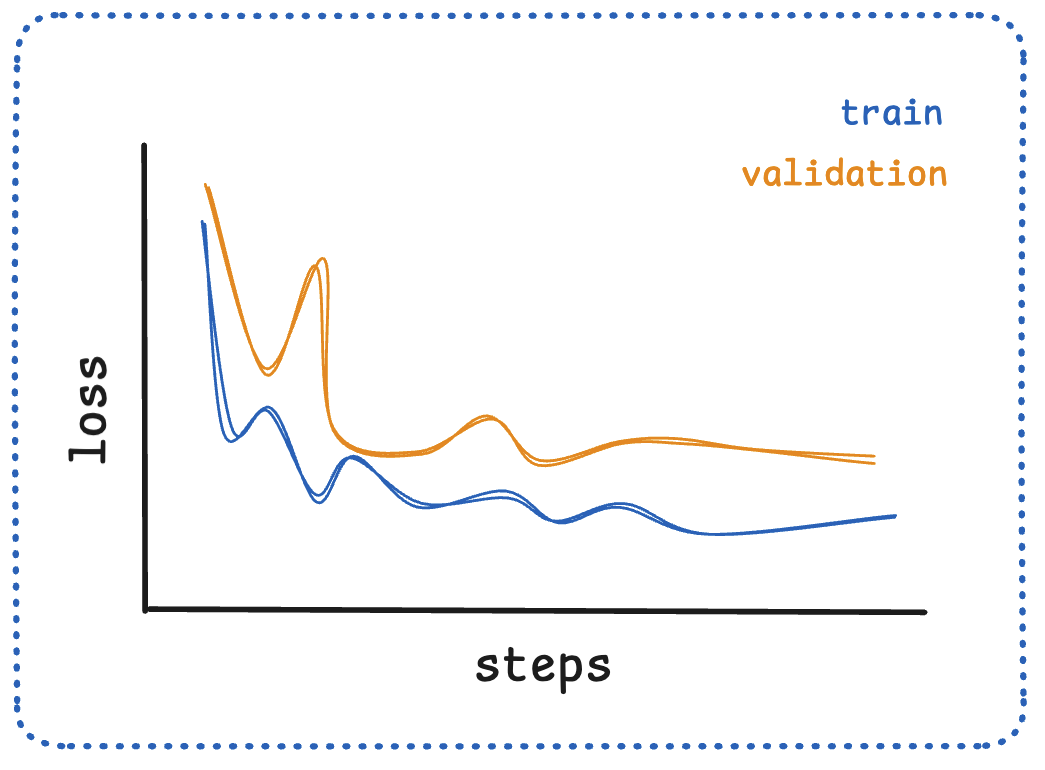
Soluciones para curvas erráticas:
- Reduce la tasa de aprendizaje: Disminuye el tamaño del paso para un entrenamiento más estable.
- Aumenta el tamaño del lote: Lotes más grandes proporcionan gradientes más estables.
- Recorte de gradientes: Previene gradientes explosivos.
- Mejor preprocesamiento de datos: Asegura una calidad de datos consistente.
En el siguiente ejemplo, reducimos la tasa de aprendizaje y aumentamos el tamaño del lote.
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="./results",
    -learning_rate=1e-5,
    +learning_rate=1e-4,
    -per_device_train_batch_size=16,
    +per_device_train_batch_size=32,
)
Puntos clave[[key-takeaways]]
Comprender las curvas de aprendizaje es crucial para convertirte en un practicante eficaz del aprendizaje automático. Estas herramientas visuales proporcionan retroalimentación inmediata sobre el progreso del entrenamiento de tu modelo y te ayudan a tomar decisiones informadas sobre cuándo detener el entrenamiento, ajustar hiperparámetros o probar diferentes enfoques. Con la práctica, desarrollarás una comprensión intuitiva de cómo se ven las curvas de aprendizaje saludables y cómo abordar los problemas cuando surgen.
[!TIP] 💡 Puntos clave:
- Las curvas de aprendizaje son herramientas esenciales para comprender el progreso del entrenamiento del modelo.
- Monitorea tanto las curvas de pérdida como las de precisión, pero recuerda que tienen características diferentes.
- El sobreajuste se muestra como un rendimiento divergente de entrenamiento/validación.
- El subajuste se muestra como un rendimiento deficiente tanto en los datos de entrenamiento como en los de validación.
- Herramientas como Weights & Biases facilitan el seguimiento y análisis de las curvas de aprendizaje.
- La parada temprana y la regularización adecuada pueden abordar la mayoría de los problemas comunes de entrenamiento.
🔬 Próximos pasos: Practica el análisis de curvas de aprendizaje en tus propios experimentos de fine-tuning. Prueba diferentes hiperparámetros y observa cómo afectan las formas de las curvas. Esta experiencia práctica es la mejor manera de desarrollar la intuición para leer el progreso del entrenamiento.
Cuestionario de la sección[[section-quiz]]
Pon a prueba tu comprensión de las curvas de aprendizaje y el análisis del entrenamiento: