Construyendo un tokenizador desde cero
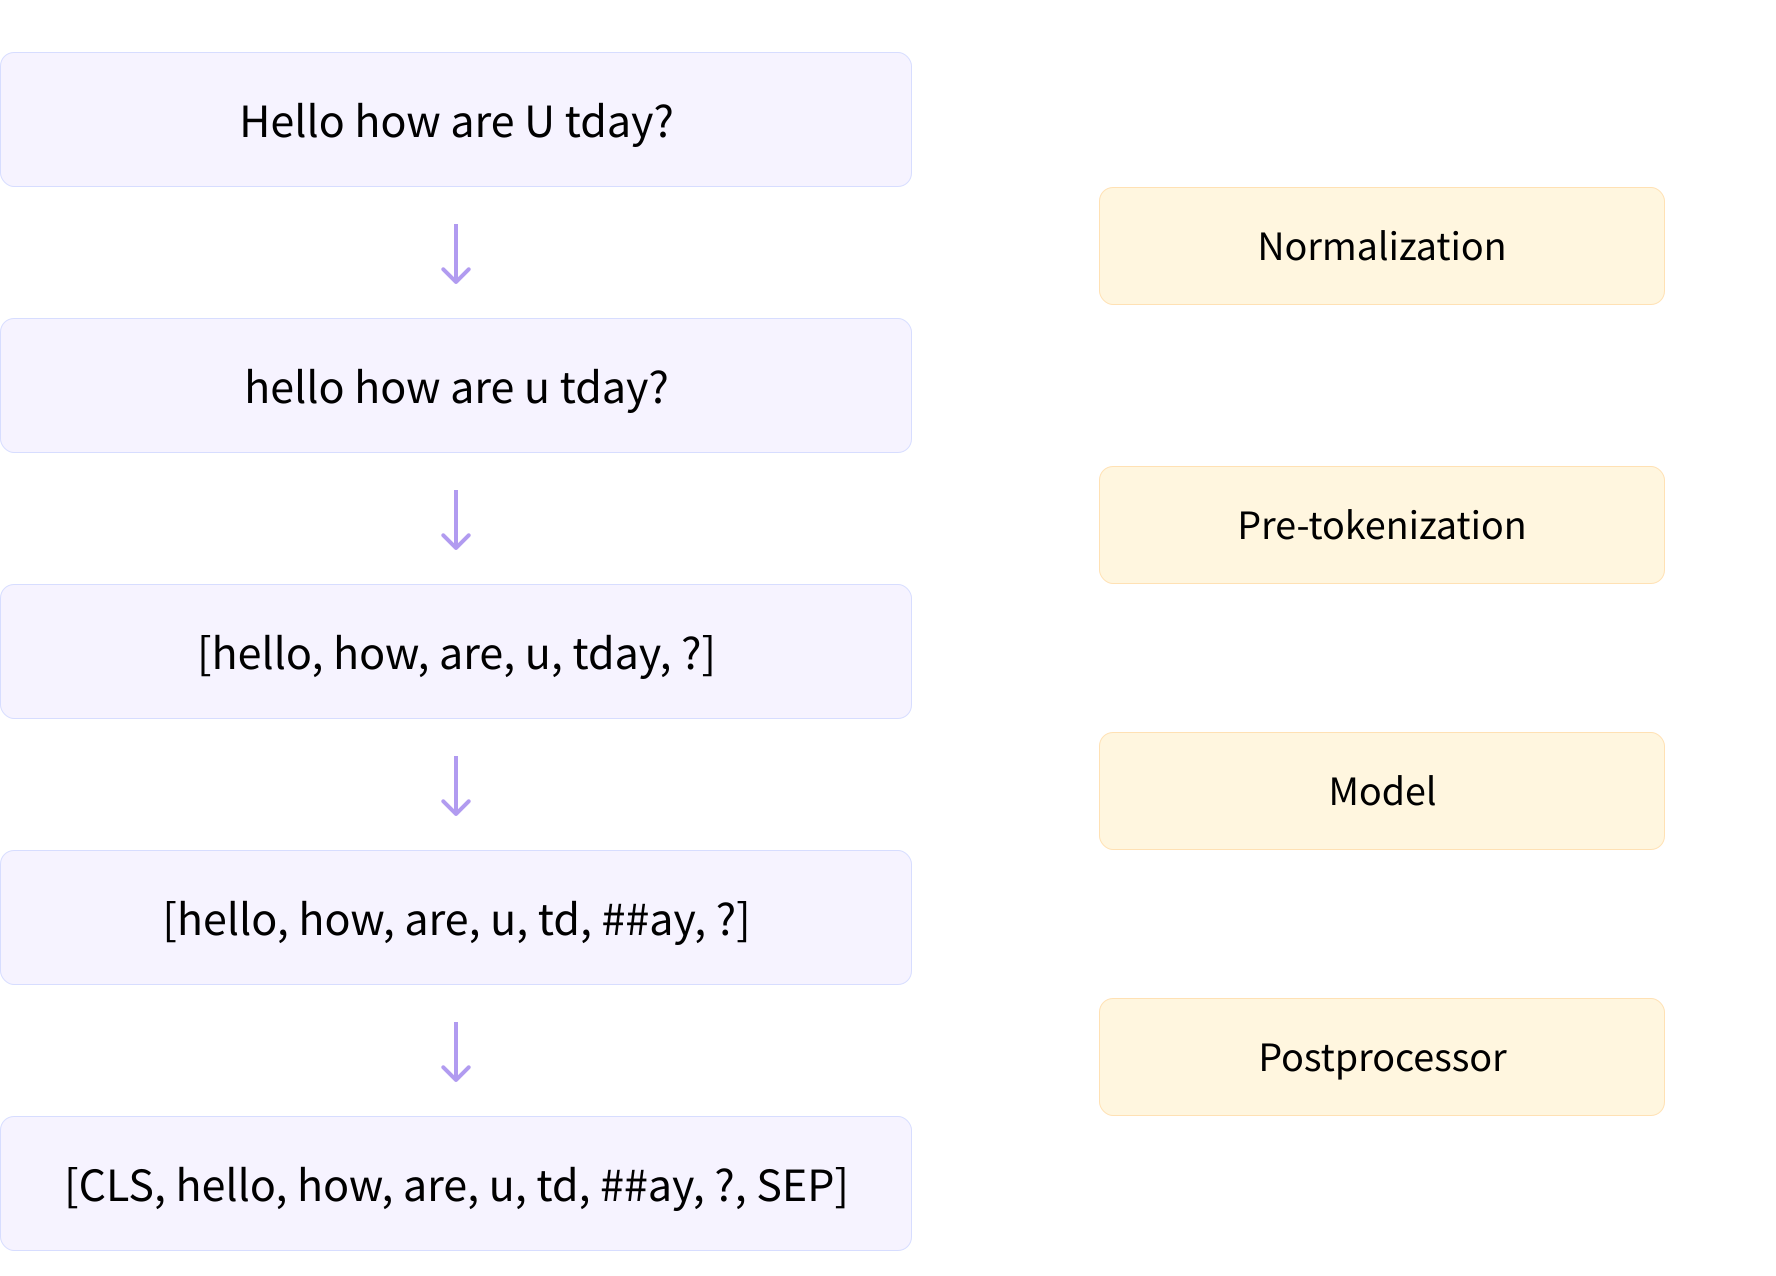
Como hemos visto en las secciones anteriores, la tokenización comprende varios pasos:
- Normalización (cualquier limpieza del texto que se considere necesaria, como eliminar espacios o acentos, normalización Unicode, etc.)
- Pre-tokenización (dividir la entrada en palabras)
- Ejecutar la entrada a través del modelo (usar las palabras pre-tokenizadas para producir una secuencia de tokens)
- Post-procesamiento (añadir los tokens especiales del tokenizador, generar la máscara de atención y los IDs de tipo de token)
Como recordatorio, aquí tienes otra vista del proceso general:
La librería 🤗 Tokenizers ha sido construida para proporcionar varias opciones para cada uno de esos pasos, que puedes mezclar y combinar. En esta sección veremos cómo podemos construir un tokenizador desde cero, a diferencia de entrenar un nuevo tokenizador a partir de uno antiguo como hicimos en la sección 2. ¡Entonces podrás construir cualquier tipo de tokenizador que se te ocurra!
Más precisamente, la librería está construida alrededor de una clase central Tokenizer con los bloques de construcción reagrupados en submódulos:
normalizerscontiene todos los tipos posibles deNormalizerque puedes usar (lista completa aquí).pre_tokenizerscontiene todos los tipos posibles dePreTokenizerque puedes usar (lista completa aquí).modelscontiene los varios tipos deModelque puedes usar, comoBPE,WordPieceyUnigram(lista completa aquí).trainerscontiene todos los diferentes tipos deTrainerque puedes usar para entrenar tu modelo en un corpus (uno por tipo de modelo; lista completa aquí).post_processorscontiene los varios tipos dePostProcessorque puedes usar (lista completa aquí).decoderscontiene los varios tipos deDecoderque puedes usar para decodificar las salidas de la tokenización (lista completa aquí).
Puedes encontrar la lista completa de bloques de construcción aquí.
Adquiriendo un corpus[[acquiring-a-corpus]]
Para entrenar nuestro nuevo tokenizador, usaremos un pequeño corpus de texto (para que los ejemplos se ejecuten rápido). Los pasos para adquirir el corpus son similares a los que tomamos al principio de este capítulo, pero esta vez usaremos el conjunto de datos WikiText-2:
from datasets import load_dataset

dataset = load_dataset("wikitext", name="wikitext-2-raw-v1", split="train")


def get_training_corpus():
    for i in range(0, len(dataset), 1000):
        yield dataset[i : i + 1000]["text"]
La función get_training_corpus() es un generador que producirá lotes de 1,000 textos, que usaremos para entrenar el tokenizador.
🤗 Tokenizers también se puede entrenar directamente en archivos de texto. Así es como podemos generar un archivo de texto que contenga todos los textos/entradas de WikiText-2 que podemos usar localmente:
with open("wikitext-2.txt", "w", encoding="utf-8") as f:
    for i in range(len(dataset)):
        f.write(dataset[i]["text"] + "\n")
A continuación te mostraremos cómo construir tus propios tokenizadores BERT, GPT-2 y XLNet, bloque por bloque. Eso nos dará un ejemplo de cada uno de los tres algoritmos principales de tokenización: WordPiece, BPE y Unigram. ¡Empecemos con BERT!
Construyendo un tokenizador WordPiece desde cero[[building-a-wordpiece-tokenizer-from-scratch]]
Para construir un tokenizador con la librería 🤗 Tokenizers, comenzamos instanciando un objeto Tokenizer con un model, luego establecemos sus atributos normalizer, pre_tokenizer, post_processor y decoder a los valores que queremos.
Para este ejemplo, crearemos un Tokenizer con un modelo WordPiece:
from tokenizers import (
    decoders,
    models,
    normalizers,
    pre_tokenizers,
    processors,
    trainers,
    Tokenizer,
)

tokenizer = Tokenizer(models.WordPiece(unk_token="[UNK]"))
Tenemos que especificar el unk_token para que el modelo sepa qué devolver cuando encuentre caracteres que no ha visto antes. Otros argumentos que podemos establecer aquí incluyen el vocab de nuestro modelo (vamos a entrenar el modelo, así que no necesitamos establecer esto) y max_input_chars_per_word, que especifica una longitud máxima para cada palabra (las palabras más largas que el valor pasado se dividirán).
El primer paso de la tokenización es la normalización, así que empecemos con eso. Dado que BERT es ampliamente utilizado, hay un BertNormalizer con las opciones clásicas que podemos establecer para BERT: lowercase y strip_accents, que son autoexplicativas; clean_text para eliminar todos los caracteres de control y reemplazar los espacios repetidos por uno solo; y handle_chinese_chars, que coloca espacios alrededor de los caracteres chinos. Para replicar el tokenizador bert-base-uncased, podemos simplemente establecer este normalizador:
tokenizer.normalizer = normalizers.BertNormalizer(lowercase=True)
En general, sin embargo, al construir un nuevo tokenizador no tendrás acceso a un normalizador tan práctico ya implementado en la librería 🤗 Tokenizers, así que veamos cómo crear el normalizador BERT a mano. La librería proporciona un normalizador Lowercase y un normalizador StripAccents, y puedes componer varios normalizadores usando un Sequence:
tokenizer.normalizer = normalizers.Sequence(
    [normalizers.NFD(), normalizers.Lowercase(), normalizers.StripAccents()]
)
También estamos usando un normalizador Unicode NFD, ya que de lo contrario el normalizador StripAccents no reconocerá correctamente los caracteres acentuados y, por lo tanto, no los eliminará.
Como hemos visto antes, podemos usar el método normalize_str() del normalizer para ver los efectos que tiene en un texto dado:
print(tokenizer.normalizer.normalize_str("Héllò hôw are ü?"))
hello how are u?
[!TIP] Para ir más allá Si pruebas las dos versiones de los normalizadores anteriores en una cadena que contenga el carácter unicode
u"\u0085", seguramente notarás que estos dos normalizadores no son exactamente equivalentes. Para no complicar demasiado la versión connormalizers.Sequence, no hemos incluido los reemplazos de Regex que elBertNormalizerrequiere cuando el argumentoclean_textse establece enTrue, que es el comportamiento predeterminado. Pero no te preocupes: es posible obtener exactamente la misma normalización sin usar el prácticoBertNormalizerañadiendo dosnormalizers.Replacea la secuencia de normalizadores.
El siguiente paso es la pre-tokenización. De nuevo, hay un BertPreTokenizer preconstruido que podemos usar:
tokenizer.pre_tokenizer = pre_tokenizers.BertPreTokenizer()
O podemos construirlo desde cero:
tokenizer.pre_tokenizer = pre_tokenizers.Whitespace()
Ten en cuenta que el pre-tokenizador Whitespace divide por espacios en blanco y todos los caracteres que no son letras, dígitos o el carácter de subrayado, por lo que técnicamente divide por espacios en blanco y puntuación:
tokenizer.pre_tokenizer.pre_tokenize_str("Let's test my pre-tokenizer.")
[('Let', (0, 3)), ("'", (3, 4)), ('s', (4, 5)), ('test', (6, 10)), ('my', (11, 13)), ('pre', (14, 17)),
 ('-', (17, 18)), ('tokenizer', (18, 27)), ('.', (27, 28))]
Si solo quieres dividir por espacios en blanco, debes usar el pre-tokenizador WhitespaceSplit en su lugar:
pre_tokenizer = pre_tokenizers.WhitespaceSplit()
pre_tokenizer.pre_tokenize_str("Let's test my pre-tokenizer.")
[("Let's", (0, 5)), ('test', (6, 10)), ('my', (11, 13)), ('pre-tokenizer.', (14, 28))]
Al igual que con los normalizadores, puedes usar un Sequence para componer varios pre-tokenizadores:
pre_tokenizer = pre_tokenizers.Sequence(
    [pre_tokenizers.WhitespaceSplit(), pre_tokenizers.Punctuation()]
)
pre_tokenizer.pre_tokenize_str("Let's test my pre-tokenizer.")
[('Let', (0, 3)), ("'", (3, 4)), ('s', (4, 5)), ('test', (6, 10)), ('my', (11, 13)), ('pre', (14, 17)),
 ('-', (17, 18)), ('tokenizer', (18, 27)), ('.', (27, 28))]
El siguiente paso en la pipeline de tokenización es ejecutar las entradas a través del modelo. Ya especificamos nuestro modelo en la inicialización, pero aún necesitamos entrenarlo, lo que requerirá un WordPieceTrainer. Lo principal a recordar al instanciar un entrenador en 🤗 Tokenizers es que debes pasarle todos los tokens especiales que pretendes usar; de lo contrario, no los agregará al vocabulario, ya que no están en el corpus de entrenamiento:
special_tokens = ["[UNK]", "[PAD]", "[CLS]", "[SEP]", "[MASK]"]
trainer = trainers.WordPieceTrainer(vocab_size=25000, special_tokens=special_tokens)
Además de especificar el vocab_size y el special_tokens, podemos establecer el min_frequency (el número de veces que debe aparecer un token para ser incluido en el vocabulario) o cambiar el continuing_subword_prefix (si queremos usar algo diferente de ##).
Para entrenar nuestro modelo usando el iterador que definimos anteriormente, solo tenemos que ejecutar este comando:
tokenizer.train_from_iterator(get_training_corpus(), trainer=trainer)
También podemos usar archivos de texto para entrenar nuestro tokenizador, lo que se vería así (reinicializamos el modelo con un WordPiece vacío de antemano):
tokenizer.model = models.WordPiece(unk_token="[UNK]")
tokenizer.train(["wikitext-2.txt"], trainer=trainer)
En ambos casos, podemos probar el tokenizador en un texto llamando al método encode():
encoding = tokenizer.encode("Let's test this tokenizer.")
print(encoding.tokens)
['let', "'", 's', 'test', 'this', 'tok', '##eni', '##zer', '.']
El encoding obtenido es un Encoding, que contiene todas las salidas necesarias del tokenizador en sus varios atributos: ids, type_ids, tokens, offsets, attention_mask, special_tokens_mask y overflowing.
El último paso en la pipeline de tokenización es el post-procesamiento. Necesitamos añadir el token [CLS] al principio y el token [SEP] al final (o después de cada oración, si tenemos un par de oraciones). Usaremos un TemplateProcessor para esto, pero primero necesitamos saber los IDs de los tokens [CLS] y [SEP] en el vocabulario:
cls_token_id = tokenizer.token_to_id("[CLS]")
sep_token_id = tokenizer.token_to_id("[SEP]")
print(cls_token_id, sep_token_id)
(2, 3)
Para escribir la plantilla para el TemplateProcessor, tenemos que especificar cómo tratar una sola oración y un par de oraciones. Para ambos, escribimos los tokens especiales que queremos usar; la primera (o única) oración está representada por $A, mientras que la segunda oración (si se codifica un par) está representada por $B. Para cada uno de estos (tokens especiales y oraciones), también especificamos el ID de tipo de token correspondiente después de dos puntos.
La plantilla clásica de BERT se define así:
tokenizer.post_processor = processors.TemplateProcessing(
    single=f"[CLS]:0 $A:0 [SEP]:0",
    pair=f"[CLS]:0 $A:0 [SEP]:0 $B:1 [SEP]:1",
    special_tokens=[("[CLS]", cls_token_id), ("[SEP]", sep_token_id)],
)
Ten en cuenta que necesitamos pasar los IDs de los tokens especiales, para que el tokenizador pueda convertirlos correctamente a sus IDs.
Una vez añadido esto, volviendo a nuestro ejemplo anterior obtendremos:
encoding = tokenizer.encode("Let's test this tokenizer.")
print(encoding.tokens)
['[CLS]', 'let', "'", 's', 'test', 'this', 'tok', '##eni', '##zer', '.', '[SEP]']
Y en un par de oraciones, obtenemos el resultado correcto:
encoding = tokenizer.encode("Let's test this tokenizer...", "on a pair of sentences.")
print(encoding.tokens)
print(encoding.type_ids)
['[CLS]', 'let', "'", 's', 'test', 'this', 'tok', '##eni', '##zer', '...', '[SEP]', 'on', 'a', 'pair', 'of', 'sentences', '.', '[SEP]']
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1]
Casi hemos terminado de construir este tokenizador desde cero; el último paso es incluir un decodificador:
tokenizer.decoder = decoders.WordPiece(prefix="##")
Probémoslo en nuestro encoding anterior:
tokenizer.decode(encoding.ids)
"let's test this tokenizer... on a pair of sentences."
¡Genial! Podemos guardar nuestro tokenizador en un solo archivo JSON así:
tokenizer.save("tokenizer.json")
Luego podemos recargar ese archivo en un objeto Tokenizer con el método from_file():
new_tokenizer = Tokenizer.from_file("tokenizer.json")
Para usar este tokenizador en 🤗 Transformers, tenemos que envolverlo en un PreTrainedTokenizerFast. Podemos usar la clase genérica o, si nuestro tokenizador corresponde a un modelo existente, usar esa clase (aquí, BertTokenizerFast). Si aplicas esta lección para construir un tokenizador completamente nuevo, tendrás que usar la primera opción.
Para envolver el tokenizador en un PreTrainedTokenizerFast, podemos pasar el tokenizador que construimos como tokenizer_object o pasar el archivo del tokenizador que guardamos como tokenizer_file. Lo clave a recordar es que tenemos que establecer manualmente todos los tokens especiales, ya que esa clase no puede inferir del objeto tokenizer qué token es el token de máscara, el token [CLS], etc.:
from transformers import PreTrainedTokenizerFast

wrapped_tokenizer = PreTrainedTokenizerFast(
    tokenizer_object=tokenizer,
    # tokenizer_file="tokenizer.json", # You can load from the tokenizer file, alternatively
    unk_token="[UNK]",
    pad_token="[PAD]",
    cls_token="[CLS]",
    sep_token="[SEP]",
    mask_token="[MASK]",
)
Si estás usando una clase de tokenizador específica (como BertTokenizerFast), solo necesitarás especificar los tokens especiales que son diferentes de los predeterminados (aquí, ninguno):
from transformers import BertTokenizerFast

wrapped_tokenizer = BertTokenizerFast(tokenizer_object=tokenizer)
Luego puedes usar este tokenizador como cualquier otro tokenizador de 🤗 Transformers. Puedes guardarlo con el método save_pretrained(), o subirlo al Hub con el método push_to_hub().
Ahora que hemos visto cómo construir un tokenizador WordPiece, hagamos lo mismo para un tokenizador BPE. Iremos un poco más rápido ya que conoces todos los pasos, y solo destacaremos las diferencias.
Construyendo un tokenizador BPE desde cero[[building-a-bpe-tokenizer-from-scratch]]
Ahora construyamos un tokenizador GPT-2. Al igual que para el tokenizador BERT, comenzamos inicializando un Tokenizer con un modelo BPE:
tokenizer = Tokenizer(models.BPE())
También como para BERT, podríamos inicializar este modelo con un vocabulario si tuviéramos uno (necesitaríamos pasar el vocab y el merges en este caso), pero como entrenaremos desde cero, no necesitamos hacerlo. Tampoco necesitamos especificar un unk_token porque GPT-2 usa BPE a nivel de byte, lo que no lo requiere.
GPT-2 no usa un normalizador, así que saltamos ese paso y vamos directamente a la pre-tokenización:
tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)
La opción que añadimos a ByteLevel aquí es no añadir un espacio al principio de una oración (que es el valor predeterminado de lo contrario). Podemos echar un vistazo a la pre-tokenización de un texto de ejemplo como antes:
tokenizer.pre_tokenizer.pre_tokenize_str("Let's test pre-tokenization!")
[('Let', (0, 3)), ("'s", (3, 5)), ('Ġtest', (5, 10)), ('Ġpre', (10, 14)), ('-', (14, 15)),
 ('tokenization', (15, 27)), ('!', (27, 28))]
El siguiente paso es el modelo, que necesita entrenamiento. Para GPT-2, el único token especial es el token de fin de texto:
trainer = trainers.BpeTrainer(vocab_size=25000, special_tokens=["<|endoftext|>"])
tokenizer.train_from_iterator(get_training_corpus(), trainer=trainer)
Al igual que con el WordPieceTrainer, así como el vocab_size y el special_tokens, podemos especificar el min_frequency si queremos, o si tenemos un sufijo de fin de palabra (como </w>), podemos establecerlo con end_of_word_suffix.
Este tokenizador también se puede entrenar en archivos de texto:
tokenizer.model = models.BPE()
tokenizer.train(["wikitext-2.txt"], trainer=trainer)
Echemos un vistazo a la tokenización de un texto de muestra:
encoding = tokenizer.encode("Let's test this tokenizer.")
print(encoding.tokens)
['L', 'et', "'", 's', 'Ġtest', 'Ġthis', 'Ġto', 'ken', 'izer', '.']
Aplicamos el post-procesamiento a nivel de byte para el tokenizador GPT-2 de la siguiente manera:
tokenizer.post_processor = processors.ByteLevel(trim_offsets=False)
La opción trim_offsets = False indica al post-procesador que debemos dejar los offsets de los tokens que comienzan con 'Ġ' tal como están: de esta manera el inicio de los offsets apuntará al espacio antes de la palabra, no al primer carácter de la palabra (ya que el espacio es técnicamente parte del token). Echemos un vistazo al resultado con el texto que acabamos de codificar, donde 'Ġtest' es el token en el índice 4:
sentence = "Let's test this tokenizer."
encoding = tokenizer.encode(sentence)
start, end = encoding.offsets[4]
sentence[start:end]
' test'
Finalmente, añadimos un decodificador a nivel de byte:
tokenizer.decoder = decoders.ByteLevel()
y podemos verificar que funciona correctamente:
tokenizer.decode(encoding.ids)
"Let's test this tokenizer."
¡Genial! Ahora que hemos terminado, podemos guardar el tokenizador como antes y envolverlo en un PreTrainedTokenizerFast o GPT2TokenizerFast si queremos usarlo en 🤗 Transformers:
from transformers import PreTrainedTokenizerFast

wrapped_tokenizer = PreTrainedTokenizerFast(
    tokenizer_object=tokenizer,
    bos_token="<|endoftext|>",
    eos_token="<|endoftext|>",
)
o:
from transformers import GPT2TokenizerFast

wrapped_tokenizer = GPT2TokenizerFast(tokenizer_object=tokenizer)
Como último ejemplo, te mostraremos cómo construir un tokenizador Unigram desde cero.
Construyendo un tokenizador Unigram desde cero[[building-a-unigram-tokenizer-from-scratch]]
Ahora construyamos un tokenizador XLNet. Al igual que para los tokenizadores anteriores, comenzamos inicializando un Tokenizer con un modelo Unigram:
tokenizer = Tokenizer(models.Unigram())
De nuevo, podríamos inicializar este modelo con un vocabulario si tuviéramos uno.
Para la normalización, XLNet usa algunos reemplazos (que provienen de SentencePiece):
from tokenizers import Regex

tokenizer.normalizer = normalizers.Sequence(
    [
        normalizers.Replace("``", '"'),
        normalizers.Replace("''", '"'),
        normalizers.NFKD(),
        normalizers.StripAccents(),
        normalizers.Replace(Regex(" {2,}"), " "),
    ]
)
Esto reemplaza `` y '' con " y cualquier secuencia de dos o más espacios con un solo espacio, además de eliminar los acentos en los textos a tokenizar.
El pre-tokenizador a usar para cualquier tokenizador SentencePiece es Metaspace:
tokenizer.pre_tokenizer = pre_tokenizers.Metaspace()
Podemos echar un vistazo a la pre-tokenización de un texto de ejemplo como antes:
tokenizer.pre_tokenizer.pre_tokenize_str("Let's test the pre-tokenizer!")
[("▁Let's", (0, 5)), ('▁test', (5, 10)), ('▁the', (10, 14)), ('▁pre-tokenizer!', (14, 29))]
El siguiente paso es el modelo, que necesita entrenamiento. XLNet tiene bastantes tokens especiales:
special_tokens = ["<cls>", "<sep>", "<unk>", "<pad>", "<mask>", "<s>", "</s>"]
trainer = trainers.UnigramTrainer(
    vocab_size=25000, special_tokens=special_tokens, unk_token="<unk>"
)
tokenizer.train_from_iterator(get_training_corpus(), trainer=trainer)
Un argumento muy importante que no hay que olvidar para el UnigramTrainer es el unk_token. También podemos pasar otros argumentos específicos del algoritmo Unigram, como el shrinking_factor para cada paso donde eliminamos tokens (por defecto 0.75) o el max_piece_length para especificar la longitud máxima de un token dado (por defecto 16).
Este tokenizador también se puede entrenar en archivos de texto:
tokenizer.model = models.Unigram()
tokenizer.train(["wikitext-2.txt"], trainer=trainer)
Echemos un vistazo a la tokenización de un texto de muestra:
encoding = tokenizer.encode("Let's test this tokenizer.")
print(encoding.tokens)
['▁Let', "'", 's', '▁test', '▁this', '▁to', 'ken', 'izer', '.']
Una peculiaridad de XLNet es que coloca el token <cls> al final de la oración, con un ID de tipo 2 (para distinguirlo de los otros tokens). Como resultado, el relleno se hace a la izquierda. Podemos manejar todos los tokens especiales y los IDs de tipo de token con una plantilla, como para BERT, pero primero tenemos que obtener los IDs de los tokens <cls> y <sep>:
cls_token_id = tokenizer.token_to_id("<cls>")
sep_token_id = tokenizer.token_to_id("<sep>")
print(cls_token_id, sep_token_id)
0 1
La plantilla se ve así:
tokenizer.post_processor = processors.TemplateProcessing(
    single="$A:0 <sep>:0 <cls>:2",
    pair="$A:0 <sep>:0 $B:1 <sep>:1 <cls>:2",
    special_tokens=[("<sep>", sep_token_id), ("<cls>", cls_token_id)],
)
Y podemos probar que funciona codificando un par de oraciones:
encoding = tokenizer.encode("Let's test this tokenizer...", "on a pair of sentences!")
print(encoding.tokens)
print(encoding.type_ids)
['▁Let', "'", 's', '▁test', '▁this', '▁to', 'ken', 'izer', '.', '.', '.', '<sep>', '▁', 'on', '▁', 'a', '▁pair',
  '▁of', '▁sentence', 's', '!', '<sep>', '<cls>']
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2]
Finalmente, añadimos un decodificador Metaspace:
tokenizer.decoder = decoders.Metaspace()
¡y hemos terminado con este tokenizador! Podemos guardar el tokenizador como antes, y envolverlo en un PreTrainedTokenizerFast o XLNetTokenizerFast si queremos usarlo en 🤗 Transformers. Una cosa a tener en cuenta al usar PreTrainedTokenizerFast es que, además de los tokens especiales, necesitamos decirle a la librería 🤗 Transformers que rellene a la izquierda:
from transformers import PreTrainedTokenizerFast

wrapped_tokenizer = PreTrainedTokenizerFast(
    tokenizer_object=tokenizer,
    bos_token="<s>",
    eos_token="</s>",
    unk_token="<unk>",
    pad_token="<pad>",
    cls_token="<cls>",
    sep_token="<sep>",
    mask_token="<mask>",
    padding_side="left",
)
O alternativamente:
from transformers import XLNetTokenizerFast

wrapped_tokenizer = XLNetTokenizerFast(tokenizer_object=tokenizer)
Ahora que has visto cómo se utilizan los diversos bloques de construcción para crear tokenizadores existentes, deberías poder escribir cualquier tokenizador que desees con la librería 🤗 Tokenizers y poder usarlo en 🤗 Transformers.