¡Bienvenido al Curso 🤗!
¡Bienvenido al Curso 🤗![[welcome-to-the-course]]
Este curso te enseñará sobre modelos de lenguaje grandes (LLMs) y procesamiento de lenguaje natural (NLP) usando bibliotecas del ecosistema de Hugging Face — 🤗 Transformers, 🤗 Datasets, 🤗 Tokenizers y 🤗 Accelerate — así como el Hugging Face Hub.
También cubriremos bibliotecas fuera del ecosistema de Hugging Face. Estas son contribuciones asombrosas a la comunidad de IA y herramientas increíblemente útiles.
Es completamente gratis y sin anuncios.
Entendiendo NLP y LLMs[[understanding-nlp-and-llms]]
Aunque este curso se centró originalmente en NLP (Procesamiento de Lenguaje Natural), ha evolucionado para enfatizar los Modelos de Lenguaje Grandes (LLMs), que representan el último avance en el campo.
¿Cuál es la diferencia?
- NLP (Procesamiento de Lenguaje Natural) es el campo más amplio enfocado en permitir que las computadoras entiendan, interpreten y generen lenguaje humano. NLP abarca muchas técnicas y tareas como el análisis de sentimientos, el reconocimiento de entidades nombradas y la traducción automática.
- LLMs (Modelos de Lenguaje Grandes) son un subconjunto potente de modelos de NLP caracterizados por su tamaño masivo, extensos datos de entrenamiento y capacidad para realizar una amplia gama de tareas de lenguaje con un entrenamiento mínimo específico para la tarea. Modelos como las series Llama, GPT o Claude son ejemplos de LLMs que han revolucionado lo que es posible en NLP.
A lo largo de este curso, aprenderás tanto sobre conceptos tradicionales de NLP como sobre técnicas de LLM de vanguardia, ya que comprender los fundamentos de NLP es crucial para trabajar eficazmente con LLMs.
¿Qué esperar?[[what-to-expect]]
Aquí tienes un breve resumen del curso:
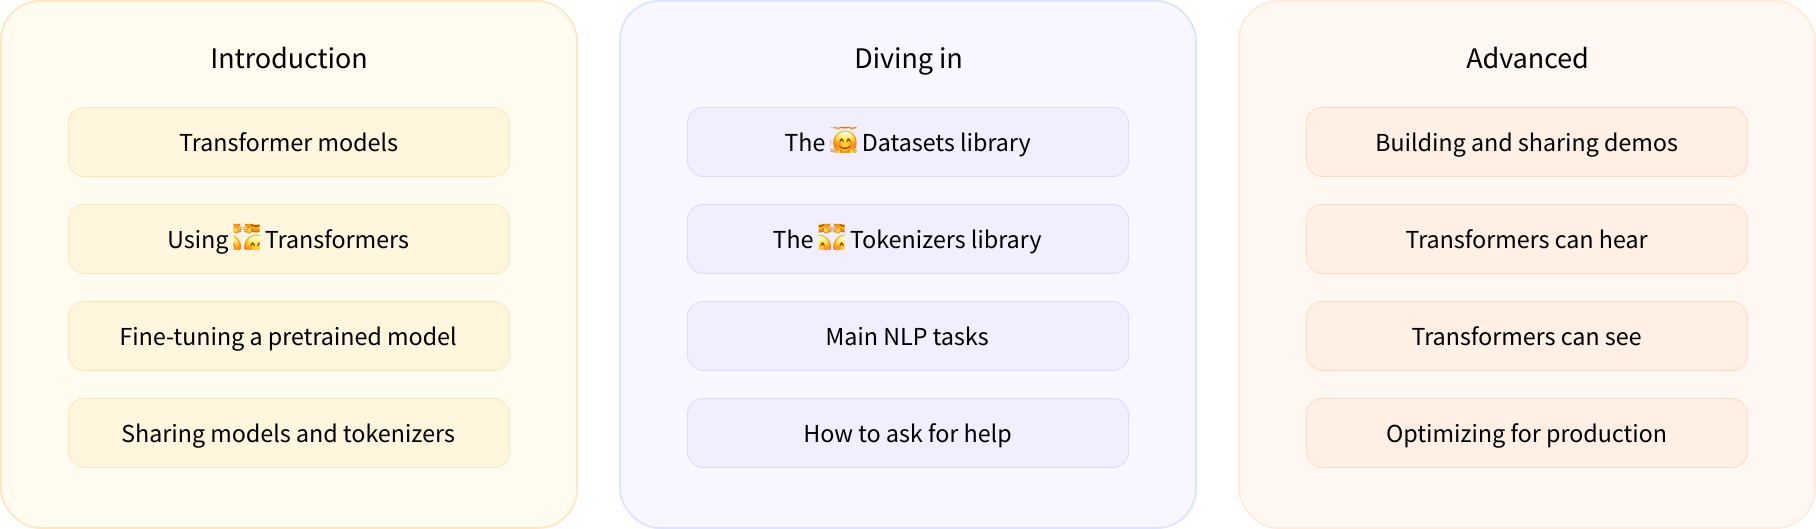
- Los capítulos 1 a 4 ofrecen una introducción a los conceptos principales de la biblioteca 🤗 Transformers. Al final de esta parte del curso, estarás familiarizado con el funcionamiento de los modelos Transformer y sabrás cómo usar un modelo del Hugging Face Hub, ajustarlo en un dataset y compartir tus resultados en el Hub.
- Los capítulos 5 a 8 enseñan los conceptos básicos de 🤗 Datasets y 🤗 Tokenizers antes de sumergirse en tareas clásicas de NLP y técnicas de LLM. Al final de esta parte, podrás abordar por tu cuenta los desafíos más comunes del procesamiento de lenguaje.
- El capítulo 9 va más allá de NLP para cubrir cómo construir y compartir demostraciones de tus modelos en el 🤗 Hub. Al final de esta parte, estarás listo para mostrar tu aplicación 🤗 Transformers al mundo.
- Los capítulos 10 a 12 profundizan en temas avanzados de LLM como el fine-tuning, la curación de datasets de alta calidad y la construcción de modelos de razonamiento.
Este curso:
- Requiere un buen conocimiento de Python
- Es mejor tomarlo después de un curso introductorio de deep learning, como fast.ai's Practical Deep Learning for Coders o uno de los programas desarrollados por DeepLearning.AI
- No espera conocimientos previos de PyTorch o TensorFlow, aunque cierta familiaridad con cualquiera de ellos te ayudará
Después de completar este curso, te recomendamos revisar la Especialización en Procesamiento de Lenguaje Natural de DeepLearning.AI, que cubre una amplia gama de modelos tradicionales de NLP como naive Bayes y LSTMs que vale la pena conocer.
¿Quiénes somos?[[who-are-we]]
Sobre los autores:
Abubakar Abid completó su doctorado en Stanford en machine learning aplicado. Durante su doctorado, fundó Gradio, una biblioteca de Python de código abierto que se ha utilizado para construir más de 600,000 demostraciones de machine learning. Gradio fue adquirida por Hugging Face, donde Abubakar ahora se desempeña como líder del equipo de machine learning.
Ben Burtenshaw es Ingeniero de Machine Learning en Hugging Face. Completó su doctorado en Procesamiento de Lenguaje Natural en la Universidad de Amberes, donde aplicó modelos Transformer para generar historias infantiles con el propósito de mejorar las habilidades de alfabetización. Desde entonces, se ha centrado en materiales y herramientas educativas para la comunidad en general.
Matthew Carrigan es Ingeniero de Machine Learning en Hugging Face. Vive en Dublín, Irlanda y anteriormente trabajó como ingeniero de ML en Parse.ly y antes de eso como investigador postdoctoral en el Trinity College Dublin. No cree que llegaremos a la AGI escalando arquitecturas existentes, pero tiene grandes esperanzas en la inmortalidad robótica de todos modos.
Lysandre Debut es Ingeniero de Machine Learning en Hugging Face y ha estado trabajando en la biblioteca 🤗 Transformers desde las primeras etapas de desarrollo. Su objetivo es hacer que NLP sea accesible para todos desarrollando herramientas con una API muy simple.
Sylvain Gugger es Ingeniero de Investigación en Hugging Face y uno de los principales mantenedores de la biblioteca 🤗 Transformers. Anteriormente fue Científico de Investigación en fast.ai, y coescribió Deep Learning for Coders with fastai and PyTorch con Jeremy Howard. El enfoque principal de su investigación es hacer que el deep learning sea más accesible, diseñando y mejorando técnicas que permiten que los modelos se entrenen rápidamente con recursos limitados.
Dawood Khan es Ingeniero de Machine Learning en Hugging Face. Es de Nueva York y se graduó de la Universidad de Nueva York estudiando Ciencias de la Computación. Después de trabajar como Ingeniero de iOS durante algunos años, Dawood renunció para iniciar Gradio con sus compañeros cofundadores. Gradio fue finalmente adquirida por Hugging Face.
Merve Noyan es una defensora de desarrolladores en Hugging Face, trabajando en el desarrollo de herramientas y la creación de contenido en torno a ellas para democratizar el machine learning para todos.
Lucile Saulnier es ingeniera de machine learning en Hugging Face, desarrollando y apoyando el uso de herramientas de código abierto. También participa activamente en muchos proyectos de investigación en el campo del Procesamiento de Lenguaje Natural, como el entrenamiento colaborativo y BigScience.
Lewis Tunstall es ingeniero de machine learning en Hugging Face, enfocado en desarrollar herramientas de código abierto y hacerlas accesibles a la comunidad en general. También es coautor del libro de O'Reilly Natural Language Processing with Transformers.
Leandro von Werra es ingeniero de machine learning en el equipo de código abierto de Hugging Face y también coautor del libro de O'Reilly Natural Language Processing with Transformers. Tiene varios años de experiencia en la industria llevando proyectos de NLP a producción trabajando en toda la pila de machine learning.
Preguntas frecuentes[[faq]]
Aquí tienes algunas respuestas a preguntas frecuentes:
¿Obtener este curso lleva a una certificación? Actualmente no tenemos ninguna certificación para este curso. Sin embargo, estamos trabajando en un programa de certificación para el ecosistema de Hugging Face, ¡mantente atento!
¿Cuánto tiempo debo dedicar a este curso? Cada capítulo de este curso está diseñado para completarse en 1 semana, con aproximadamente 6-8 horas de trabajo por semana. Sin embargo, puedes tomarte todo el tiempo que necesites para completar el curso.
¿Dónde puedo hacer una pregunta si tengo una? Si tienes una pregunta sobre cualquier sección del curso, simplemente haz clic en el banner "Haz una pregunta" en la parte superior de la página para ser redirigido automáticamente a la sección correcta de los foros de Hugging Face:
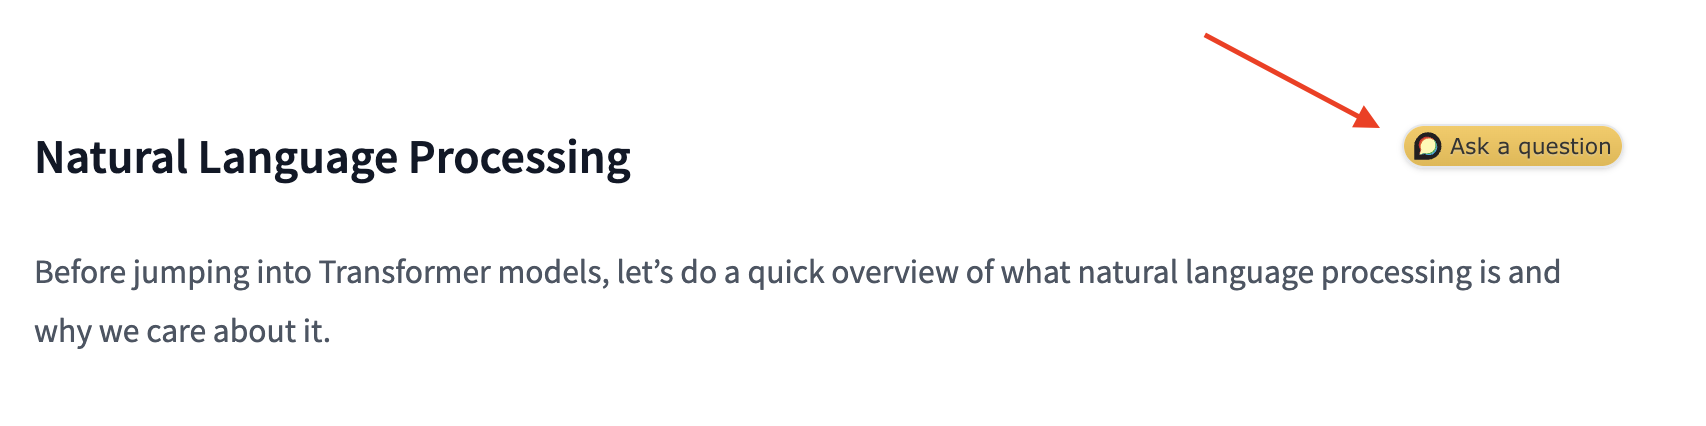
Ten en cuenta que también hay una lista de ideas de proyectos disponible en los foros si deseas practicar más una vez que hayas completado el curso.
- ¿Dónde puedo obtener el código del curso? Para cada sección, haz clic en el banner en la parte superior de la página para ejecutar el código en Google Colab o Amazon SageMaker Studio Lab:
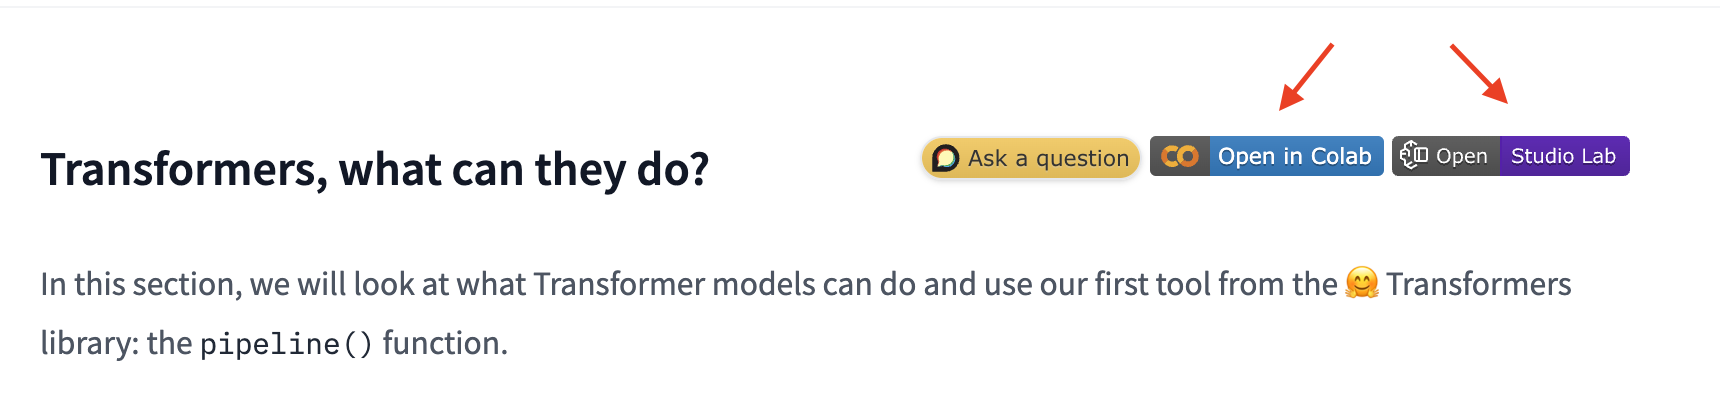
Los notebooks de Jupyter que contienen todo el código del curso están alojados en el repositorio huggingface/notebooks. Si deseas generarlos localmente, consulta las instrucciones en el repositorio course en GitHub.
¿Cómo puedo contribuir al curso? ¡Hay muchas maneras de contribuir al curso! Si encuentras un error tipográfico o un bug, abre un issue en el repositorio
course. Si deseas ayudar a traducir el curso a tu idioma nativo, consulta las instrucciones aquí.** ¿Cuáles fueron las decisiones tomadas para cada traducción?** Cada traducción tiene un glosario y un archivo
TRANSLATING.txtque detalla las decisiones que se tomaron para la jerga de machine learning, etc. Puedes encontrar un ejemplo para el alemán aquí.¿Puedo reutilizar este curso? ¡Claro que sí! El curso se publica bajo la permisiva licencia Apache 2. Esto significa que debes dar el crédito apropiado, proporcionar un enlace a la licencia e indicar si se realizaron cambios. Puedes hacerlo de cualquier manera razonable, pero no de una manera que sugiera que el licenciante te respalda a ti o a tu uso. Si deseas citar el curso, utiliza el siguiente BibTeX:
@misc{huggingfacecourse,
  author = {Hugging Face},
  title = {The Hugging Face Course, 2022},
  howpublished = "\url{https://huggingface.co/course}",
  year = {2022},
  note = "[Online; accessed <today>]"
}
Idiomas y traducciones[[languages-and-translations]]
Gracias a nuestra maravillosa comunidad, el curso está disponible en muchos idiomas además del inglés 🔥. Consulta la tabla a continuación para ver qué idiomas están disponibles y quiénes contribuyeron a las traducciones:
| Idioma | Autores |
|---|---|
| Francés | @lbourdois, @ChainYo, @melaniedrevet, @abdouaziz |
| Vietnamita | @honghanhh |
| Chino (simplificado) | @zhlhyx, petrichor1122, @yaoqih |
| Bengalí (WIP) | @avishek-018, @eNipu |
| Alemán (WIP) | @JesperDramsch, @MarcusFra, @fabridamicelli |
| Español (WIP) | @camartinezbu, @munozariasjm, @fordaz |
| Persa (WIP) | @jowharshamshiri, @schoobani |
| Gujarati (WIP) | @pandyaved98 |
| Hebreo (WIP) | @omer-dor |
| Hindi (WIP) | @pandyaved98 |
| Bahasa Indonesia (WIP) | @gstdl |
| Italiano (WIP) | @CaterinaBi, @ClonedOne, @Nolanogenn, @EdAbati, @gdacciaro |
| Japonés (WIP) | @hiromu166, @younesbelkada, @HiromuHota |
| Coreano (WIP) | @Doohae, @wonhyeongseo, @dlfrnaos19 |
| Portugués (WIP) | @johnnv1, @victorescosta, @LincolnVS |
| Ruso (WIP) | @pdumin, @svv73 |
| Tailandés (WIP) | @peeraponw, @a-krirk, @jomariya23156, @ckingkan |
| Turco (WIP) | @tanersekmen, @mertbozkir, @ftarlaci, @akkasayaz |
| Chino (tradicional) (WIP) | @davidpeng86 |
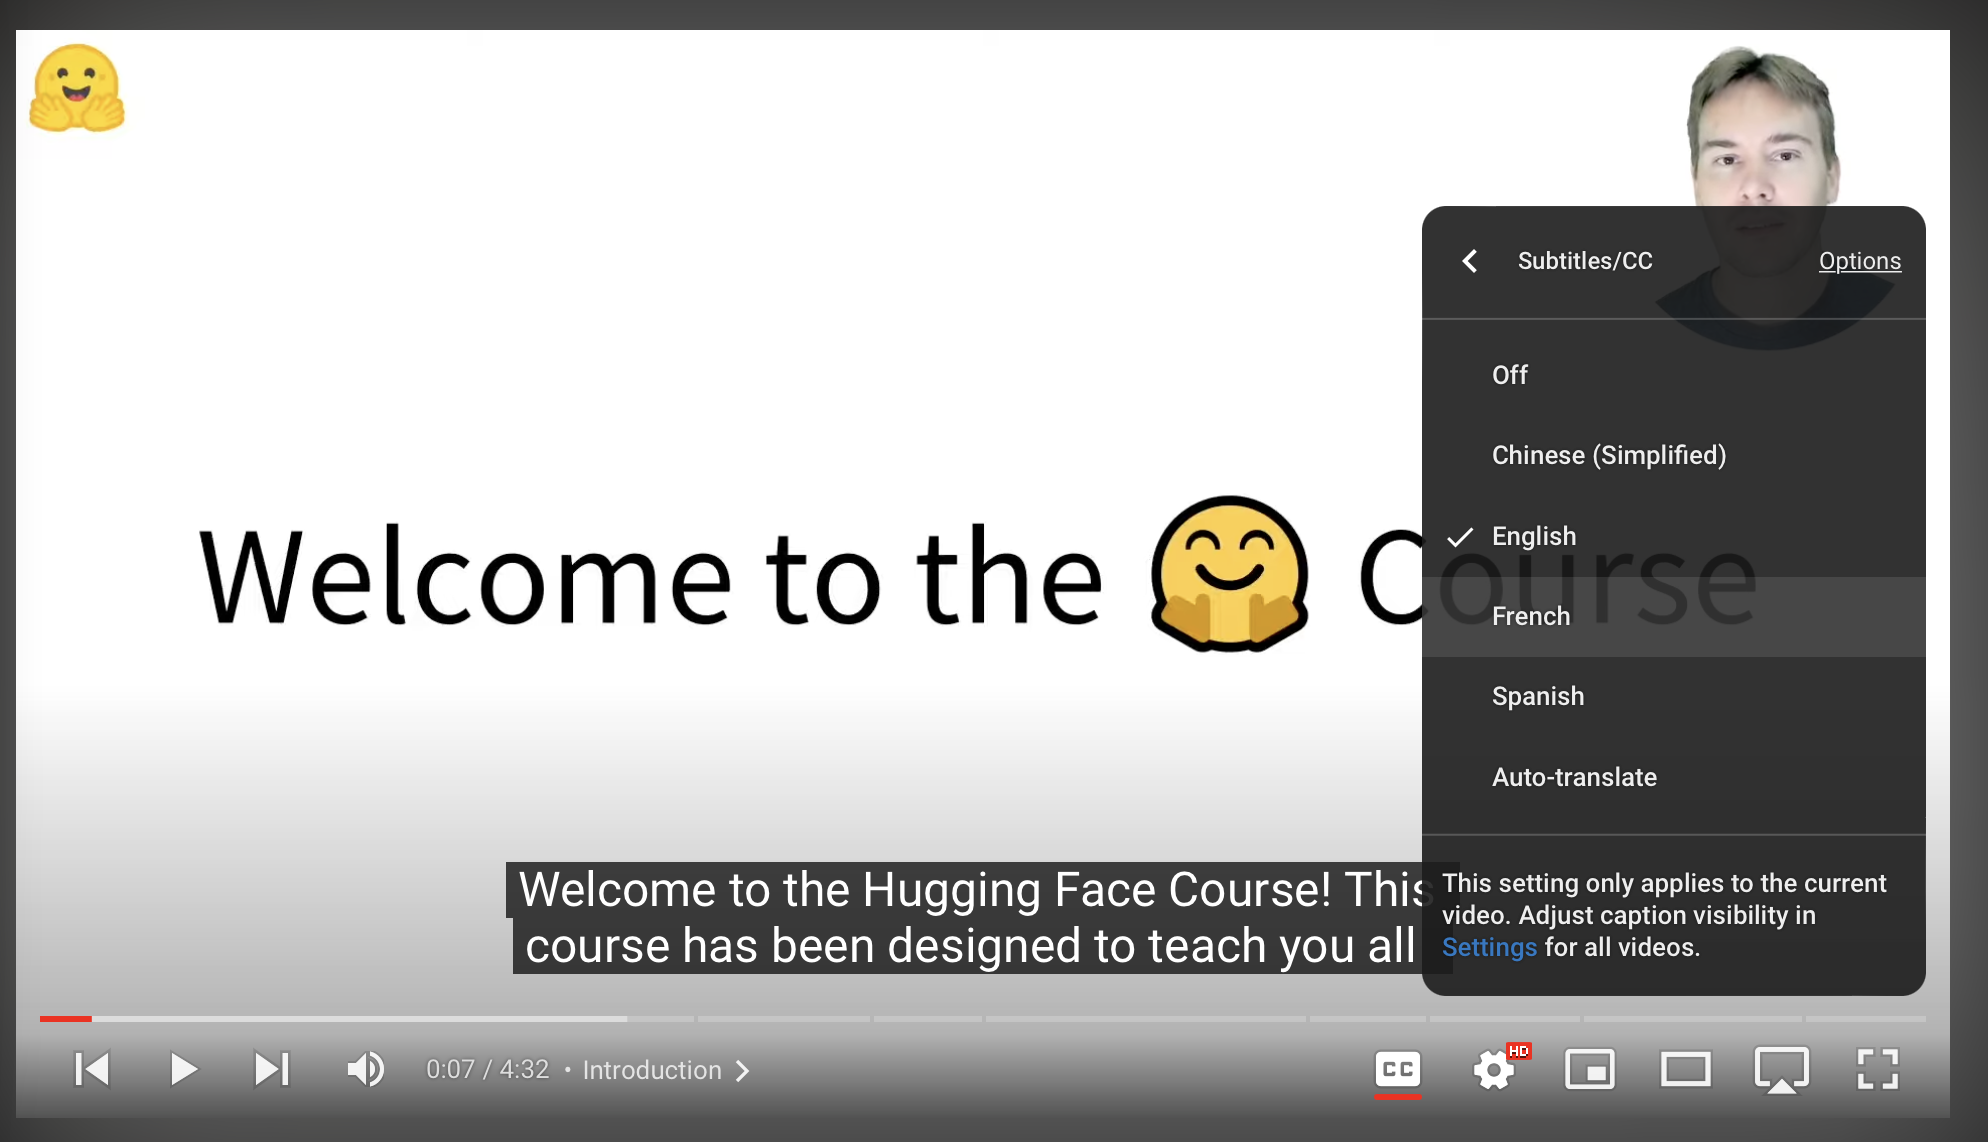
Para algunos idiomas, los videos del curso en YouTube tienen subtítulos en el idioma. Puedes habilitarlos haciendo clic primero en el botón CC en la esquina inferior derecha del video. Luego, bajo el icono de configuración ⚙️, puedes seleccionar el idioma que desees eligiendo la opción Subtítulos/CC.
[!TIP] ¿No ves tu idioma en la tabla anterior o te gustaría contribuir a una traducción existente? Puedes ayudarnos a traducir el curso siguiendo las instrucciones aquí.
¡Vamos 🚀
¿Estás listo para empezar? En este capítulo, aprenderás:
- Cómo usar la función
pipeline()para resolver tareas de NLP como la generación y clasificación de texto - Sobre la arquitectura Transformer
- Cómo distinguir entre arquitecturas de codificador, decodificador y codificador-decodificador, y sus casos de uso