Adaptación de dominio para modelos de lenguaje
{#if fw === 'pt'}
{:else}
{/if}
Para muchas aplicaciones de PNL que involucran modelos Transformer, puedes simplemente tomar un modelo preentrenado del Hugging Face Hub y hacerle fine-tuning directamente con tus datos para la tarea en cuestión. Siempre que el corpus utilizado para el preentrenamiento no sea demasiado diferente del corpus utilizado para el fine-tuning, el aprendizaje por transferencia generalmente producirá buenos resultados.
Sin embargo, hay algunos casos en los que querrás hacer fine-tuning primero a los modelos de lenguaje con tus datos, antes de entrenar un "head" específico para la tarea. Por ejemplo, si tu conjunto de datos contiene contratos legales o artículos científicos, un modelo Transformer estándar como BERT típicamente tratará las palabras específicas del dominio en tu corpus como tokens raros, y el rendimiento resultante puede ser menos que satisfactorio. Al hacer fine-tuning al modelo de lenguaje con datos del dominio, puedes aumentar el rendimiento de muchas tareas posteriores, lo que significa que usualmente solo tienes que hacer este paso una vez.
Este proceso de hacer fine-tuning a un modelo de lenguaje preentrenado con datos del dominio se llama usualmente adaptación de dominio. Fue popularizado en 2018 por ULMFiT, que fue una de las primeras arquitecturas neuronales (basada en LSTMs) en hacer que el aprendizaje por transferencia realmente funcionara para PNL. Un ejemplo de adaptación de dominio con ULMFiT se muestra en la imagen de abajo; en esta sección haremos algo similar, ¡pero con un Transformer en lugar de un LSTM!
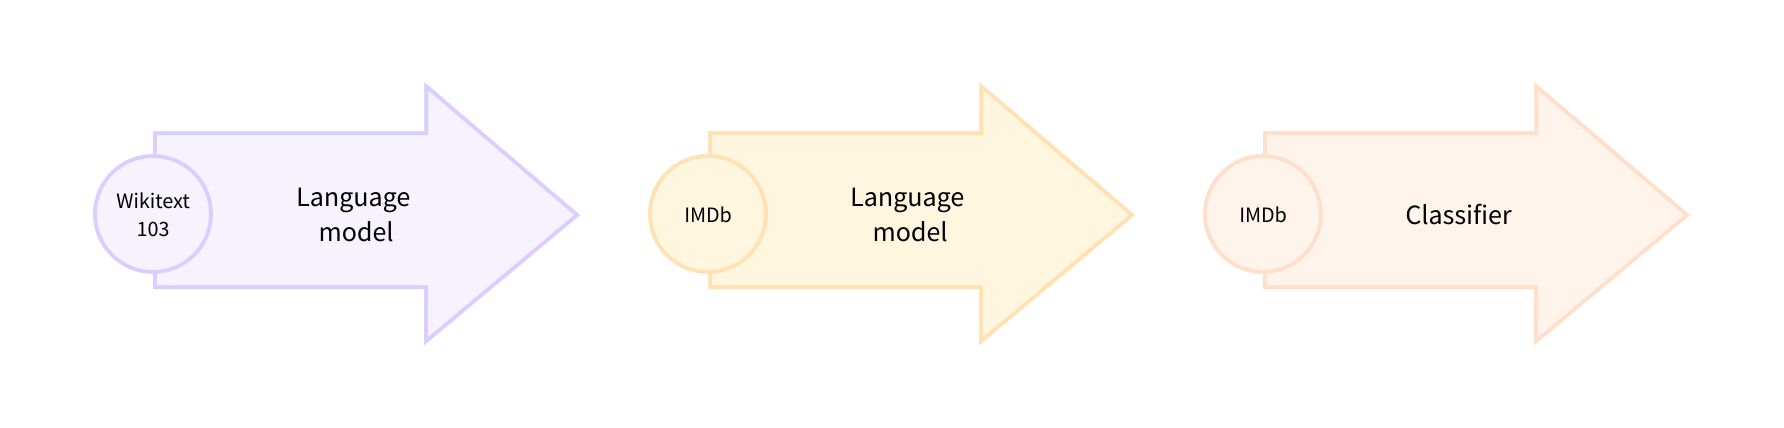
Al final de esta sección tendrás un modelo de lenguaje enmascarado en el Hub que puede autocompletar oraciones como se muestra a continuación:
¡Vamos a ello!
[!TIP] 🙋 Si los términos "modelado de lenguaje enmascarado" y "modelo preentrenado" te resultan desconocidos, consulta el Capítulo 1, donde explicamos todos estos conceptos clave, ¡con videos incluidos!
Seleccionando un modelo preentrenado para el modelado de lenguaje enmascarado[[picking-a-pretrained-model-for-masked-language-modeling]]
Para empezar, seleccionemos un modelo preentrenado adecuado para el modelado de lenguaje enmascarado. Como se muestra en la siguiente captura de pantalla, puedes encontrar una lista de candidatos aplicando el filtro "Fill-Mask" en el Hugging Face Hub:
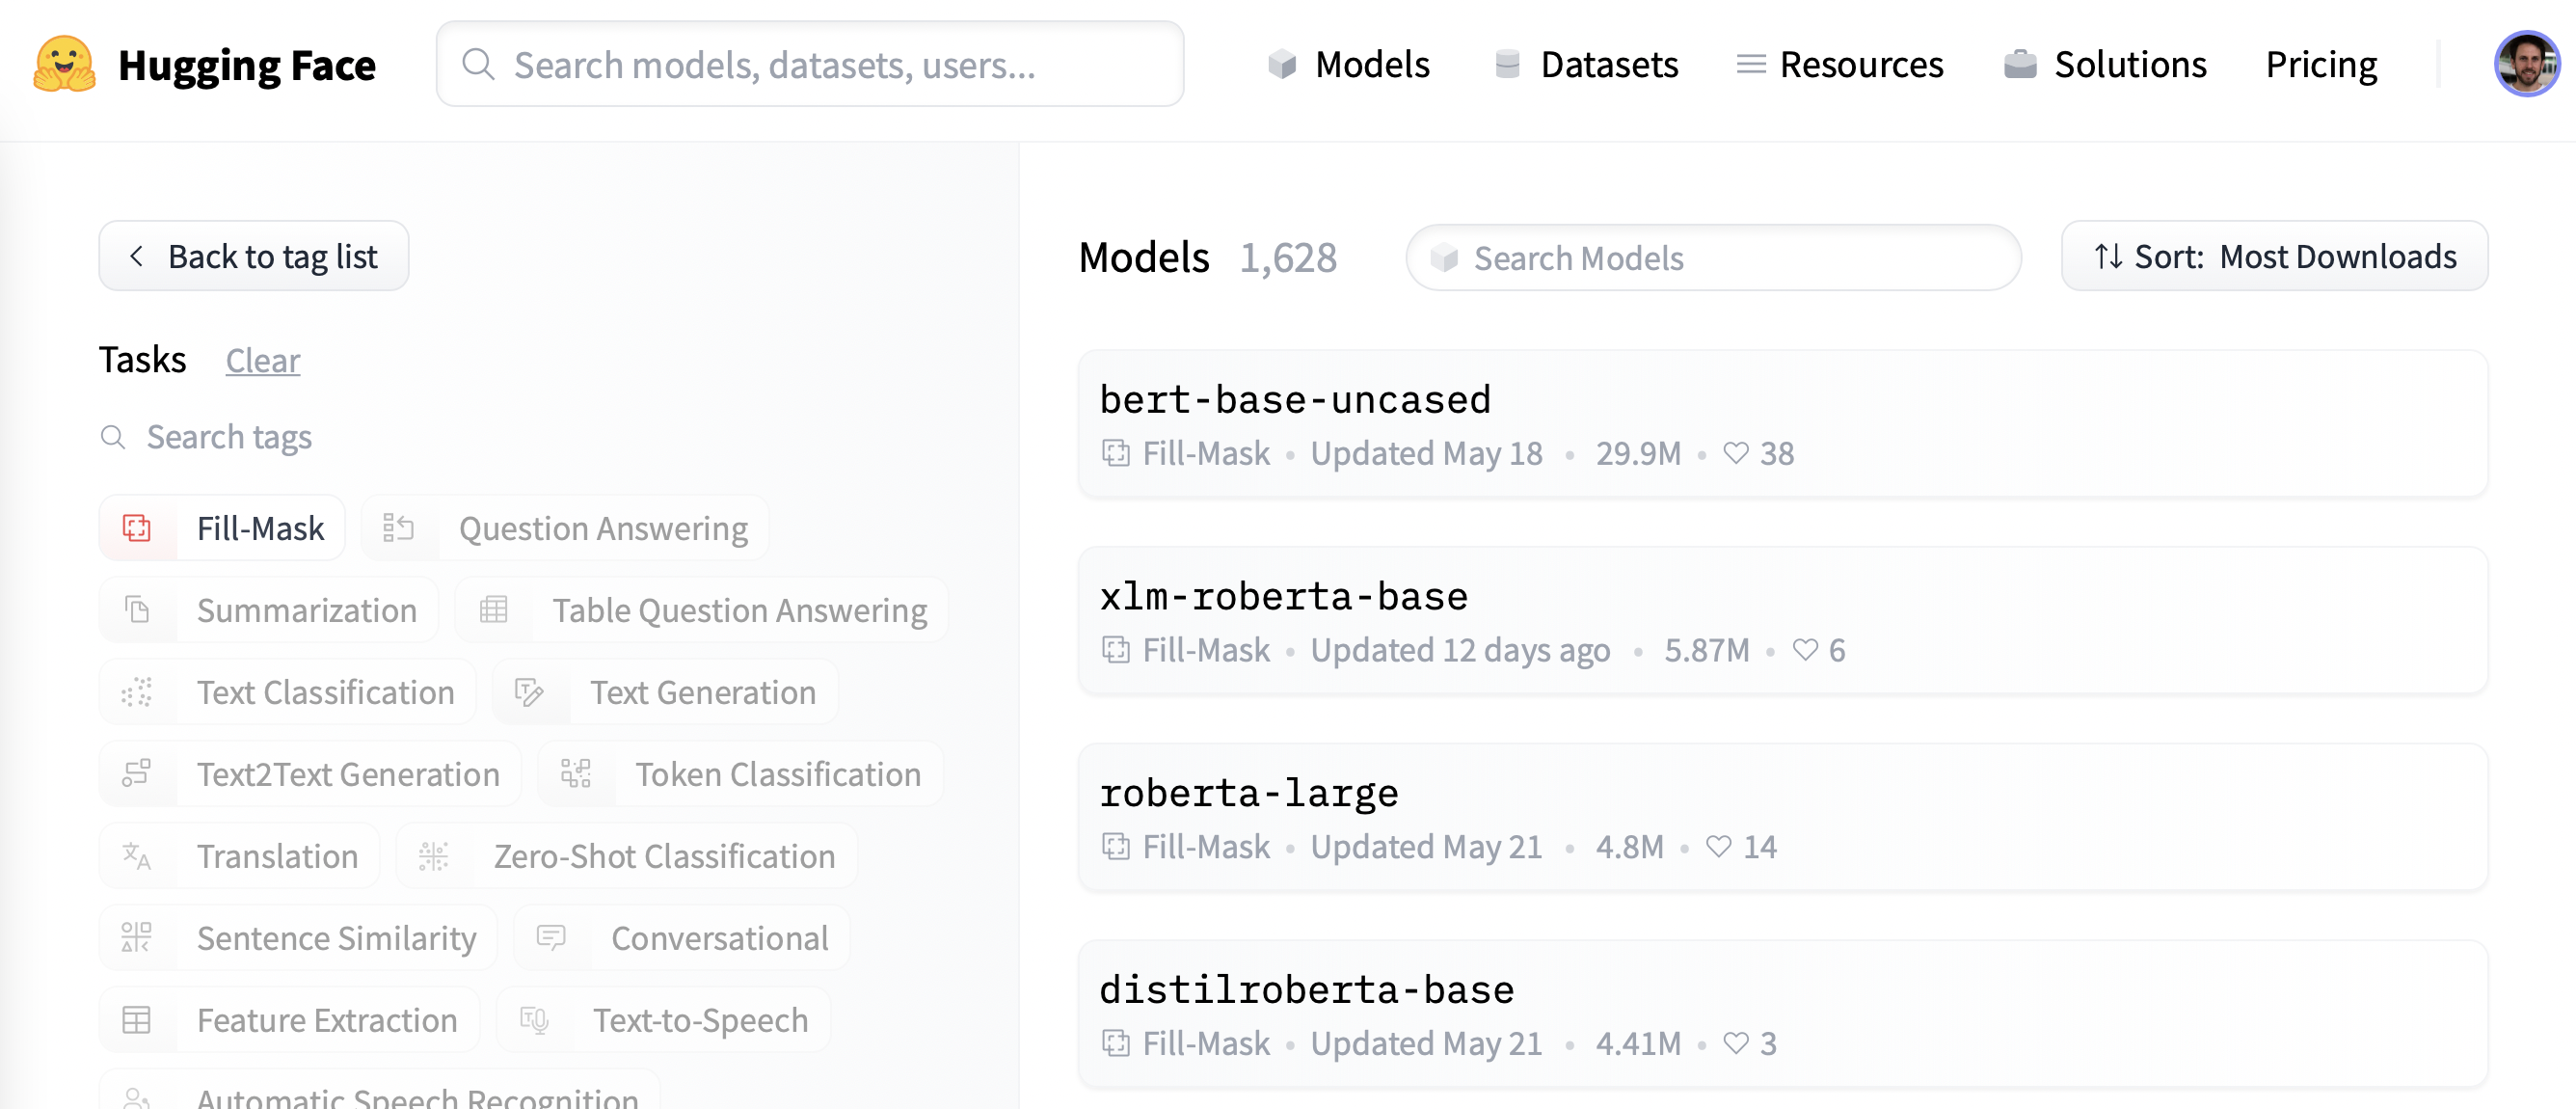
Aunque la familia de modelos BERT y RoBERTa son los más descargados, usaremos un modelo llamado DistilBERT que puede ser entrenado mucho más rápido con poca o ninguna pérdida en el rendimiento posterior. Este modelo fue entrenado usando una técnica especial llamada destilación de conocimiento, donde un "modelo maestro" grande como BERT se usa para guiar el entrenamiento de un "modelo estudiante" que tiene muchos menos parámetros. Una explicación de los detalles de la destilación de conocimiento nos llevaría demasiado lejos en esta sección, pero si estás interesado puedes leer todo al respecto en Natural Language Processing with Transformers (conocido coloquialmente como el libro de texto de Transformers).
{#if fw === 'pt'}
Descarguemos DistilBERT usando la clase AutoModelForMaskedLM:
from transformers import AutoModelForMaskedLM

model_checkpoint = "distilbert-base-uncased"
model = AutoModelForMaskedLM.from_pretrained(model_checkpoint)
Podemos ver cuántos parámetros tiene este modelo llamando al método num_parameters():
distilbert_num_parameters = model.num_parameters() / 1_000_000
print(f"'>>> DistilBERT number of parameters: {round(distilbert_num_parameters)}M'")
print(f"'>>> BERT number of parameters: 110M'")
'>>> DistilBERT number of parameters: 67M'
'>>> BERT number of parameters: 110M'
{:else}
Descarguemos DistilBERT usando la clase AutoModelForMaskedLM:
from transformers import TFAutoModelForMaskedLM

model_checkpoint = "distilbert-base-uncased"
model = TFAutoModelForMaskedLM.from_pretrained(model_checkpoint)
Podemos ver cuántos parámetros tiene este modelo llamando al método summary():
model.summary()
Model: "tf_distil_bert_for_masked_lm"
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
distilbert (TFDistilBertMain multiple                  66362880
_________________________________________________________________
vocab_transform (Dense)      multiple                  590592
_________________________________________________________________
vocab_layer_norm (LayerNorma multiple                  1536
_________________________________________________________________
vocab_projector (TFDistilBer multiple                  23866170
=================================================================
Total params: 66,985,530
Trainable params: 66,985,530
Non-trainable params: 0
_________________________________________________________________
{/if}
Con alrededor de 67 millones de parámetros, DistilBERT es aproximadamente dos veces más pequeño que el modelo base de BERT, lo que se traduce aproximadamente en una duplicación de la velocidad de entrenamiento, ¡genial! Ahora veamos qué tipo de tokens predice este modelo como las terminaciones más probables de una pequeña muestra de texto:
text = "This is a great [MASK]."
Como humanos, podemos imaginar muchas posibilidades para el token [MASK], como "día", "paseo" o "pintura". Para los modelos preentrenados, las predicciones dependen del corpus en el que se entrenó el modelo, ya que aprende a captar los patrones estadísticos presentes en los datos. Al igual que BERT, DistilBERT fue preentrenado en los conjuntos de datos English Wikipedia y BookCorpus, por lo que esperamos que las predicciones para [MASK] reflejen estos dominios. Para predecir la máscara, necesitamos que el tokenizador de DistilBERT produzca las entradas para el modelo, así que descarguemos eso del Hub también:
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
Con un tokenizador y un modelo, ahora podemos pasar nuestro ejemplo de texto al modelo, extraer los logits e imprimir los 5 candidatos principales:
{#if fw === 'pt'}
inputs = tokenizer(text, return_tensors="pt")
token_logits = model(**inputs).logits
# Find the location of [MASK] and extract its logits
mask_token_index = torch.where(inputs["input_ids"] == tokenizer.mask_token_id)[1]
mask_token_logits = token_logits[0, mask_token_index, :]
# Pick the [MASK] candidates with the highest logits
top_5_tokens = torch.topk(mask_token_logits, 5, dim=1).indices[0].tolist()

for token in top_5_tokens:
    print(f"'>>> {text.replace(tokenizer.mask_token, tokenizer.decode([token]))}'")
{:else}
inputs = tokenizer(text, return_tensors="np")
token_logits = model(**inputs).logits
# Find the location of [MASK] and extract its logits
mask_token_index = np.argwhere(inputs["input_ids"] == tokenizer.mask_token_id)[0, 1]
mask_token_logits = token_logits[0, mask_token_index, :]
# Pick the [MASK] candidates with the highest logits
# We negate the array before argsort to get the largest, not the smallest, logits
top_5_tokens = np.argsort(-mask_token_logits)[:5].tolist()

for token in top_5_tokens:
    print(f">>> {text.replace(tokenizer.mask_token, tokenizer.decode([token]))}")
{/if}
'>>> This is a great deal.'
'>>> This is a great success.'
'>>> This is a great adventure.'
'>>> This is a great idea.'
'>>> This is a great feat.'
Podemos ver en los resultados que las predicciones del modelo se refieren a términos cotidianos, lo que quizás no sea sorprendente dada la base de la Wikipedia en inglés. Veamos cómo podemos cambiar este dominio a algo un poco más específico: ¡reseñas de películas altamente polarizadas!
El conjunto de datos[[the-dataset]]
Para mostrar la adaptación de dominio, usaremos el famoso Large Movie Review Dataset (o IMDb para abreviar), que es un corpus de reseñas de películas que a menudo se usa para comparar modelos de análisis de sentimientos. Al hacer fine-tuning a DistilBERT en este corpus, esperamos que el modelo de lenguaje adapte su vocabulario de los datos fácticos de Wikipedia en los que fue preentrenado a los elementos más subjetivos de las reseñas de películas. Podemos obtener los datos del Hugging Face Hub con la función load_dataset() de 🤗 Datasets:
from datasets import load_dataset

imdb_dataset = load_dataset("imdb")
imdb_dataset
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 25000
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 25000
    })
    unsupervised: Dataset({
        features: ['text', 'label'],
        num_rows: 50000
    })
})
Podemos ver que los splits train y test consisten cada uno en 25,000 reseñas, mientras que hay un split sin etiquetar llamado unsupervised que contiene 50,000 reseñas. Echemos un vistazo a algunas muestras para tener una idea del tipo de texto con el que estamos tratando. Como hemos hecho en capítulos anteriores del curso, encadenaremos las funciones Dataset.shuffle() y Dataset.select() para crear una muestra aleatoria:
sample = imdb_dataset["train"].shuffle(seed=42).select(range(3))

for row in sample:
    print(f"\n'>>> Review: {row['text']}'")
    print(f"'>>> Label: {row['label']}'")
'>>> Review: This is your typical Priyadarshan movie--a bunch of loony characters out on some silly mission. His signature climax has the entire cast of the film coming together and fighting each other in some crazy moshpit over hidden money. Whether it is a winning lottery ticket in Malamaal Weekly, black money in Hera Pheri, "kodokoo" in Phir Hera Pheri, etc., etc., the director is becoming ridiculously predictable. Don\'t get me wrong; as clichéd and preposterous his movies may be, I usually end up enjoying the comedy. However, in most his previous movies there has actually been some good humor, (Hungama and Hera Pheri being noteworthy ones). Now, the hilarity of his films is fading as he is using the same formula over and over again.<br /><br />Songs are good. Tanushree Datta looks awesome. Rajpal Yadav is irritating, and Tusshar is not a whole lot better. Kunal Khemu is OK, and Sharman Joshi is the best.'
'>>> Label: 0'

'>>> Review: Okay, the story makes no sense, the characters lack any dimensionally, the best dialogue is ad-libs about the low quality of movie, the cinematography is dismal, and only editing saves a bit of the muddle, but Sam" Peckinpah directed the film. Somehow, his direction is not enough. For those who appreciate Peckinpah and his great work, this movie is a disappointment. Even a great cast cannot redeem the time the viewer wastes with this minimal effort.<br /><br />The proper response to the movie is the contempt that the director San Peckinpah, James Caan, Robert Duvall, Burt Young, Bo Hopkins, Arthur Hill, and even Gig Young bring to their work. Watch the great Peckinpah films. Skip this mess.'
'>>> Label: 0'

'>>> Review: I saw this movie at the theaters when I was about 6 or 7 years old. I loved it then, and have recently come to own a VHS version. <br /><br />My 4 and 6 year old children love this movie and have been asking again and again to watch it. <br /><br />I have enjoyed watching it again too. Though I have to admit it is not as good on a little TV.<br /><br />I do not have older children so I do not know what they would think of it. <br /><br />The songs are very cute. My daughter keeps singing them over and over.<br /><br />Hope this helps.'
'>>> Label: 1'
Sí, estas son ciertamente reseñas de películas, y si eres lo suficientemente mayor, ¡incluso podrías entender el comentario en la última reseña sobre tener una versión en VHS 😜! Aunque no necesitaremos las etiquetas para el modelado de lenguaje, ya podemos ver que un 0 denota una reseña negativa, mientras que un 1 corresponde a una positiva.
[!TIP] ✏️ ¡Pruébalo! Crea una muestra aleatoria del split
unsupervisedy verifica que las etiquetas no sean ni0ni1. Ya que estás, también podrías verificar que las etiquetas en los splitstrainytestsean de hecho0o1. ¡Esta es una verificación de cordura útil que todo profesional de PNL debería realizar al comienzo de un nuevo proyecto!
Ahora que hemos echado un vistazo rápido a los datos, profundicemos en su preparación para el modelado de lenguaje enmascarado. Como veremos, hay algunos pasos adicionales que deben tomarse en comparación con las tareas de clasificación de secuencias que vimos en el Capítulo 3. ¡Vamos!
Preprocesamiento de los datos[[preprocessing-the-data]]
Para el modelado de lenguaje tanto autorregresivo como enmascarado, un paso de preprocesamiento común es concatenar todos los ejemplos y luego dividir todo el corpus en fragmentos de igual tamaño. Esto es bastante diferente de nuestro enfoque habitual, donde simplemente tokenizamos ejemplos individuales. ¿Por qué concatenar todo? La razón es que los ejemplos individuales podrían truncarse si son demasiado largos, ¡y eso resultaría en la pérdida de información que podría ser útil para la tarea de modelado de lenguaje!
Así que para empezar, primero tokenizaremos nuestro corpus como de costumbre, pero sin establecer la opción truncation=True en nuestro tokenizador. También tomaremos los IDs de palabras si están disponibles (lo estarán si estamos usando un tokenizador rápido, como se describe en el Capítulo 6), ya que los necesitaremos más adelante para hacer el enmascaramiento de palabras completas. Envolveremos esto en una función simple, y ya que estamos, eliminaremos las columnas text y label ya que no las necesitamos más:
def tokenize_function(examples):
    result = tokenizer(examples["text"])
    if tokenizer.is_fast:
        result["word_ids"] = [result.word_ids(i) for i in range(len(result["input_ids"]))]
    return result


# Use batched=True to activate fast multithreading!
tokenized_datasets = imdb_dataset.map(
    tokenize_function, batched=True, remove_columns=["text", "label"]
)
tokenized_datasets
DatasetDict({
    train: Dataset({
        features: ['attention_mask', 'input_ids', 'word_ids'],
        num_rows: 25000
    })
    test: Dataset({
        features: ['attention_mask', 'input_ids', 'word_ids'],
        num_rows: 25000
    })
    unsupervised: Dataset({
        features: ['attention_mask', 'input_ids', 'word_ids'],
        num_rows: 50000
    })
})
Dado que DistilBERT es un modelo tipo BERT, podemos ver que los textos codificados consisten en los input_ids y attention_mask que hemos visto en otros capítulos, así como el word_ids que agregamos.
Ahora que hemos tokenizado nuestras reseñas de películas, el siguiente paso es agruparlas todas y dividir el resultado en fragmentos. Pero, ¿qué tan grandes deben ser estos fragmentos? Esto finalmente estará determinado por la cantidad de memoria de GPU que tengas disponible, pero un buen punto de partida es ver cuál es el tamaño máximo de contexto del modelo. Esto se puede inferir inspeccionando el atributo model_max_length del tokenizador:
tokenizer.model_max_length
512
Este valor se deriva del archivo tokenizer_config.json asociado con un checkpoint; en este caso podemos ver que el tamaño del contexto es de 512 tokens, al igual que con BERT.
[!TIP] ✏️ ¡Pruébalo! Algunos modelos Transformer, como BigBird y Longformer, tienen una longitud de contexto mucho mayor que BERT y otros modelos Transformer tempranos. Instancia el tokenizador para uno de estos checkpoints y verifica que el
model_max_lengthconcuerda con lo que se cita en su tarjeta de modelo.
Entonces, para ejecutar nuestros experimentos en GPUs como las que se encuentran en Google Colab, elegiremos algo un poco más pequeño que pueda caber en la memoria:
chunk_size = 128
[!WARNING] Ten en cuenta que usar un tamaño de fragmento pequeño puede ser perjudicial en escenarios del mundo real, por lo que debes usar un tamaño que corresponda al caso de uso al que aplicarás tu modelo.
Ahora viene la parte divertida. Para mostrar cómo funciona la concatenación, tomemos algunas reseñas de nuestro conjunto de entrenamiento tokenizado e imprimamos el número de tokens por reseña:
# Slicing produces a list of lists for each feature
tokenized_samples = tokenized_datasets["train"][:3]

for idx, sample in enumerate(tokenized_samples["input_ids"]):
    print(f"'>>> Review {idx} length: {len(sample)}'")
'>>> Review 0 length: 200'
'>>> Review 1 length: 559'
'>>> Review 2 length: 192'
Luego podemos concatenar todos estos ejemplos con una simple comprensión de diccionario, de la siguiente manera:
concatenated_examples = {
    k: sum(tokenized_samples[k], []) for k in tokenized_samples.keys()
}
total_length = len(concatenated_examples["input_ids"])
print(f"'>>> Concatenated reviews length: {total_length}'")
'>>> Concatenated reviews length: 951'
Genial, la longitud total coincide, así que ahora dividamos las reseñas concatenadas en fragmentos del tamaño dado por chunk_size. Para hacerlo, iteramos sobre las características en concatenated_examples y usamos una comprensión de lista para crear porciones de cada característica. El resultado es un diccionario de fragmentos para cada característica:
chunks = {
    k: [t[i : i + chunk_size] for i in range(0, total_length, chunk_size)]
    for k, t in concatenated_examples.items()
}

for chunk in chunks["input_ids"]:
    print(f"'>>> Chunk length: {len(chunk)}'")
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 128'
'>>> Chunk length: 55'
Como puedes ver en este ejemplo, el último fragmento generalmente será más pequeño que el tamaño máximo del fragmento. Hay dos estrategias principales para lidiar con esto:
- Eliminar el último fragmento si es más pequeño que
chunk_size. - Rellenar el último fragmento hasta que su longitud sea igual a
chunk_size.
Aquí tomaremos el primer enfoque, así que envolvamos toda la lógica anterior en una sola función que podamos aplicar a nuestros conjuntos de datos tokenizados:
def group_texts(examples):
    # Concatenate all texts
    concatenated_examples = {k: sum(examples[k], []) for k in examples.keys()}
    # Compute length of concatenated texts
    total_length = len(concatenated_examples[list(examples.keys())[0]])
    # We drop the last chunk if it's smaller than chunk_size
    total_length = (total_length // chunk_size) * chunk_size
    # Split by chunks of max_len
    result = {
        k: [t[i : i + chunk_size] for i in range(0, total_length, chunk_size)]
        for k, t in concatenated_examples.items()
    }
    # Create a new labels column
    result["labels"] = result["input_ids"].copy()
    return result
Ten en cuenta que en el último paso de group_texts() creamos una nueva columna labels que es una copia de la columna input_ids. Como veremos en breve, esto se debe a que en el modelado de lenguaje enmascarado el objetivo es predecir tokens enmascarados aleatoriamente en el lote de entrada, y al crear una columna labels proporcionamos la verdad fundamental para que nuestro modelo de lenguaje aprenda.
Ahora apliquemos group_texts() a nuestros conjuntos de datos tokenizados usando nuestra confiable función Dataset.map():
lm_datasets = tokenized_datasets.map(group_texts, batched=True)
lm_datasets
DatasetDict({
    train: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 61289
    })
    test: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 59905
    })
    unsupervised: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 122963
    })
})
Puedes ver que agrupar y luego dividir los textos en fragmentos ha producido muchos más ejemplos que nuestros 25,000 originales para los splits train y test. Esto se debe a que ahora tenemos ejemplos que involucran tokens contiguos que abarcan múltiples ejemplos del corpus original. Puedes ver esto explícitamente buscando los tokens especiales [SEP] y [CLS] en uno de los fragmentos:
tokenizer.decode(lm_datasets["train"][1]["input_ids"])
".... at.......... high. a classic line : inspector : i'm here to sack one of your teachers. student : welcome to bromwell high. i expect that many adults of my age think that bromwell high is far fetched. what a pity that it isn't! [SEP] [CLS] homelessness ( or houselessness as george carlin stated ) has been an issue for years but never a plan to help those on the street that were once considered human who did everything from going to school, work, or vote for the matter. most people think of the homeless"
En este ejemplo puedes ver dos reseñas de películas superpuestas, una sobre una película de secundaria y la otra sobre la falta de vivienda. También veamos cómo se ven las etiquetas para el modelado de lenguaje enmascarado:
tokenizer.decode(lm_datasets["train"][1]["labels"])
".... at.......... high. a classic line : inspector : i'm here to sack one of your teachers. student : welcome to bromwell high. i expect that many adults of my age think that bromwell high is far fetched. what a pity that it isn't! [SEP] [CLS] homelessness ( or houselessness as george carlin stated ) has been an issue for years but never a plan to help those on the street that were once considered human who did everything from going to school, work, or vote for the matter. most people think of the homeless"
Como se esperaba de nuestra función group_texts() anterior, esto se ve idéntico al input_ids decodificado, pero entonces, ¿cómo puede nuestro modelo aprender algo? Nos falta un paso clave: ¡insertar tokens [MASK] en posiciones aleatorias en las entradas! Veamos cómo podemos hacer esto sobre la marcha durante el fine-tuning usando un "data collator" especial.
Fine-tuning de DistilBERT con la API Trainer[[fine-tuning-distilbert-with-the-trainer-api]]
El fine-tuning de un modelo de lenguaje enmascarado es casi idéntico al fine-tuning de un modelo de clasificación de secuencias, como hicimos en el Capítulo 3. La única diferencia es que necesitamos un "data collator" especial que pueda enmascarar aleatoriamente algunos de los tokens en cada lote de textos. Afortunadamente, 🤗 Transformers viene preparado con un DataCollatorForLanguageModeling dedicado para esta tarea. Solo tenemos que pasarle el tokenizador y un argumento mlm_probability que especifica qué fracción de los tokens enmascarar. Elegiremos el 15%, que es la cantidad utilizada para BERT y una opción común en la literatura:
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm_probability=0.15)
Para ver cómo funciona el enmascaramiento aleatorio, alimentemos algunos ejemplos al "data collator". Dado que espera una lista de dict, donde cada dict representa un solo fragmento de texto contiguo, primero iteramos sobre el conjunto de datos antes de alimentar el lote al "collator". Eliminamos la clave "word_ids" para este "data collator" ya que no la espera:
samples = [lm_datasets["train"][i] for i in range(2)]
for sample in samples:
    _ = sample.pop("word_ids")

for chunk in data_collator(samples)["input_ids"]:
    print(f"\n'>>> {tokenizer.decode(chunk)}'")
'>>> [CLS] bromwell [MASK] is a cartoon comedy. it ran at the same [MASK] as some other [MASK] about school life, [MASK] as " teachers ". [MASK] [MASK] [MASK] in the teaching [MASK] lead [MASK] to believe that bromwell high\'[MASK] satire is much closer to reality than is " teachers ". the scramble [MASK] [MASK] financially, the [MASK]ful students whogn [MASK] right through [MASK] pathetic teachers\'pomp, the pettiness of the whole situation, distinction remind me of the schools i knew and their students. when i saw [MASK] episode in [MASK] a student repeatedly tried to burn down the school, [MASK] immediately recalled. [MASK]...'

'>>> .... at.. [MASK]... [MASK]... high. a classic line plucked inspector : i\'[MASK] here to [MASK] one of your [MASK]. student : welcome to bromwell [MASK]. i expect that many adults of my age think that [MASK]mwell [MASK] is [MASK] fetched. what a pity that it isn\'t! [SEP] [CLS] [MASK]ness ( or [MASK]lessness as george 宇in stated )公 been an issue for years but never [MASK] plan to help those on the street that were once considered human [MASK] did everything from going to school, [MASK], [MASK] vote for the matter. most people think [MASK] the homeless'
¡Genial, funcionó! Podemos ver que el token [MASK] ha sido insertado aleatoriamente en varias ubicaciones de nuestro texto. Estos serán los tokens que nuestro modelo tendrá que predecir durante el entrenamiento, ¡y la belleza del "data collator" es que aleatorizará la inserción de [MASK] con cada lote!
[!TIP] ✏️ ¡Pruébalo! ¡Ejecuta el fragmento de código anterior varias veces para ver cómo ocurre el enmascaramiento aleatorio ante tus propios ojos! También reemplaza el método
tokenizer.decode()contokenizer.convert_ids_to_tokens()para ver que a veces se enmascara un solo token de una palabra dada, y no los demás.
{#if fw === 'pt'}
Un efecto secundario del enmascaramiento aleatorio es que nuestras métricas de evaluación no serán deterministas al usar el Trainer, ya que usamos el mismo "data collator" para los conjuntos de entrenamiento y prueba. Veremos más adelante, cuando analicemos el fine-tuning con 🤗 Accelerate, cómo podemos usar la flexibilidad de un bucle de evaluación personalizado para congelar la aleatoriedad.
{/if}
Al entrenar modelos para el modelado de lenguaje enmascarado, una técnica que se puede utilizar es enmascarar palabras completas juntas, no solo tokens individuales. Este enfoque se llama enmascaramiento de palabras completas. Si queremos usar el enmascaramiento de palabras completas, tendremos que construir un "data collator" nosotros mismos. Un "data collator" es solo una función que toma una lista de muestras y las convierte en un lote, ¡así que hagámoslo ahora! Usaremos los IDs de palabras calculados anteriormente para crear un mapa entre los índices de palabras y los tokens correspondientes, luego decidiremos aleatoriamente qué palabras enmascarar y aplicaremos esa máscara en las entradas. Ten en cuenta que las etiquetas son todas -100 excepto las que corresponden a las palabras enmascaradas.
{#if fw === 'pt'}
from transformers import default_data_collator

wwm_probability = 0.2


def whole_word_masking_data_collator(features):
    for feature in features:
        word_ids = feature.pop("word_ids")

        # Create a map between words and corresponding token indices
        mapping = collections.defaultdict(list)
        current_word_index = -1
        current_word = None
        for idx, word_id in enumerate(word_ids):
            if word_id is not None:
                if word_id != current_word:
                    current_word = word_id
                    current_word_index += 1
                mapping[current_word_index].append(idx)

        # Randomly mask words
        mask = np.random.binomial(1, wwm_probability, (len(mapping),))
        input_ids = feature["input_ids"]
        labels = feature["labels"]
        new_labels = [-100] * len(labels)
        for word_id in np.where(mask)[0]:
            word_id = word_id.item()
            for idx in mapping[word_id]:
                new_labels[idx] = labels[idx]
                input_ids[idx] = tokenizer.mask_token_id
        feature["labels"] = new_labels

    return default_data_collator(features)
{:else}
from transformers.data.data_collator import tf_default_data_collator

wwm_probability = 0.2


def whole_word_masking_data_collator(features):
    for feature in features:
        word_ids = feature.pop("word_ids")

        # Create a map between words and corresponding token indices
        mapping = collections.defaultdict(list)
        current_word_index = -1
        current_word = None
        for idx, word_id in enumerate(word_ids):
            if word_id is not None:
                if word_id != current_word:
                    current_word = word_id
                    current_word_index += 1
                mapping[current_word_index].append(idx)

        # Randomly mask words
        mask = np.random.binomial(1, wwm_probability, (len(mapping),))
        input_ids = feature["input_ids"]
        labels = feature["labels"]
        new_labels = [-100] * len(labels)
        for word_id in np.where(mask)[0]:
            word_id = word_id.item()
            for idx in mapping[word_id]:
                new_labels[idx] = labels[idx]
                input_ids[idx] = tokenizer.mask_token_id
        feature["labels"] = new_labels

    return tf_default_data_collator(features)
{/if}
A continuación, podemos probarlo con las mismas muestras de antes:
samples = [lm_datasets["train"][i] for i in range(2)]
batch = whole_word_masking_data_collator(samples)

for chunk in batch["input_ids"]:
    print(f"\n'>>> {tokenizer.decode(chunk)}'")
'>>> [CLS] bromwell high is a cartoon comedy [MASK] it ran at the same time as some other programs about school life, such as " teachers ". my 35 years in the teaching profession lead me to believe that bromwell high\'s satire is much closer to reality than is " teachers ". the scramble to survive financially, the insightful students who can see right through their pathetic teachers\'pomp, the pettiness of the whole situation, all remind me of the schools i knew and their students. when i saw the episode in which a student repeatedly tried to burn down the school, i immediately recalled.....'

'>>> .... [MASK] [MASK] [MASK] [MASK]....... high. a classic line : inspector : i\'m here to sack one of your teachers. student : welcome to bromwell high. i expect that many adults of my age think that bromwell high is far fetched. what a pity that it isn\'t! [SEP] [CLS] homelessness ( or houselessness as george carlin stated ) has been an issue for years but never a plan to help those on the street that were once considered human who did everything from going to school, work, or vote for the matter. most people think of the homeless'
[!TIP] ✏️ ¡Pruébalo! ¡Ejecuta el fragmento de código anterior varias veces para ver cómo ocurre el enmascaramiento aleatorio ante tus propios ojos! También reemplaza el método
tokenizer.decode()contokenizer.convert_ids_to_tokens()para ver que los tokens de una palabra dada siempre se enmascaran juntos.
Ahora que tenemos dos "data collators", el resto de los pasos de fine-tuning son estándar. El entrenamiento puede llevar un tiempo en Google Colab si no tienes la suerte de conseguir una mítica GPU P100 😭, así que primero reduciremos el tamaño del conjunto de entrenamiento a unos pocos miles de ejemplos. No te preocupes, ¡aún obtendremos un modelo de lenguaje bastante decente! Una forma rápida de reducir el tamaño de un conjunto de datos en 🤗 Datasets es a través de la función Dataset.train_test_split() que vimos en el Capítulo 5:
train_size = 10_000
test_size = int(0.1 * train_size)

downsampled_dataset = lm_datasets["train"].train_test_split(
    train_size=train_size, test_size=test_size, seed=42
)
downsampled_dataset
DatasetDict({
    train: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 10000
    })
    test: Dataset({
        features: ['attention_mask', 'input_ids', 'labels', 'word_ids'],
        num_rows: 1000
    })
})
Esto ha creado automáticamente nuevos splits train y test, con el tamaño del conjunto de entrenamiento establecido en 10,000 ejemplos y el conjunto de validación en el 10% de eso. ¡Siéntete libre de aumentarlo si tienes una GPU potente! Lo siguiente que debemos hacer es iniciar sesión en el Hugging Face Hub. Si estás ejecutando este código en un notebook, puedes hacerlo con la siguiente función de utilidad:
from huggingface_hub import notebook_login

notebook_login()
que mostrará un widget donde puedes ingresar tus credenciales. Alternativamente, puedes ejecutar:
huggingface-cli login
en tu terminal favorita e iniciar sesión allí.
{#if fw === 'tf'}
Una vez que hayamos iniciado sesión, podemos crear nuestros conjuntos de datos tf.data. Para hacerlo, usaremos el método prepare_tf_dataset(), que usa nuestro modelo para inferir automáticamente qué columnas deben ir en el conjunto de datos. Si quieres controlar exactamente qué columnas usar, puedes usar el método Dataset.to_tf_dataset() en su lugar. Para simplificar, usaremos el "data collator" estándar aquí, pero también puedes probar el "collator" de enmascaramiento de palabras completas y comparar los resultados como un ejercicio:
tf_train_dataset = model.prepare_tf_dataset(
    downsampled_dataset["train"],
    collate_fn=data_collator,
    shuffle=True,
    batch_size=32,
)

tf_eval_dataset = model.prepare_tf_dataset(
    downsampled_dataset["test"],
    collate_fn=data_collator,
    shuffle=False,
    batch_size=32,
)
A continuación, configuramos nuestros hiperparámetros de entrenamiento y compilamos nuestro modelo. Usamos la función create_optimizer() de la biblioteca 🤗 Transformers, que nos proporciona un optimizador AdamW con decaimiento lineal de la tasa de aprendizaje. También usamos la pérdida incorporada del modelo, que es la predeterminada cuando no se especifica ninguna pérdida como argumento para compile(), y establecemos la precisión de entrenamiento en "mixed_float16". Ten en cuenta que si estás usando una GPU de Colab u otra GPU que no tiene soporte acelerado para float16, probablemente deberías comentar esa línea.
Además, configuramos un PushToHubCallback que guardará el modelo en el Hub después de cada época. Puedes especificar el nombre del repositorio al que quieres enviar con el argumento hub_model_id (en particular, tendrás que usar este argumento para enviar a una organización). Por ejemplo, para enviar el modelo a la organización huggingface-course, agregamos hub_model_id="huggingface-course/distilbert-finetuned-imdb". Por defecto, el repositorio utilizado estará en tu espacio de nombres y se nombrará según el directorio de salida que establezcas, por lo que en nuestro caso será "lewtun/distilbert-finetuned-imdb".
from transformers import create_optimizer
from transformers.keras_callbacks import PushToHubCallback


num_train_steps = len(tf_train_dataset)
optimizer, schedule = create_optimizer(
    init_lr=2e-5,
    num_warmup_steps=1_000,
    num_train_steps=num_train_steps,
    weight_decay_rate=0.01,
)
model.compile(optimizer=optimizer)

# Train in mixed-precision float16
tf.keras.mixed_precision.set_global_policy("mixed_float16")

model_name = model_checkpoint.split("/")[-1]
callback = PushToHubCallback(
    output_dir=f"{model_name}-finetuned-imdb", tokenizer=tokenizer
)
Ahora estamos listos para ejecutar model.fit(), pero antes de hacerlo, veamos brevemente la perplejidad, que es una métrica común para evaluar el rendimiento de los modelos de lenguaje.
{:else}
Una vez que hayamos iniciado sesión, podemos especificar los argumentos para el Trainer:
from transformers import TrainingArguments

batch_size = 64
# Show the training loss with every epoch
logging_steps = len(downsampled_dataset["train"]) // batch_size
model_name = model_checkpoint.split("/")[-1]

training_args = TrainingArguments(
    output_dir=f"{model_name}-finetuned-imdb",
    overwrite_output_dir=True,
    evaluation_strategy="epoch",
    learning_rate=2e-5,
    weight_decay=0.01,
    per_device_train_batch_size=batch_size,
    per_device_eval_batch_size=batch_size,
    push_to_hub=True,
    fp16=True,
    logging_steps=logging_steps,
)
Aquí ajustamos algunas de las opciones predeterminadas, incluyendo logging_steps para asegurarnos de que rastreamos la pérdida de entrenamiento con cada época. También usamos fp16=True para habilitar el entrenamiento de precisión mixta, lo que nos da otro impulso en la velocidad. Por defecto, el Trainer eliminará cualquier columna que no sea parte del método forward() del modelo. Esto significa que si estás usando el "collator" de enmascaramiento de palabras completas, también necesitarás establecer remove_unused_columns=False para asegurarte de no perder la columna word_ids durante el entrenamiento.
Ten en cuenta que puedes especificar el nombre del repositorio al que quieres enviar con el argumento hub_model_id (en particular, tendrás que usar este argumento para enviar a una organización). Por ejemplo, cuando enviamos el modelo a la organización huggingface-course, agregamos hub_model_id="huggingface-course/distilbert-finetuned-imdb" a TrainingArguments. Por defecto, el repositorio utilizado estará en tu espacio de nombres y se nombrará según el directorio de salida que establezcas, por lo que en nuestro caso será "lewtun/distilbert-finetuned-imdb".
Ahora tenemos todos los ingredientes para instanciar el Trainer. Aquí solo usamos el data_collator estándar, pero puedes probar el "collator" de enmascaramiento de palabras completas y comparar los resultados como un ejercicio:
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=downsampled_dataset["train"],
    eval_dataset=downsampled_dataset["test"],
    data_collator=data_collator,
    tokenizer=tokenizer,
)
Ahora estamos listos para ejecutar trainer.train(), pero antes de hacerlo, veamos brevemente la perplejidad, que es una métrica común para evaluar el rendimiento de los modelos de lenguaje.
{/if}
Perplejidad para modelos de lenguaje[[perplexity-for-language-models]]
A diferencia de otras tareas como la clasificación de texto o la respuesta a preguntas, donde se nos da un corpus etiquetado para entrenar, con el modelado de lenguaje no tenemos etiquetas explícitas. Entonces, ¿cómo determinamos qué hace que un modelo de lenguaje sea bueno? Al igual que con la función de autocorrección de tu teléfono, un buen modelo de lenguaje es aquel que asigna altas probabilidades a oraciones gramaticalmente correctas y bajas probabilidades a oraciones sin sentido. Para darte una mejor idea de cómo se ve esto, puedes encontrar conjuntos completos de "fallos de autocorrección" en línea, ¡donde el modelo del teléfono de una persona ha producido algunas terminaciones bastante divertidas (y a menudo inapropiadas)!
{#if fw === 'pt'}
Suponiendo que nuestro conjunto de prueba consiste principalmente en oraciones gramaticalmente correctas, entonces una forma de medir la calidad de nuestro modelo de lenguaje es calcular las probabilidades que asigna a la siguiente palabra en todas las oraciones del conjunto de prueba. Las altas probabilidades indican que el modelo no está "sorprendido" o "perplejo" por los ejemplos no vistos, y sugiere que ha aprendido los patrones básicos de la gramática en el lenguaje. Hay varias definiciones matemáticas de perplejidad, pero la que usaremos la define como el exponencial de la pérdida de entropía cruzada. Por lo tanto, podemos calcular la perplejidad de nuestro modelo preentrenado usando la función Trainer.evaluate() para calcular la pérdida de entropía cruzada en el conjunto de prueba y luego tomando el exponencial del resultado:
eval_results = trainer.evaluate()
print(f">>> Perplexity: {math.exp(eval_results['eval_loss']):.2f}")
{:else}
Suponiendo que nuestro conjunto de prueba consiste principalmente en oraciones gramaticalmente correctas, entonces una forma de medir la calidad de nuestro modelo de lenguaje es calcular las probabilidades que asigna a la siguiente palabra en todas las oraciones del conjunto de prueba. Las altas probabilidades indican que el modelo no está "sorprendido" o "perplejo" por los ejemplos no vistos, y sugiere que ha aprendido los patrones básicos de la gramática en el lenguaje. Hay varias definiciones matemáticas de perplejidad, pero la que usaremos la define como el exponencial de la pérdida de entropía cruzada. Por lo tanto, podemos calcular la perplejidad de nuestro modelo preentrenado usando el método model.evaluate() para calcular la pérdida de entropía cruzada en el conjunto de prueba y luego tomando el exponencial del resultado:
eval_loss = model.evaluate(tf_eval_dataset)
print(f"Perplexity: {math.exp(eval_loss):.2f}")
{/if}
>>> Perplexity: 21.75
Una puntuación de perplejidad más baja significa un mejor modelo de lenguaje, y aquí podemos ver que nuestro modelo inicial tiene un valor algo grande. ¡Veamos si podemos reducirlo haciendo fine-tuning! Para ello, primero ejecutamos el bucle de entrenamiento:
{#if fw === 'pt'}
trainer.train()
{:else}
model.fit(tf_train_dataset, validation_data=tf_eval_dataset, callbacks=[callback])
{/if}
y luego calculamos la perplejidad resultante en el conjunto de prueba como antes:
{#if fw === 'pt'}
eval_results = trainer.evaluate()
print(f">>> Perplexity: {math.exp(eval_results['eval_loss']):.2f}")
{:else}
eval_loss = model.evaluate(tf_eval_dataset)
print(f"Perplexity: {math.exp(eval_loss):.2f}")
{/if}
>>> Perplexity: 11.32
¡Genial, esta es una reducción considerable en la perplejidad, lo que nos dice que el modelo ha aprendido algo sobre el dominio de las reseñas de películas!
{#if fw === 'pt'}
Una vez finalizado el entrenamiento, podemos enviar la tarjeta del modelo con la información de entrenamiento al Hub (los checkpoints se guardan durante el propio entrenamiento):
trainer.push_to_hub()
{/if}
[!TIP] ✏️ ¡Tu turno! Ejecuta el entrenamiento anterior después de cambiar el "data collator" al "collator" de enmascaramiento de palabras completas. ¿Obtienes mejores resultados?
{#if fw === 'pt'}
En nuestro caso de uso no necesitamos hacer nada especial con el bucle de entrenamiento, pero en algunos casos es posible que necesites implementar alguna lógica personalizada. Para estas aplicaciones, puedes usar 🤗 Accelerate, ¡echemos un vistazo!
Ajuste fino de DistilBERT con 🤗 Accelerate[[fine-tuning-distilbert-with-accelerate]]
Como vimos con el Trainer, el ajuste fino de un modelo de lenguaje enmascarado es muy similar al ejemplo de clasificación de texto del Capítulo 3. De hecho, la única sutileza es el uso de un recopilador de datos especial, ¡y eso ya lo cubrimos anteriormente en esta sección!
Sin embargo, vimos que DataCollatorForLanguageModeling también aplica enmascaramiento aleatorio con cada evaluación, por lo que veremos algunas fluctuaciones en nuestros puntajes de perplejidad con cada ejecución de entrenamiento. Una forma de eliminar esta fuente de aleatoriedad es aplicar el enmascaramiento una vez en todo el conjunto de prueba y luego usar el recopilador de datos predeterminado en 🤗 Transformers para recopilar los lotes durante la evaluación. Para ver cómo funciona esto, implementemos una función simple que aplique el enmascaramiento en un lote, similar a nuestro primer encuentro con DataCollatorForLanguageModeling:
def insert_random_mask(batch):
    features = [dict(zip(batch, t)) for t in zip(*batch.values())]
    masked_inputs = data_collator(features)
    # Create a new "masked" column for each column in the dataset
    return {"masked_" + k: v.numpy() for k, v in masked_inputs.items()}
Luego, aplicaremos esta función a nuestro conjunto de prueba y eliminaremos las columnas sin enmascarar para poder reemplazarlas con las enmascaradas. Puedes usar el enmascaramiento de palabras completas reemplazando el data_collator anterior con el apropiado, en cuyo caso deberías eliminar la primera línea aquí:
downsampled_dataset = downsampled_dataset.remove_columns(["word_ids"])
eval_dataset = downsampled_dataset["test"].map(
    insert_random_mask,
    batched=True,
    remove_columns=downsampled_dataset["test"].column_names,
)
eval_dataset = eval_dataset.rename_columns(
    {
        "masked_input_ids": "input_ids",
        "masked_attention_mask": "attention_mask",
        "masked_labels": "labels",
    }
)
Luego podemos configurar los cargadores de datos como de costumbre, pero usaremos el default_data_collator de 🤗 Transformers para el conjunto de evaluación:
from torch.utils.data import DataLoader
from transformers import default_data_collator

batch_size = 64
train_dataloader = DataLoader(
    downsampled_dataset["train"],
    shuffle=True,
    batch_size=batch_size,
    collate_fn=data_collator,
)
eval_dataloader = DataLoader(
    eval_dataset, batch_size=batch_size, collate_fn=default_data_collator
)
A partir de aquí, seguimos los pasos estándar con 🤗 Accelerate. Lo primero es cargar una versión nueva del modelo preentrenado:
model = AutoModelForMaskedLM.from_pretrained(model_checkpoint)
Luego necesitamos especificar el optimizador; usaremos el estándar AdamW:
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=5e-5)
Con estos objetos, ahora podemos preparar todo para el entrenamiento con el objeto Accelerator:
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
Ahora que nuestro modelo, optimizador y cargadores de datos están configurados, podemos especificar el programador de la tasa de aprendizaje de la siguiente manera:
from transformers import get_scheduler

num_train_epochs = 3
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
Solo queda una última cosa por hacer antes de entrenar: ¡crear un repositorio de modelos en Hugging Face Hub! Podemos usar la biblioteca 🤗 Hub para generar primero el nombre completo de nuestro repositorio:
from huggingface_hub import get_full_repo_name

model_name = "distilbert-base-uncased-finetuned-imdb-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'lewtun/distilbert-base-uncased-finetuned-imdb-accelerate'
luego crear y clonar el repositorio usando la clase Repository de 🤗 Hub:
from huggingface_hub import Repository

output_dir = model_name
repo = Repository(output_dir, clone_from=repo_name)
Hecho esto, es simplemente cuestión de escribir el ciclo completo de entrenamiento y evaluación:
from tqdm.auto import tqdm


progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # Training
    model.train()
    for batch in train_dataloader:
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # Evaluation
    model.eval()
    losses = []
    for step, batch in enumerate(eval_dataloader):
        with torch.no_grad():
            outputs = model(**batch)

        loss = outputs.loss
        losses.append(accelerator.gather(loss.repeat(batch_size)))

    losses = torch.cat(losses)
    losses = losses[: len(eval_dataset)]
    try:
        perplexity = math.exp(torch.mean(losses))
    except OverflowError:
        perplexity = float("inf")

    print(f">>> Epoch {epoch}: Perplexity: {perplexity}")

    # Save and upload
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
>>> Epoch 0: Perplexity: 11.397545307900472
>>> Epoch 1: Perplexity: 10.904909330983092
>>> Epoch 2: Perplexity: 10.729503505340409
¡Genial, hemos podido evaluar la perplejidad con cada época y asegurarnos de que múltiples ejecuciones de entrenamiento sean reproducibles!
{/if}
Uso de nuestro modelo ajustado[[using-our-fine-tuned-model]]
Puedes interactuar con tu modelo ajustado usando su widget en el Hub o localmente con el pipeline de 🤗 Transformers. Usemos este último para descargar nuestro modelo usando el pipeline fill-mask:
from transformers import pipeline

mask_filler = pipeline(
    "fill-mask", model="huggingface-course/distilbert-base-uncased-finetuned-imdb"
)
Luego podemos alimentar el pipeline con nuestro texto de ejemplo de "This is a great [MASK]" y ver cuáles son las 5 predicciones principales:
preds = mask_filler(text)

for pred in preds:
    print(f">>> {pred['sequence']}")
'>>> this is a great movie.'
'>>> this is a great film.'
'>>> this is a great story.'
'>>> this is a great movies.'
'>>> this is a great character.'
¡Qué bien, nuestro modelo ha adaptado claramente sus pesos para predecir palabras que están más fuertemente asociadas con películas!
Esto concluye nuestro primer experimento con el entrenamiento de un modelo de lenguaje. En la sección 6 aprenderás a entrenar un modelo autorregresivo como GPT-2 desde cero; dirígete allí si quieres ver cómo puedes preentrenar tu propio modelo Transformer.
[!TIP] ✏️ ¡Pruébalo! Para cuantificar los beneficios de la adaptación de dominio, ajusta un clasificador en las etiquetas de IMDb tanto para los puntos de control de DistilBERT preentrenados como para los ajustados. Si necesitas un repaso sobre la clasificación de texto, consulta el Capítulo 3.