DeepSeek R1: Un curso intensivo de lectura de artículos
Este capítulo es un curso intensivo de lectura de artículos. Analizaremos el artículo en términos sencillos y luego desglosaremos los conceptos clave y las conclusiones.
DeepSeek R1 representa un avance significativo en el entrenamiento de modelos de lenguaje, particularmente en el desarrollo de capacidades de razonamiento a través del aprendizaje por refuerzo. El artículo introduce un nuevo algoritmo de aprendizaje por refuerzo llamado Group Relative Policy Optimization (GRPO).
En el próximo capítulo, construiremos sobre este conocimiento e implementaremos GRPO en la práctica.
El objetivo inicial del artículo era explorar si el aprendizaje por refuerzo puro podía desarrollar capacidades de razonamiento sin un fine-tuning supervisado.
[!TIP] Hasta ese momento, todos los LLM populares requerían algún fine-tuning supervisado, lo cual exploramos en el capítulo 11.
El momento 'Ajá' del descubrimiento
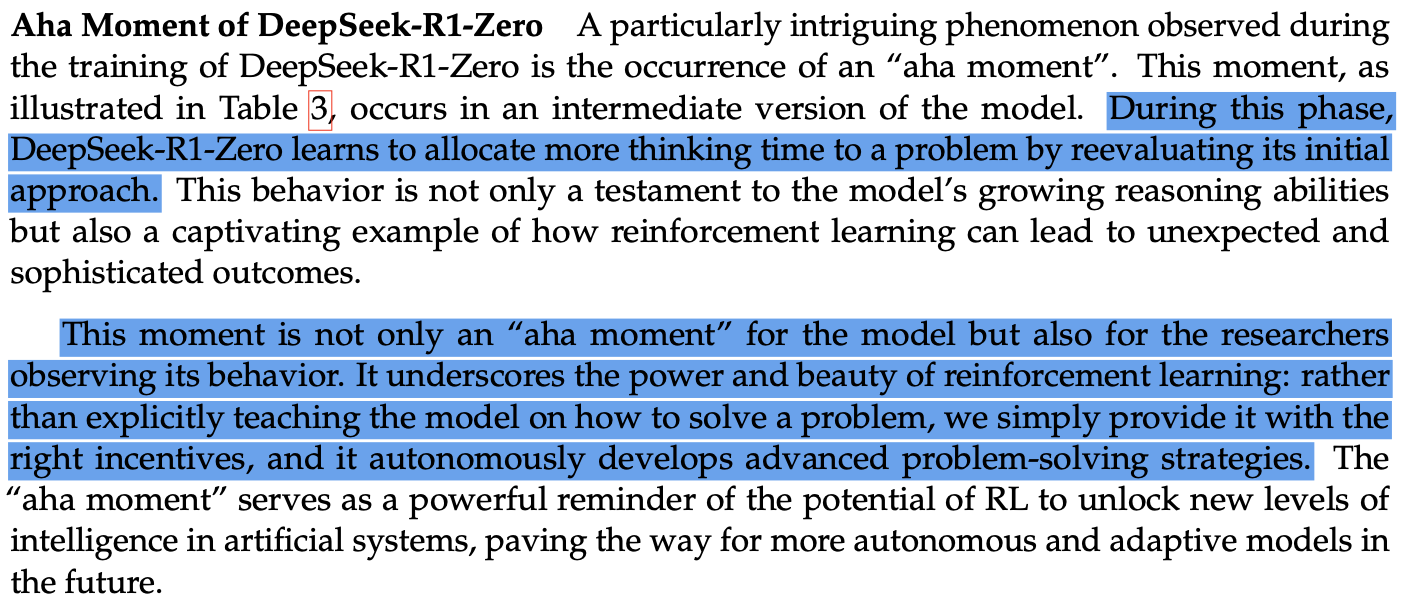
Uno de los descubrimientos más notables en el entrenamiento de R1-Zero fue el surgimiento de un fenómeno conocido como el "Momento Ajá". Este fenómeno es algo similar a cómo los humanos experimentan realizaciones repentinas al resolver problemas. Así es como funciona:
- Intento inicial: El modelo hace un intento inicial de resolver un problema.
- Reconocimiento: Reconoce posibles errores o inconsistencias.
- Autocorrección: Ajusta su enfoque basándose en este reconocimiento.
- Explicación: Puede explicar por qué el nuevo enfoque es mejor.
Este avance resuena con los estudiantes y se siente como un momento "Eureka". Demuestra aprendizaje en lugar de mera memorización, así que tomemos un momento para imaginar lo que se siente tener un momento "Ajá".
Por ejemplo, imagina que estás tratando de resolver un rompecabezas:
- Primer intento: "Esta pieza debería ir aquí basándose en el color".
- Reconocimiento: "Pero espera, la forma no encaja del todo".
- Corrección: "Ah, en realidad pertenece allí".
- Explicación: "Porque tanto el color como el patrón de forma coinciden en esta posición".
Esta habilidad surgió naturalmente del entrenamiento de RL, sin ser programada explícitamente, demostrando aprendizaje en lugar de mera memorización de un proceso a partir de los datos de entrenamiento.
La forma más fácil de entender el momento 'Ajá' es verlo en acción. Echemos un vistazo a un ejemplo. En el chat a continuación, le pedimos al modelo que resuelva un problema y la interfaz de usuario muestra el proceso de pensamiento del modelo mientras resuelve el problema.
Si quieres probar Deepseek's R1, también puedes visitar Hugging Chat.
El proceso de entrenamiento
El entrenamiento de R1 fue un proceso multifase. Desglosemos las fases y las innovaciones clave en cada una.
El proceso final da como resultado dos modelos:
- DeepSeek-R1-Zero: Un modelo entrenado puramente usando aprendizaje por refuerzo.
- DeepSeek-R1: Un modelo que se basa en la fundación de DeepSeek-R1-Zero y añade fine-tuning supervisado.
| Característica | DeepSeek-R1-Zero | DeepSeek-R1 |
|---|---|---|
| Enfoque de entrenamiento | RL puro | Multifase (SFT + RL) |
| Fine-tuning | Ninguno | Fine-tuning supervisado |
| Capacidad de razonamiento | Emergente | Mejorada |
| Rendimiento AIME | 71.0% | 79.8% |
| Características clave | Fuerte razonamiento pero problemas de legibilidad | Mejor consistencia y legibilidad del lenguaje |
Mientras que DeepSeek-R1-Zero demuestra el potencial del aprendizaje por refuerzo puro para desarrollar capacidades de razonamiento, DeepSeek-R1 se basa en esta fundación con un enfoque más equilibrado que prioriza tanto el rendimiento del razonamiento como la usabilidad.
El proceso de entrenamiento implica cuatro fases:
- Fase de arranque en frío
- Fase de RL de razonamiento
- Fase de muestreo por rechazo
- Fase de RL diversa
Desglosemos cada fase:
Fase de arranque en frío (Fundación de calidad)
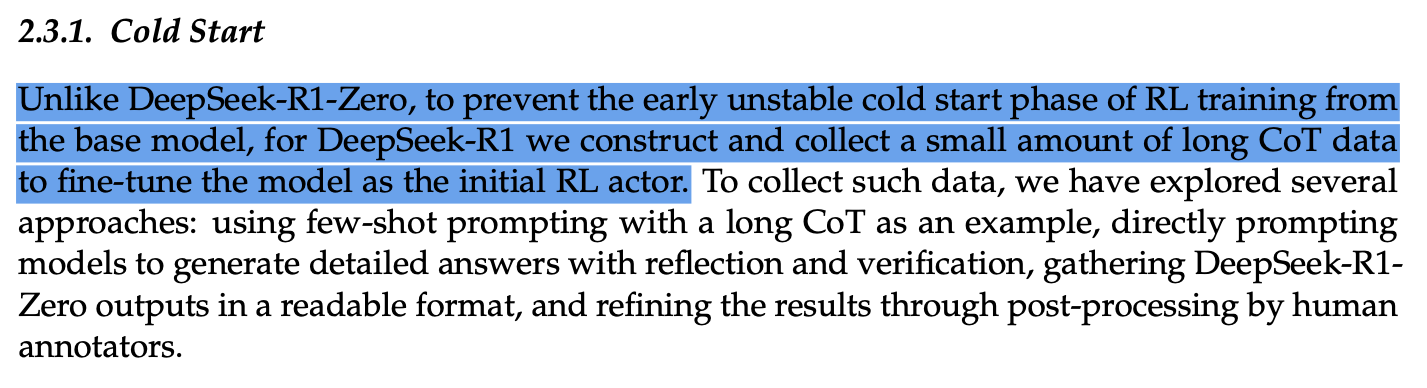
Esta fase está diseñada para establecer una base sólida para la legibilidad y la calidad de respuesta del modelo. Utiliza un pequeño conjunto de datos de muestras de alta calidad de R1-Zero para realizar un fine-tuning del modelo V3-Base. Comenzando con el modelo DeepSeek-V3-Base, el equipo utilizó miles de muestras validadas y de alta calidad de R1-Zero para el fine-tuning supervisado. Este enfoque innovador utiliza un conjunto de datos pequeño pero de alta calidad para establecer una fuerte legibilidad de referencia y calidad de respuesta.
Fase de RL de razonamiento (Desarrollo de capacidades)
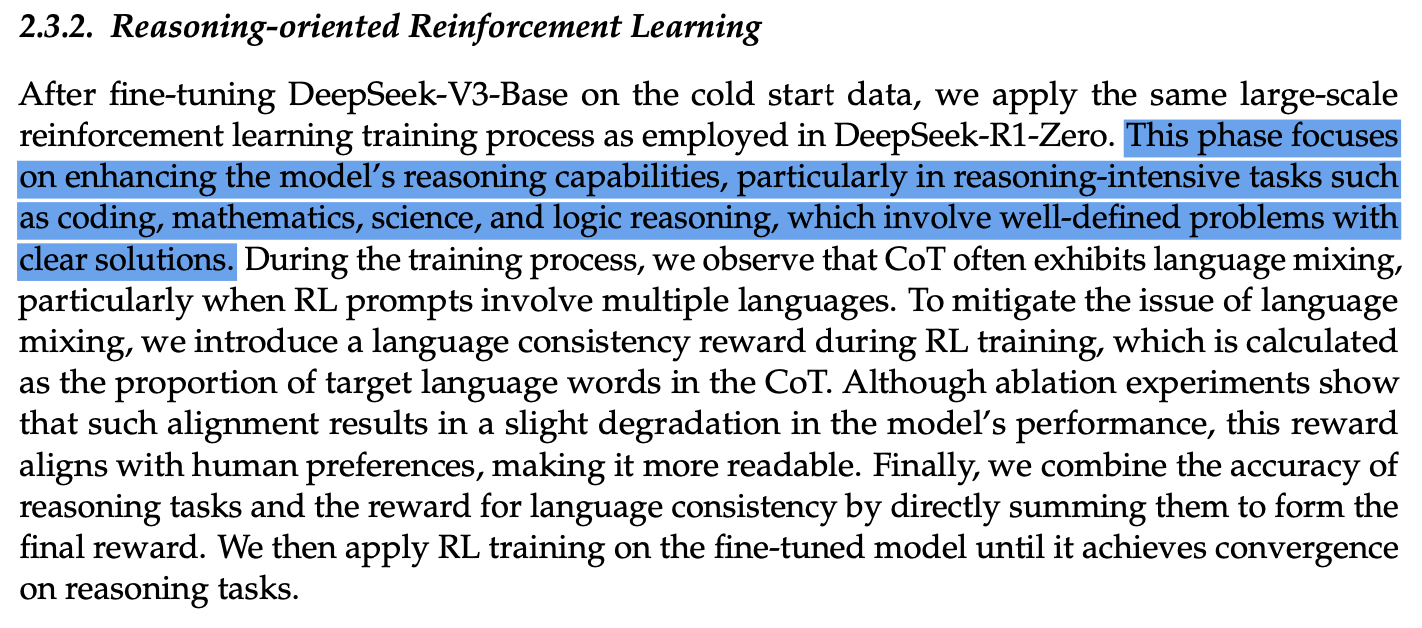
La fase de RL de razonamiento se centra en desarrollar capacidades de razonamiento centrales en dominios que incluyen matemáticas, codificación, ciencia y lógica. Esta fase emplea aprendizaje por refuerzo basado en reglas, con recompensas directamente vinculadas a la corrección de la solución.
Crucialmente, todas las tareas en esta fase son 'verificables', por lo que podemos comprobar si la respuesta del modelo es correcta o no. Por ejemplo, en el caso de las matemáticas, podemos comprobar si la respuesta del modelo es correcta utilizando un solucionador matemático.
Lo que hace que esta fase sea particularmente innovadora es su enfoque de optimización directa que elimina la necesidad de un modelo de recompensa separado, agilizando el proceso de entrenamiento.
Fase de muestreo por rechazo (Control de calidad)
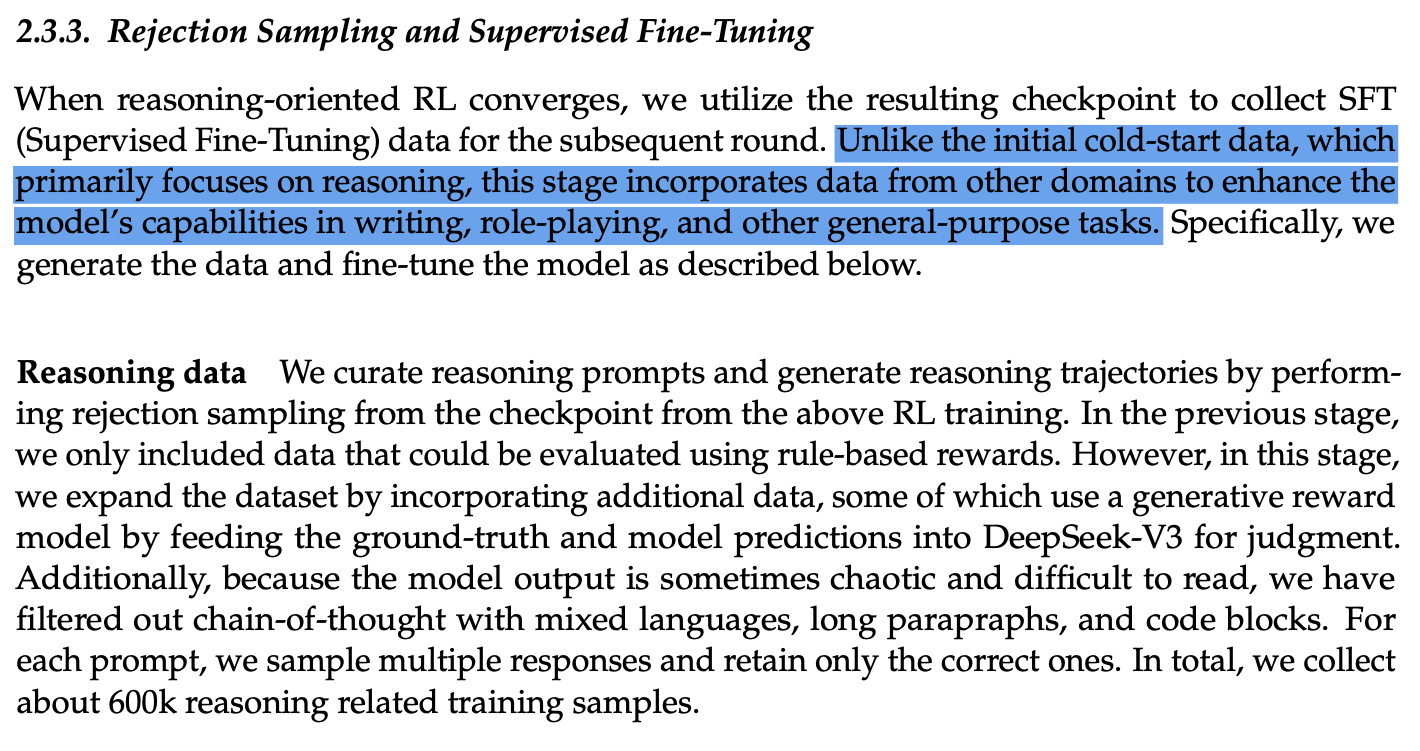
Durante la fase de muestreo por rechazo, el modelo genera muestras que luego se filtran a través de un proceso de control de calidad. DeepSeek-V3 sirve como juez de calidad, evaluando las salidas en un amplio alcance que se extiende más allá de las tareas de razonamiento puro. Los datos filtrados se utilizan luego para el fine-tuning supervisado. La innovación de esta fase radica en su capacidad para combinar múltiples señales de calidad para garantizar salidas de alto nivel.
Fase de RL diversa (Alineación amplia)
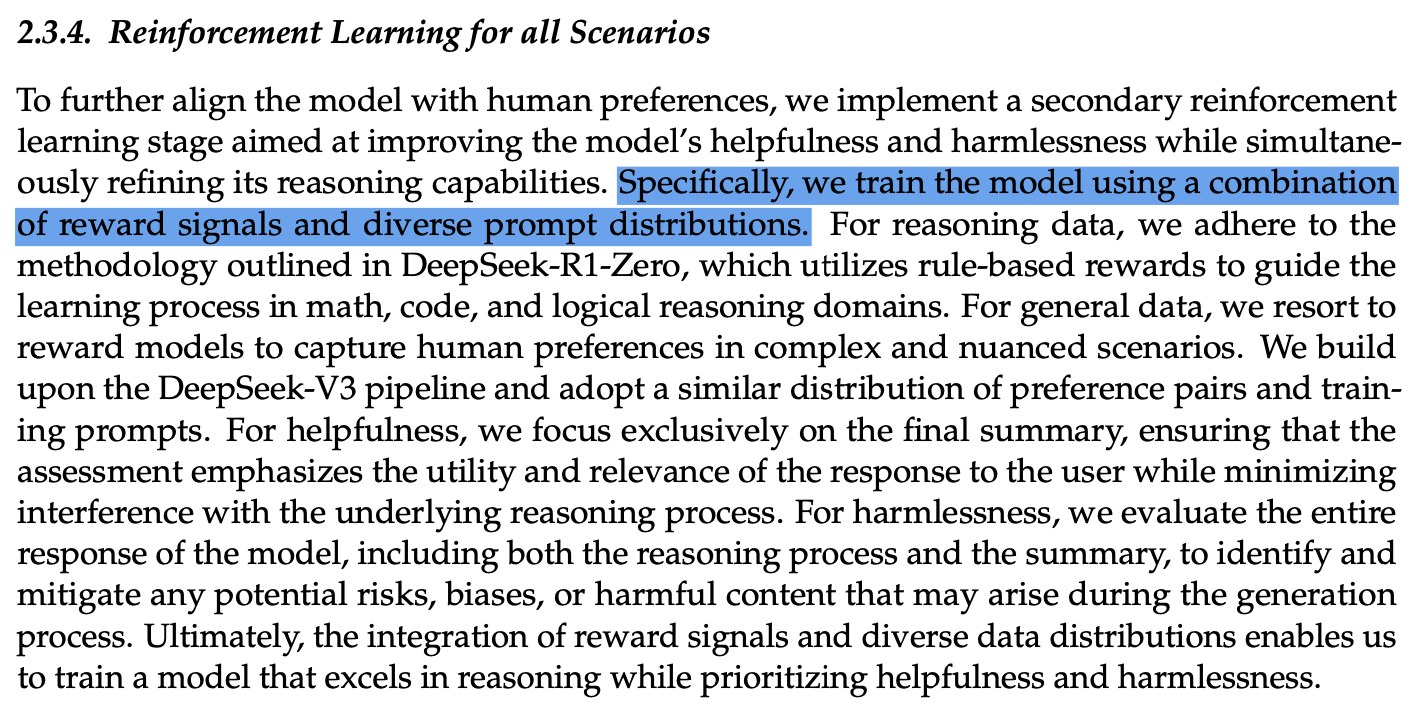
La fase final de RL diversa aborda múltiples tipos de tareas utilizando un sofisticado enfoque híbrido. Para tareas deterministas, emplea recompensas basadas en reglas, mientras que las tareas subjetivas se evalúan a través de la retroalimentación del LLM. Esta fase tiene como objetivo lograr la alineación con las preferencias humanas a través de su innovador enfoque de recompensa híbrido, combinando la precisión de los sistemas basados en reglas con la flexibilidad de la evaluación del modelo de lenguaje.
El algoritmo: Group Relative Policy Optimization (GRPO)
Ahora que tenemos una buena comprensión del proceso de entrenamiento, veamos el algoritmo que se utilizó para entrenar el modelo.
Los autores describen GRPO como un avance en el fine-tuning de modelos:
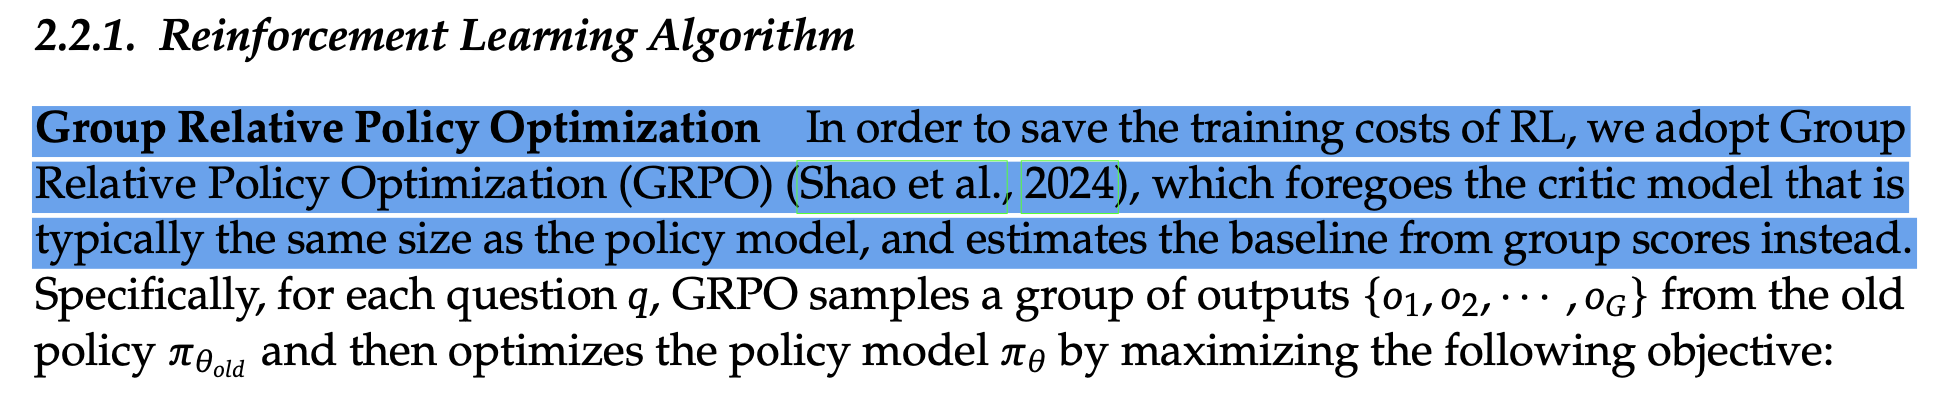
La novedad de GRPO radica en su capacidad para "optimizar directamente la rectificación de preferencias". Esto significa una ruta más directa y eficiente para alinear el modelo con los resultados deseados, en contraste con los algoritmos de aprendizaje por refuerzo tradicionales como PPO. Desglosemos cómo funciona GRPO a través de sus tres componentes principales.
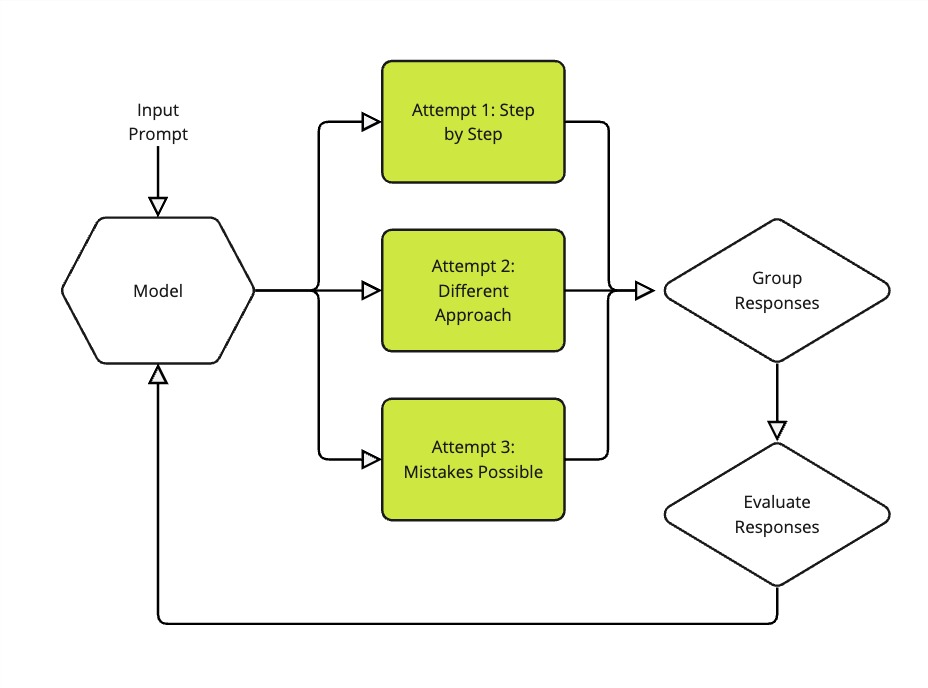
Formación de grupos: Creación de múltiples soluciones
El primer paso en GRPO es notablemente intuitivo, es similar a cómo un estudiante podría resolver un problema difícil probando múltiples enfoques. Cuando se le da un prompt, el modelo no solo genera una respuesta; en cambio, crea múltiples intentos de resolver el mismo problema (generalmente 4, 8 o 16 intentos diferentes).
Imagina que estás enseñando a un modelo a resolver problemas de matemáticas. Para una pregunta sobre contar gallinas en una granja, el modelo podría generar varias soluciones diferentes:
- Una solución podría desglosar el problema paso a paso: primero contando el total de gallinas, luego restando los gallos y finalmente contabilizando las gallinas que no ponen huevos.
- Otra podría usar un enfoque diferente pero igualmente válido.
- Algunos intentos podrían contener errores o soluciones menos eficientes.
Todos estos intentos se mantienen juntos como un grupo, muy parecido a tener las soluciones de varios estudiantes para comparar y aprender de ellas.
Aprendizaje de preferencias: Entender qué hace una buena solución
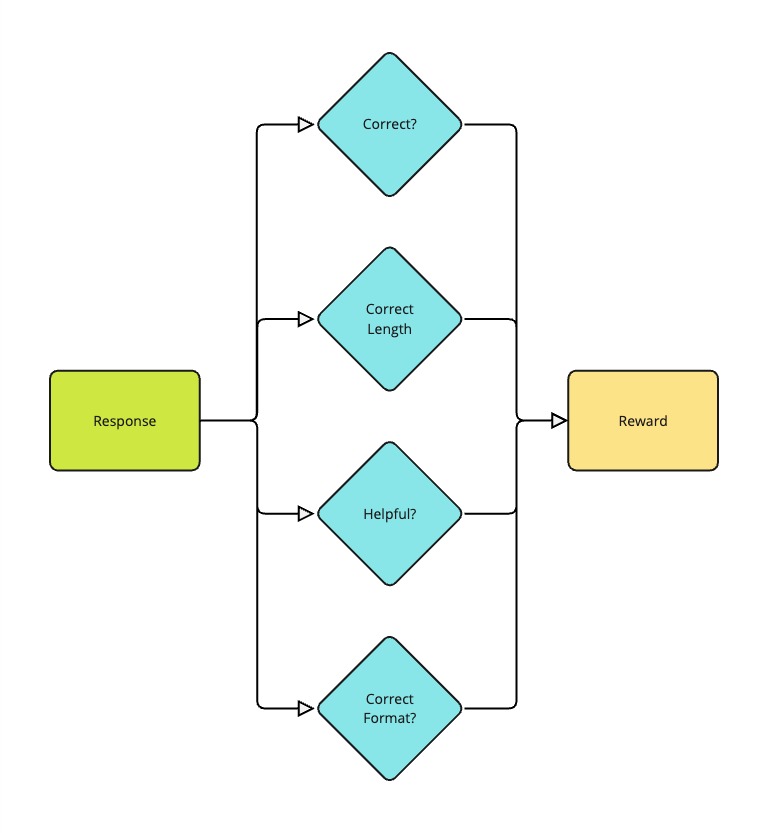
Aquí es donde GRPO realmente brilla por su simplicidad. A diferencia de otros métodos para RLHF que siempre requieren un modelo de recompensa separado para predecir qué tan buena podría ser una solución, GRPO puede usar cualquier función o modelo para evaluar la calidad de una solución. Por ejemplo, podríamos usar una función de longitud para recompensar respuestas más cortas o un solucionador matemático para recompensar soluciones matemáticas precisas.
El proceso de evaluación considera varios aspectos de cada solución:
- ¿Es correcta la respuesta final?
- ¿La solución siguió el formato adecuado (como usar las etiquetas XML correctas)?
- ¿El razonamiento coincide con la respuesta proporcionada?
Lo que hace que este enfoque sea particularmente inteligente es cómo maneja la puntuación. En lugar de solo dar puntuaciones absolutas, GRPO normaliza las recompensas dentro de cada grupo. Utiliza una fórmula simple pero efectiva para la estimación de la ventaja relativa del grupo:
Advantage = (reward - mean(group_rewards)) / std(group_rewards)
Esta normalización es como calificar en una curva, pero para la IA. Ayuda al modelo a comprender qué soluciones dentro del grupo fueron mejores o peores en comparación con sus pares, en lugar de solo mirar las puntuaciones absolutas.
Optimización: Aprendiendo de la experiencia
El paso final es donde GRPO enseña al modelo a mejorar basándose en lo que aprendió al evaluar el grupo de soluciones. Este proceso es potente y estable, utilizando dos principios principales:
- Anima al modelo a producir más soluciones como las exitosas, mientras se aleja de enfoques menos efectivos.
- Incluye un mecanismo de seguridad (llamado penalización de divergencia KL) que evita que el modelo cambie drásticamente de una sola vez.
Este enfoque resulta más estable que los métodos tradicionales porque:
- Considera múltiples soluciones juntas en lugar de comparar solo dos a la vez.
- La normalización basada en grupos ayuda a prevenir problemas con el escalado de recompensas.
- La penalización KL actúa como una red de seguridad, asegurando que el modelo no olvide lo que ya sabe mientras aprende cosas nuevas.
[!TIP] Las innovaciones clave de GRPO son:
- Aprender directamente de cualquier función o modelo, eliminando la dependencia de un modelo de recompensa separado.
- Aprendizaje basado en grupos, que es más estable y eficiente que los métodos tradicionales como las comparaciones por pares.
Este desglose es complejo, pero la conclusión clave es que GRPO es una forma más eficiente y estable de entrenar un modelo para razonar.
Algoritmo GRPO en pseudocódigo
Ahora que entendemos los componentes clave de GRPO, veamos el algoritmo en pseudocódigo. Esta es una versión simplificada del algoritmo, pero captura las ideas clave.
Input:
- initial_policy: Starting model to be trained
- reward_function: Function that evaluates outputs
- training_prompts: Set of training examples
- group_size: Number of outputs per prompt (typically 4-16)

Algorithm GRPO:
1. For each training iteration:
   a. Set reference_policy = initial_policy (snapshot current policy)
   b. For each prompt in batch:
      i. Generate group_size different outputs using initial_policy
      ii. Compute rewards for each output using reward_function
      iii. Normalize rewards within group:
           normalized_advantage = (reward - mean(rewards)) / std(rewards)
      iv. Update policy by maximizing the clipped ratio:
          min(prob_ratio * normalized_advantage,
              clip(prob_ratio, 1-epsilon, 1+epsilon) * normalized_advantage)
          - kl_weight * KL(initial_policy || reference_policy)

          where prob_ratio is current_prob / reference_prob

Output: Optimized policy model
Este algoritmo muestra cómo GRPO combina la estimación de ventajas basada en grupos con la optimización de políticas, manteniendo la estabilidad a través del recorte y las restricciones de divergencia KL.
Resultados e impacto
Ahora que hemos explorado el algoritmo, veamos los resultados. DeepSeek R1 logra un rendimiento de vanguardia en múltiples dominios:
| Dominio | Resultados clave |
|---|---|
| Matemáticas | • 79.8% en AIME 2024 • 97.3% en MATH-500 |
| Codificación | • Calificación Codeforces: 2029 • LiveCodeBench: 65.9% |
| Conocimiento general | • MMLU: 90.8% • GPQA Diamond: 71.5% |
| Tareas de lenguaje | • Tasa de victorias en AlpacaEval 2.0: 87.6% • FRAMES: 82.5% |
El impacto práctico del modelo se extiende más allá de los benchmarks a través de su precio de API rentable ($0.14 por millón de tokens de entrada) y la destilación exitosa del modelo en varios tamaños (de 1.5B a 70B parámetros). Notablemente, incluso el modelo de 7B logra un 55.5% en AIME 2024, mientras que la versión destilada de 70B se acerca al rendimiento de o1-mini en MATH-500 (94.5%), demostrando una preservación efectiva de la capacidad en diferentes escalas.
Limitaciones y desafíos de GRPO
Si bien GRPO representa un avance significativo en el aprendizaje por refuerzo para modelos de lenguaje, es importante comprender sus limitaciones y desafíos:
- Costo de generación: Generar múltiples completaciones (4-16) para cada prompt aumenta los requisitos computacionales en comparación con los métodos que generan solo una o dos completaciones.
- Restricciones de tamaño de lote: La necesidad de procesar grupos de completaciones juntas puede limitar los tamaños de lote efectivos, lo que añade complejidad al proceso de entrenamiento y potencialmente lo ralentiza.
- Diseño de la función de recompensa: La calidad del entrenamiento depende en gran medida de funciones de recompensa bien diseñadas. Las recompensas mal diseñadas pueden llevar a comportamientos no deseados o a la optimización para objetivos incorrectos.
- Compensaciones del tamaño del grupo: Elegir el tamaño óptimo del grupo implica equilibrar la diversidad de soluciones con el costo computacional. Muy pocas muestras pueden no proporcionar suficiente diversidad, mientras que demasiadas aumentan el tiempo de entrenamiento y los requisitos de recursos.
- Ajuste de la divergencia KL: Encontrar el equilibrio adecuado para la penalización de divergencia KL requiere un ajuste cuidadoso: si es demasiado alta, el modelo no aprenderá de manera efectiva; si es demasiado baja, puede desviarse demasiado de sus capacidades iniciales.
Conclusión
El artículo DeepSeek R1 representa un hito significativo en el desarrollo de modelos de lenguaje. El algoritmo Group Relative Policy Optimization (GRPO) ha demostrado que el aprendizaje por refuerzo puro puede desarrollar sólidas capacidades de razonamiento, desafiando suposiciones previas sobre la necesidad del fine-tuning supervisado.
Quizás lo más importante es que DeepSeek R1 ha demostrado que es posible equilibrar el alto rendimiento con consideraciones prácticas como la rentabilidad y la accesibilidad. La destilación exitosa de las capacidades del modelo en diferentes tamaños, desde 1.5B hasta 70B parámetros, demuestra un camino a seguir para hacer que las capacidades avanzadas de IA estén más ampliamente disponibles.
En la siguiente sección, exploraremos implementaciones prácticas de estos conceptos, centrándonos en cómo aprovechar GRPO y RFTrans en tus propios proyectos de desarrollo de modelos de lenguaje.