Cómo los modelos Transformer resuelven tareas
En Transformers, ¿qué pueden hacer?, aprendiste sobre el procesamiento del lenguaje natural (PNL), tareas de voz y audio, visión por computadora y algunas de sus aplicaciones importantes. Esta página analizará de cerca cómo los modelos resuelven estas tareas y explicará lo que sucede internamente. Hay muchas maneras de resolver una tarea determinada; algunos modelos pueden implementar ciertas técnicas o incluso abordar la tarea desde un nuevo ángulo, pero para los modelos Transformer, la idea general es la misma. Debido a su arquitectura flexible, la mayoría de los modelos son una variante de una estructura de codificador, decodificador o codificador-decodificador.
[!TIP] Antes de sumergirte en variantes arquitectónicas específicas, es útil comprender que la mayoría de las tareas siguen un patrón similar: los datos de entrada se procesan a través de un modelo y la salida se interpreta para una tarea específica. Las diferencias radican en cómo se preparan los datos, qué variante de arquitectura de modelo se utiliza y cómo se procesa la salida.
Para explicar cómo se resuelven las tareas, analizaremos lo que sucede dentro del modelo para generar predicciones útiles. Cubriremos los siguientes modelos y sus tareas correspondientes:
- Wav2Vec2 para clasificación de audio y reconocimiento automático de voz (ASR)
- Vision Transformer (ViT) y ConvNeXT para clasificación de imágenes
- DETR para detección de objetos
- Mask2Former para segmentación de imágenes
- GLPN para estimación de profundidad
- BERT para tareas de PNL como clasificación de texto, clasificación de tokens y respuesta a preguntas que usan un codificador
- GPT2 para tareas de PNL como generación de texto que usan un decodificador
- BART para tareas de PNL como resumen y traducción que usan un codificador-decodificador
[!TIP] Antes de continuar, es bueno tener algunos conocimientos básicos de la arquitectura original de Transformer. Saber cómo funcionan los codificadores, decodificadores y la atención te ayudará a comprender cómo funcionan los diferentes modelos Transformer. ¡Asegúrate de revisar nuestra sección anterior para obtener más información!
Modelos Transformer para el lenguaje
Los modelos de lenguaje son el corazón de la PNL moderna. Están diseñados para comprender y generar lenguaje humano aprendiendo los patrones estadísticos y las relaciones entre palabras o tokens en el texto.
El Transformer fue diseñado inicialmente para la traducción automática, y desde entonces se ha convertido en la arquitectura predeterminada para resolver todas las tareas de IA. Algunas tareas se prestan a la estructura de codificador del Transformer, mientras que otras son más adecuadas para el decodificador. Aun así, otras tareas utilizan la estructura de codificador-decodificador del Transformer.
Cómo funcionan los modelos de lenguaje
Los modelos de lenguaje funcionan al ser entrenados para predecir la probabilidad de una palabra dado el contexto de las palabras circundantes. Esto les da una comprensión fundamental del lenguaje que puede generalizarse a otras tareas.
Hay dos enfoques principales para entrenar un modelo Transformer:
Modelado de lenguaje enmascarado (MLM): Utilizado por modelos codificadores como BERT, este enfoque enmascara aleatoriamente algunos tokens en la entrada y entrena el modelo para predecir los tokens originales basándose en el contexto circundante. Esto permite que el modelo aprenda un contexto bidireccional (observando palabras tanto antes como después de la palabra enmascarada).
Modelado de lenguaje causal (CLM): Utilizado por modelos decodificadores como GPT, este enfoque predice el siguiente token basándose en todos los tokens anteriores en la secuencia. El modelo solo puede usar el contexto de la izquierda (tokens anteriores) para predecir el siguiente token.
Tipos de modelos de lenguaje
En la biblioteca Transformers, los modelos de lenguaje generalmente se dividen en tres categorías arquitectónicas:
Modelos solo codificador (como BERT): Estos modelos utilizan un enfoque bidireccional para comprender el contexto desde ambas direcciones. Son los más adecuados para tareas que requieren una comprensión profunda del texto, como clasificación, reconocimiento de entidades nombradas y respuesta a preguntas.
Modelos solo decodificador (como GPT, Llama): Estos modelos procesan el texto de izquierda a derecha y son particularmente buenos en tareas de generación de texto. Pueden completar oraciones, escribir ensayos o incluso generar código basándose en un prompt.
Modelos codificador-decodificador (como T5, BART): Estos modelos combinan ambos enfoques, utilizando un codificador para comprender la entrada y un decodificador para generar la salida. Sobresalen en tareas de secuencia a secuencia como traducción, resumen y respuesta a preguntas.
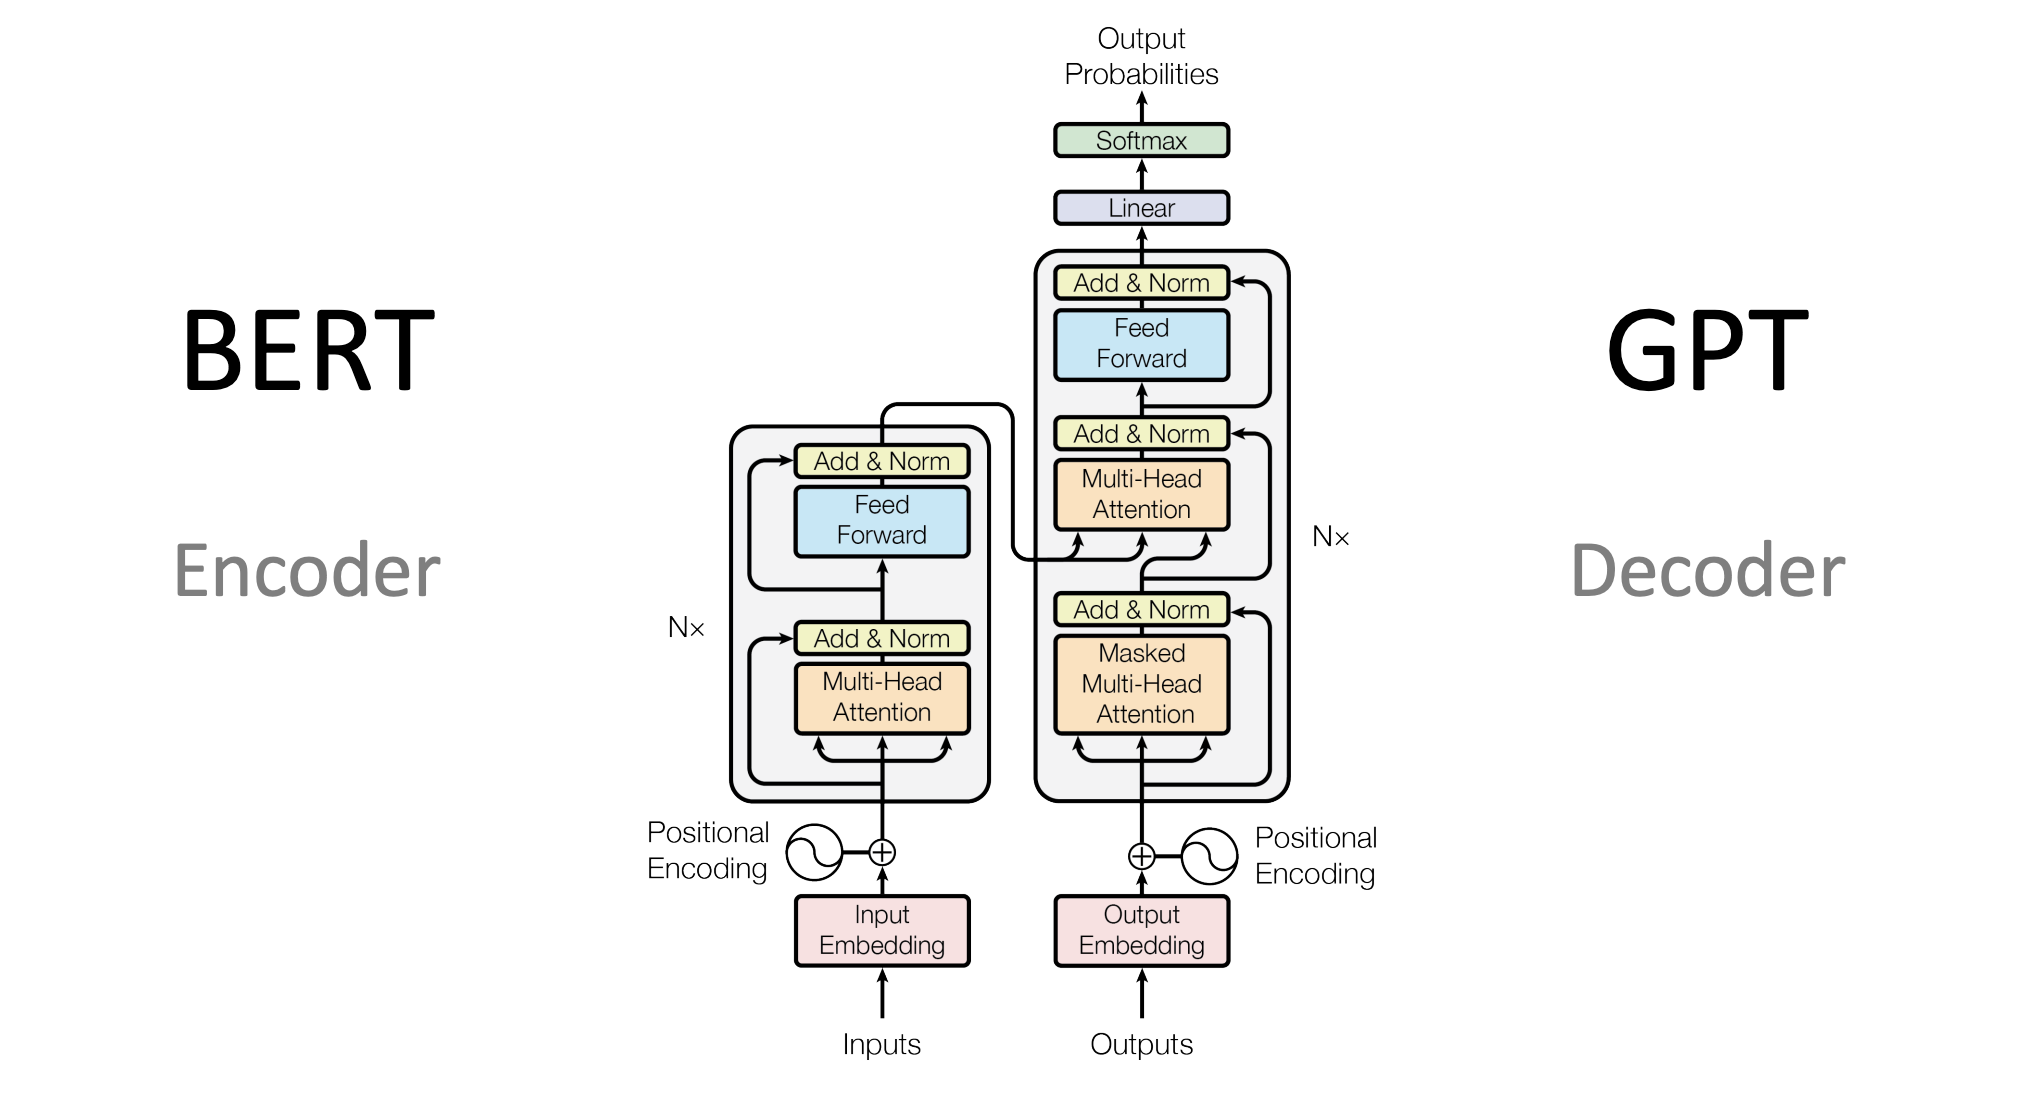
Como cubrimos en la sección anterior, los modelos de lenguaje suelen ser preentrenados con grandes cantidades de datos de texto de manera auto-supervisada (sin anotaciones humanas), y luego ajustados para tareas específicas. Este enfoque, conocido como aprendizaje por transferencia, permite que estos modelos se adapten a muchas tareas diferentes de PNL con cantidades relativamente pequeñas de datos específicos de la tarea.
En las siguientes secciones, exploraremos arquitecturas de modelos específicas y cómo se aplican a diversas tareas en los dominios de voz, visión y texto.
[!TIP] Comprender qué parte de la arquitectura Transformer (codificador, decodificador o ambos) es la más adecuada para una tarea de PNL en particular es clave para elegir el modelo correcto. Generalmente, las tareas que requieren un contexto bidireccional usan codificadores, las tareas que generan texto usan decodificadores y las tareas que convierten una secuencia en otra usan codificadores-decodificadores.
Generación de texto
La generación de texto implica crear texto coherente y contextualmente relevante basado en un prompt o entrada.
GPT-2 es un modelo solo decodificador preentrenado con una gran cantidad de texto. Puede generar texto convincente (¡aunque no siempre verdadero!) dado un prompt y completar otras tareas de PNL como respuesta a preguntas a pesar de no haber sido entrenado explícitamente para ello.
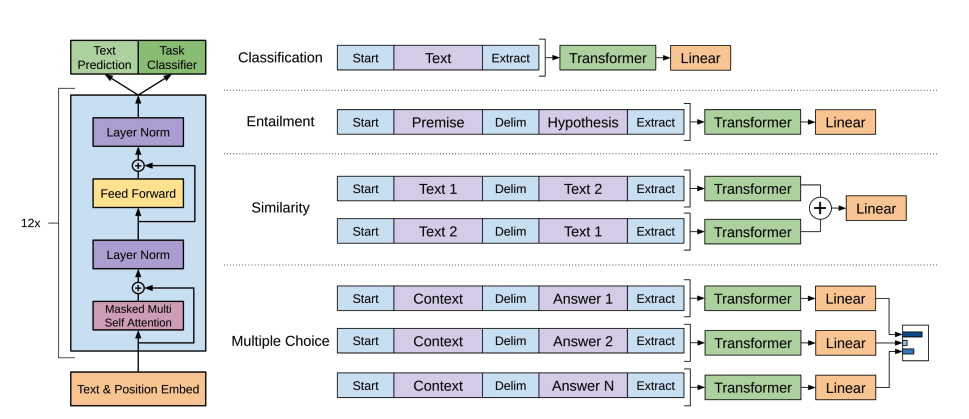
GPT-2 utiliza codificación de pares de bytes (BPE) para tokenizar palabras y generar un embedding de token. Se añaden codificaciones posicionales a los embeddings de token para indicar la posición de cada token en la secuencia. Los embeddings de entrada se pasan a través de múltiples bloques decodificadores para generar un estado oculto final. Dentro de cada bloque decodificador, GPT-2 utiliza una capa de autoatención enmascarada, lo que significa que GPT-2 no puede atender a tokens futuros. Solo se le permite atender a tokens a la izquierda. Esto es diferente del token [
mask] de BERT porque, en la autoatención enmascarada, se utiliza una máscara de atención para establecer la puntuación en0para tokens futuros.La salida del decodificador se pasa a un cabezal de modelado de lenguaje, que realiza una transformación lineal para convertir los estados ocultos en logits. La etiqueta es el siguiente token en la secuencia, que se crea desplazando los logits a la derecha en uno. La pérdida de entropía cruzada se calcula entre los logits desplazados y las etiquetas para generar el siguiente token más probable.
El objetivo de preentrenamiento de GPT-2 se basa completamente en el modelado de lenguaje causal, prediciendo la siguiente palabra en una secuencia. Esto hace que GPT-2 sea especialmente bueno en tareas que implican la generación de texto.
¿Listo para probar la generación de texto? ¡Consulta nuestra guía completa de modelado de lenguaje causal para aprender a ajustar DistilGPT-2 y usarlo para inferencia!
[!TIP] Para obtener más información sobre la generación de texto, ¡consulta la guía de estrategias de generación de texto!
Clasificación de texto
La clasificación de texto implica asignar categorías predefinidas a documentos de texto, como análisis de sentimientos, clasificación de temas o detección de spam.
BERT es un modelo solo codificador y es el primer modelo en implementar eficazmente la bidireccionalidad profunda para aprender representaciones más ricas del texto al atender a palabras en ambos lados.
BERT utiliza la tokenización WordPiece para generar un embedding de token del texto. Para diferenciar entre una sola oración y un par de oraciones, se añade un token especial
[SEP]para distinguirlas. Se añade un token especial[CLS]al principio de cada secuencia de texto. La salida final con el token[CLS]se utiliza como entrada para el cabezal de clasificación en tareas de clasificación. BERT también añade un embedding de segmento para indicar si un token pertenece a la primera o segunda oración en un par de oraciones.BERT se preentrena con dos objetivos: modelado de lenguaje enmascarado y predicción de la siguiente oración. En el modelado de lenguaje enmascarado, un porcentaje de los tokens de entrada se enmascaran aleatoriamente, y el modelo necesita predecirlos. Esto resuelve el problema de la bidireccionalidad, donde el modelo podría hacer trampa y ver todas las palabras y "predecir" la siguiente palabra. Los estados ocultos finales de los tokens de máscara predichos se pasan a una red de alimentación directa con una softmax sobre el vocabulario para predecir la palabra enmascarada.
El segundo objetivo de preentrenamiento es la predicción de la siguiente oración. El modelo debe predecir si la oración B sigue a la oración A. La mitad de las veces la oración B es la siguiente oración, y la otra mitad de las veces, la oración B es una oración aleatoria. La predicción, si es la siguiente oración o no, se pasa a una red de alimentación directa con una softmax sobre las dos clases (
IsNextyNotNext).Los embeddings de entrada se pasan a través de múltiples capas de codificador para generar algunos estados ocultos finales.
Para usar el modelo preentrenado para la clasificación de texto, añade un cabezal de clasificación de secuencia encima del modelo base BERT. El cabezal de clasificación de secuencia es una capa lineal que acepta los estados ocultos finales y realiza una transformación lineal para convertirlos en logits. La pérdida de entropía cruzada se calcula entre los logits y el objetivo para encontrar la etiqueta más probable.
¿Listo para probar la clasificación de texto? ¡Consulta nuestra guía completa de clasificación de texto para aprender a ajustar DistilBERT y usarlo para inferencia!
Clasificación de tokens
La clasificación de tokens implica asignar una etiqueta a cada token en una secuencia, como en el reconocimiento de entidades nombradas o el etiquetado de partes del discurso.
Para usar BERT para tareas de clasificación de tokens como el reconocimiento de entidades nombradas (NER), añade un cabezal de clasificación de tokens encima del modelo base BERT. El cabezal de clasificación de tokens es una capa lineal que acepta los estados ocultos finales y realiza una transformación lineal para convertirlos en logits. La pérdida de entropía cruzada se calcula entre los logits y cada token para encontrar la etiqueta más probable.
¿Listo para probar la clasificación de tokens? ¡Consulta nuestra guía completa de clasificación de tokens para aprender a ajustar DistilBERT y usarlo para inferencia!
Respuesta a preguntas
La respuesta a preguntas implica encontrar la respuesta a una pregunta dentro de un contexto o pasaje dado.
Para usar BERT para la respuesta a preguntas, añade un cabezal de clasificación de span encima del modelo base BERT. Esta capa lineal acepta los estados ocultos finales y realiza una transformación lineal para calcular los logits de inicio y fin span correspondientes a la respuesta. La pérdida de entropía cruzada se calcula entre los logits y la posición de la etiqueta para encontrar el span de texto más probable que corresponde a la respuesta.
¿Listo para probar la respuesta a preguntas? ¡Consulta nuestra guía completa de respuesta a preguntas para aprender a ajustar DistilBERT y usarlo para inferencia!
[!TIP] 💡 ¡Observa lo fácil que es usar BERT para diferentes tareas una vez que ha sido preentrenado. Solo necesitas añadir un cabezal específico al modelo preentrenado para manipular los estados ocultos en la salida deseada!
Resumen
El resumen implica condensar un texto más largo en una versión más corta, conservando su información y significado clave.
Los modelos codificador-decodificador como BART y T5 están diseñados para el patrón de secuencia a secuencia de una tarea de resumen. Explicaremos cómo funciona BART en esta sección, y luego podrás intentar ajustar T5 al final.
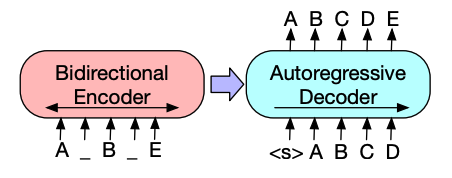
La arquitectura del codificador de BART es muy similar a la de BERT y acepta un token y un embedding posicional del texto. BART se preentrena corrompiendo la entrada y luego reconstruyéndola con el decodificador. A diferencia de otros codificadores con estrategias de corrupción específicas, BART puede aplicar cualquier tipo de corrupción. Sin embargo, la estrategia de corrupción de relleno de texto funciona mejor. En el relleno de texto, un número de spans de texto se reemplazan con un único token [
mask]. Esto es importante porque el modelo tiene que predecir los tokens enmascarados, y le enseña al modelo a predecir el número de tokens faltantes. Los embeddings de entrada y los spans enmascarados se pasan a través del codificador para generar algunos estados ocultos finales, pero a diferencia de BERT, BART no añade una red de alimentación directa final al final para predecir una palabra.La salida del codificador se pasa al decodificador, que debe predecir los tokens enmascarados y cualquier token no corrompido de la salida del codificador. Esto proporciona un contexto adicional para ayudar al decodificador a restaurar el texto original. La salida del decodificador se pasa a un cabezal de modelado de lenguaje, que realiza una transformación lineal para convertir los estados ocultos en logits. La pérdida de entropía cruzada se calcula entre los logits y la etiqueta, que es simplemente el token desplazado a la derecha.
¿Listo para probar el resumen? ¡Consulta nuestra guía completa de resumen para aprender a ajustar T5 y usarlo para inferencia!
[!TIP] Para obtener más información sobre la generación de texto, ¡consulta la guía de estrategias de generación de texto!
Traducción
La traducción implica convertir texto de un idioma a otro conservando su significado. La traducción es otro ejemplo de una tarea de secuencia a secuencia, lo que significa que puedes usar un modelo codificador-decodificador como BART o T5 para hacerlo. Explicaremos cómo funciona BART en esta sección, y luego podrás intentar ajustar T5 al final.
BART se adapta a la traducción añadiendo un codificador separado inicializado aleatoriamente para mapear un idioma de origen a una entrada que puede ser decodificada en el idioma de destino. Los embeddings de este nuevo codificador se pasan al codificador preentrenado en lugar de los embeddings de palabras originales. El codificador de origen se entrena actualizando el codificador de origen, los embeddings posicionales y los embeddings de entrada con la pérdida de entropía cruzada de la salida del modelo. Los parámetros del modelo se congelan en este primer paso, y todos los parámetros del modelo se entrenan juntos en el segundo paso. Desde entonces, BART ha sido seguido por una versión multilingüe, mBART, destinada a la traducción y preentrenada en muchos idiomas diferentes.
¿Listo para probar la traducción? ¡Consulta nuestra guía completa de traducción para aprender a ajustar T5 y usarlo para inferencia!
[!TIP] Como has visto a lo largo de esta guía, muchos modelos siguen patrones similares a pesar de abordar diferentes tareas. Comprender estos patrones comunes puede ayudarte a comprender rápidamente cómo funcionan los nuevos modelos y cómo adaptar los modelos existentes a tus necesidades específicas.
Modalidades más allá del texto
Los Transformers no se limitan al texto. También se pueden aplicar a otras modalidades como voz y audio, imágenes y video. Por supuesto, en este curso nos centraremos en el texto, pero podemos introducir brevemente las otras modalidades.
Voz y audio
Comencemos explorando cómo los modelos Transformer manejan los datos de voz y audio, lo que presenta desafíos únicos en comparación con el texto o las imágenes.
Whisper es un Transformer codificador-decodificador (secuencia a secuencia) preentrenado con 680,000 horas de datos de audio etiquetados. Esta cantidad de datos de preentrenamiento permite un rendimiento de cero-shot en tareas de audio en inglés y muchos otros idiomas. El decodificador permite a Whisper mapear las representaciones de voz aprendidas por el codificador a salidas útiles, como texto, sin ajuste fino adicional. Whisper simplemente funciona de inmediato.
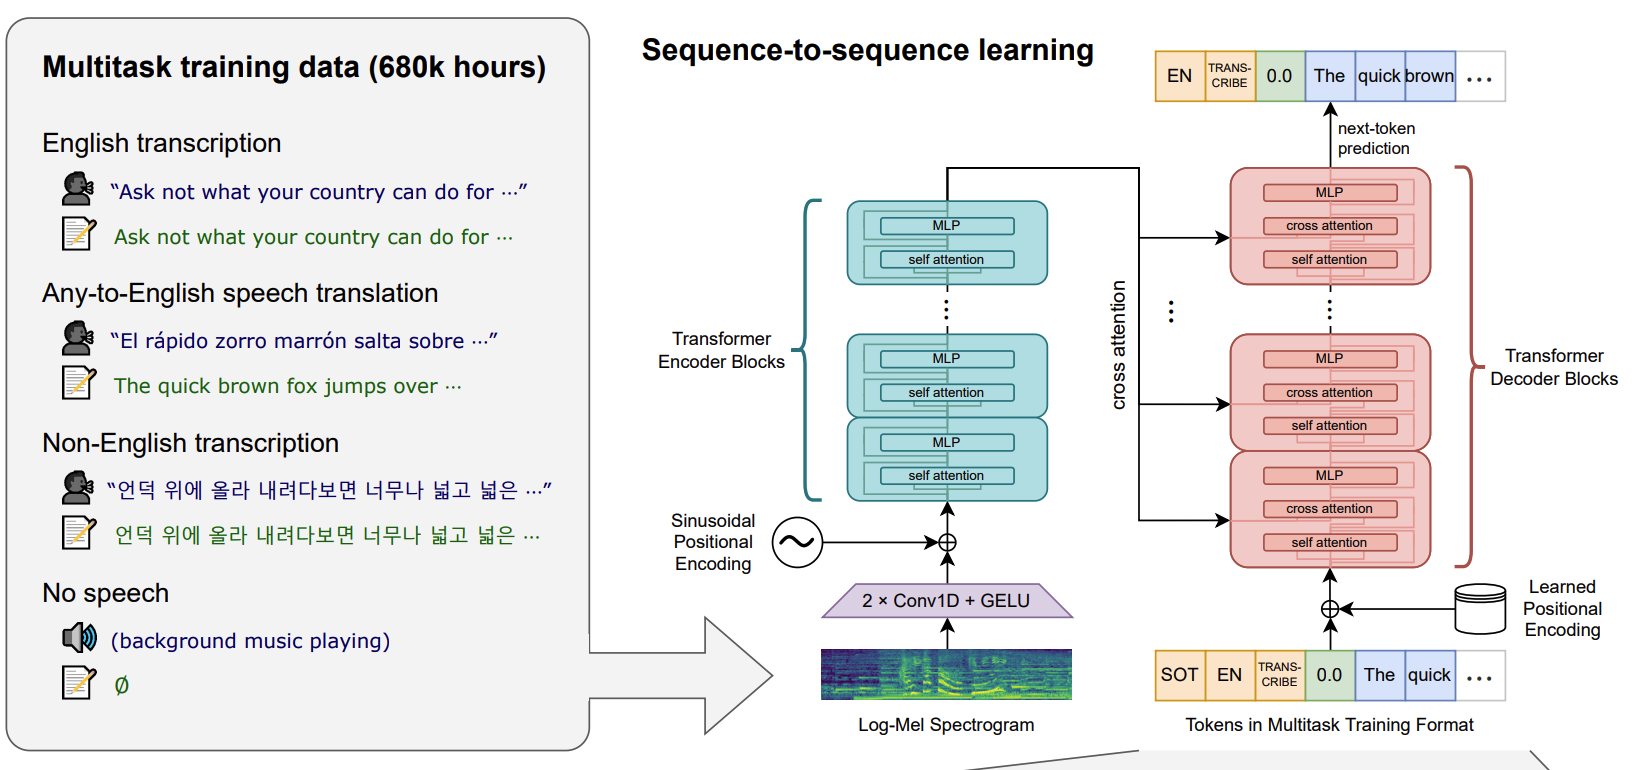
El diagrama es del artículo de Whisper.
Este modelo tiene dos componentes principales:
Un codificador procesa el audio de entrada. El audio sin procesar se convierte primero en un espectrograma log-Mel. Este espectrograma se pasa luego a través de una red codificadora Transformer.
Un decodificador toma la representación de audio codificada y predice autorregresivamente los tokens de texto correspondientes. Es un decodificador Transformer estándar entrenado para predecir el siguiente token de texto dados los tokens anteriores y la salida del codificador. Se utilizan tokens especiales al principio de la entrada del decodificador para dirigir el modelo hacia tareas específicas como transcripción, traducción o identificación de idioma.
Whisper fue preentrenado con un conjunto de datos masivo y diverso de 680,000 horas de datos de audio etiquetados recopilados de la web. Este preentrenamiento a gran escala y débilmente supervisado es la clave de su sólido rendimiento de cero-shot en muchos idiomas y tareas.
Ahora que Whisper está preentrenado, puedes usarlo directamente para inferencia de cero-shot o ajustarlo con tus datos para mejorar el rendimiento en tareas específicas como el reconocimiento automático de voz o la traducción de voz.
[!TIP] La innovación clave en Whisper es su entrenamiento a una escala sin precedentes de datos de audio diversos y débilmente supervisados de internet. Esto le permite generalizar notablemente bien a diferentes idiomas, acentos y tareas sin un ajuste fino específico de la tarea.
Reconocimiento automático de voz
Para usar el modelo preentrenado para el reconocimiento automático de voz, aprovechas su estructura completa de codificador-decodificador. El codificador procesa la entrada de audio y el decodificador genera autorregresivamente la transcripción token por token. Al ajustar, el modelo se entrena típicamente usando una pérdida estándar de secuencia a secuencia (como la entropía cruzada) para predecir los tokens de texto correctos basándose en la entrada de audio.
La forma más fácil de usar un modelo ajustado para inferencia es dentro de un pipeline.
from transformers import pipeline

transcriber = pipeline(
    task="automatic-speech-recognition", model="openai/whisper-base.en"
)
transcriber("https://huggingface.co/datasets/Narsil/asr_dummy/resolve/main/mlk.flac")
# Output: {'text': ' I have a dream that one day this nation will rise up and live out the true meaning of its creed.'}
¿Listo para probar el reconocimiento automático de voz? ¡Consulta nuestra guía completa de reconocimiento automático de voz para aprender a ajustar Whisper y usarlo para inferencia!
Visión por computadora
Ahora pasemos a las tareas de visión por computadora, que se ocupan de comprender e interpretar información visual de imágenes o videos.
Hay dos formas de abordar las tareas de visión por computadora:
- Dividir una imagen en una secuencia de parches y procesarlos en paralelo con un Transformer.
- Usar una CNN moderna, como ConvNeXT, que se basa en capas convolucionales pero adopta diseños de red modernos.
[!TIP] Un tercer enfoque mezcla Transformers con convoluciones (por ejemplo, Convolutional Vision Transformer o LeViT). No los discutiremos porque simplemente combinan los dos enfoques que examinamos aquí.
ViT y ConvNeXT se usan comúnmente para la clasificación de imágenes, pero para otras tareas de visión como la detección de objetos, la segmentación y la estimación de profundidad, veremos DETR, Mask2Former y GLPN, respectivamente; estos modelos son más adecuados para esas tareas.
Clasificación de imágenes
La clasificación de imágenes es una de las tareas fundamentales de la visión artificial. Veamos cómo diferentes arquitecturas de modelos abordan este problema.
ViT y ConvNeXT pueden usarse para la clasificación de imágenes; la principal diferencia es que ViT usa un mecanismo de atención mientras que ConvNeXT usa convoluciones.
ViT reemplaza completamente las convoluciones con una arquitectura Transformer pura. Si estás familiarizado con el Transformer original, ya tienes la mayor parte del camino recorrido para entender ViT.
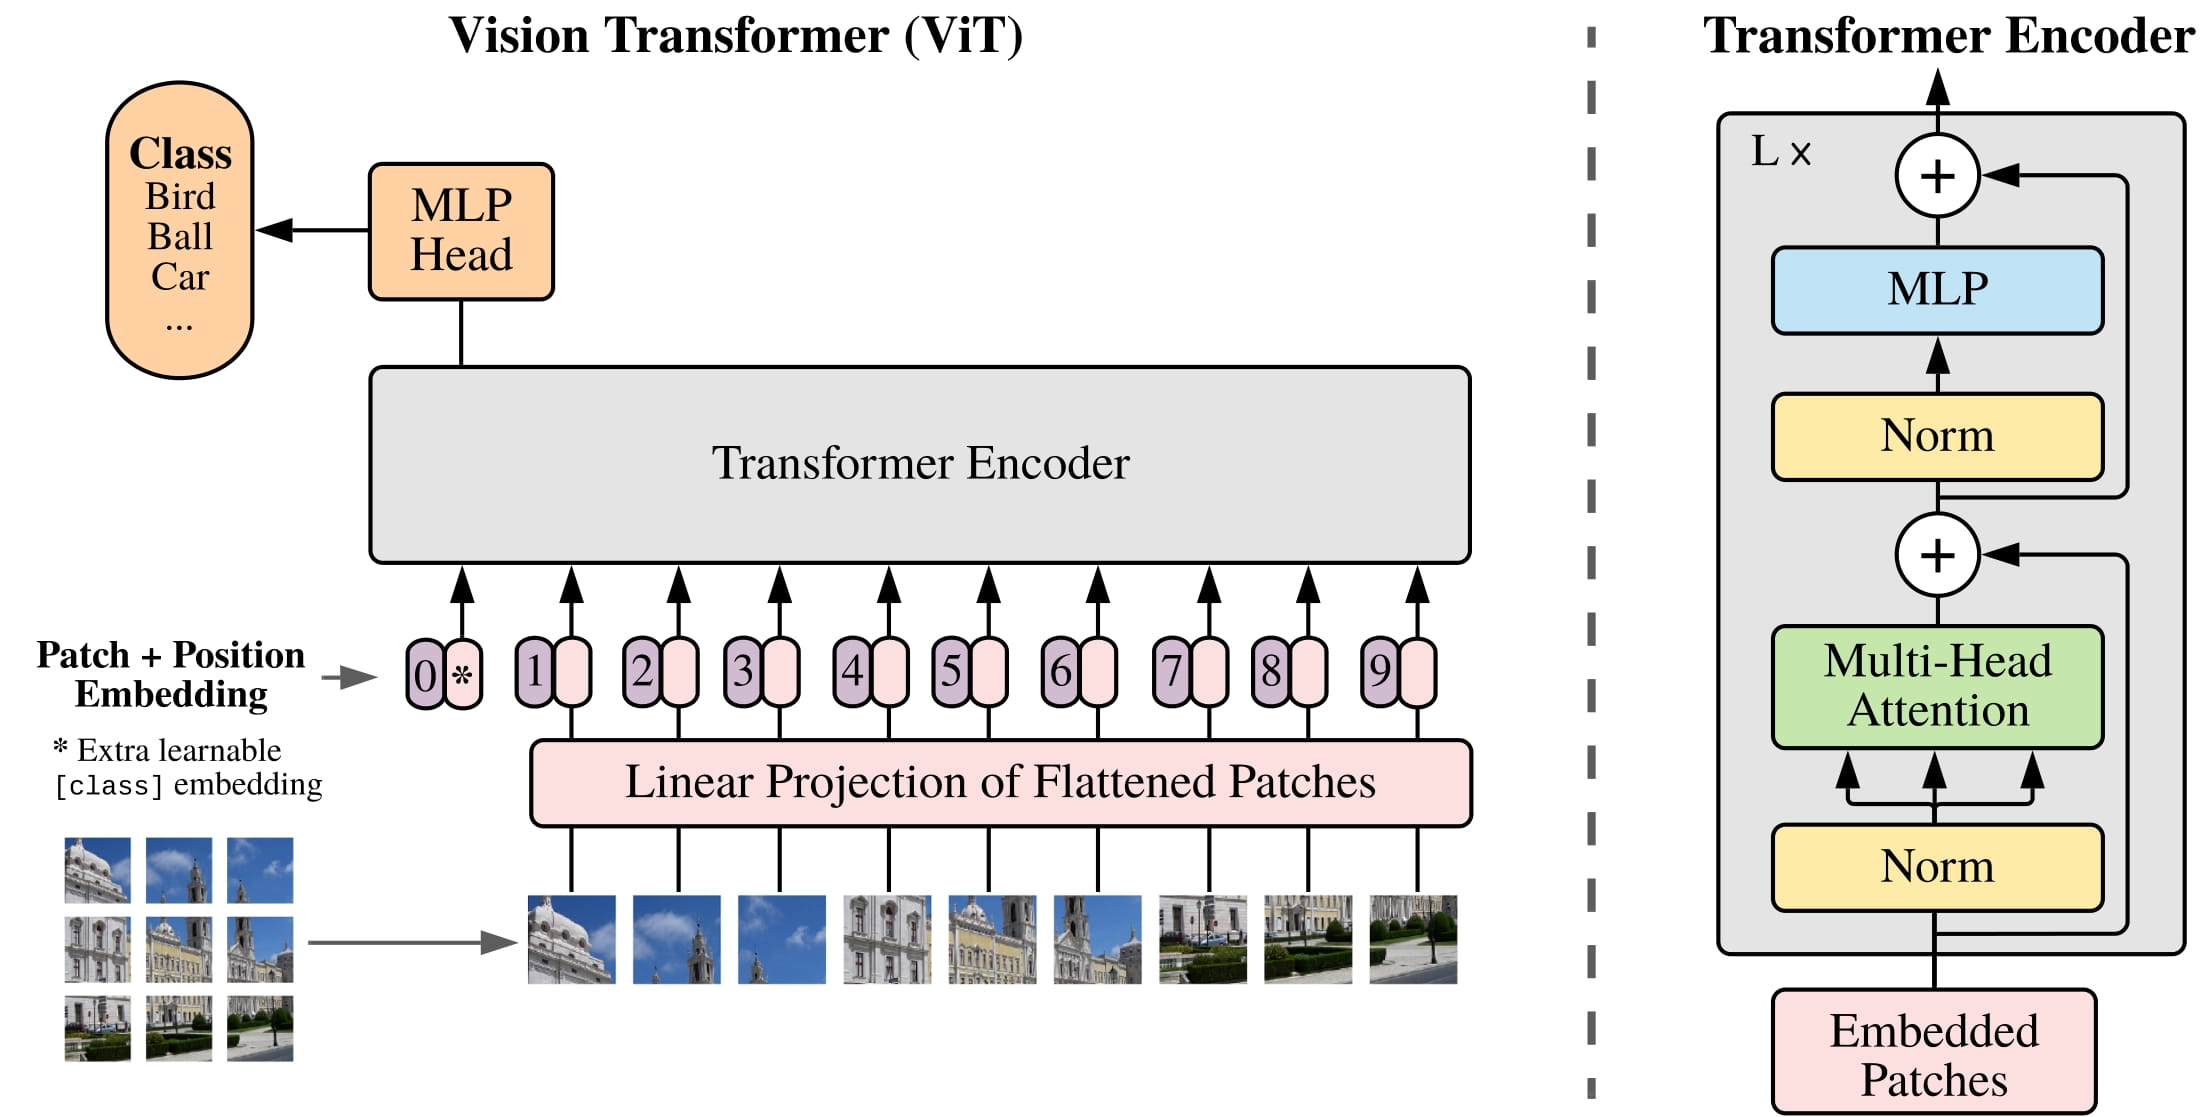
El cambio principal que introdujo ViT fue la forma en que las imágenes se alimentan a un Transformer:
Una imagen se divide en parches cuadrados no superpuestos, cada uno de los cuales se convierte en un vector o patch embedding. Los patch embeddings se generan a partir de una capa convolucional 2D que crea las dimensiones de entrada adecuadas (que para un Transformer base son 768 valores para cada patch embedding). Si tuvieras una imagen de 224x224 píxeles, podrías dividirla en 196 parches de imagen de 16x16. Así como el texto se tokeniza en palabras, una imagen se "tokeniza" en una secuencia de parches.
Se agrega un learnable embedding —un token especial
[CLS]— al principio de los patch embeddings, al igual que BERT. El estado oculto final del token[CLS]se usa como entrada para el cabezal de clasificación adjunto; otras salidas se ignoran. Este token ayuda al modelo a aprender cómo codificar una representación de la imagen.Lo último que se agrega a los patch embeddings y a los learnable embeddings son los position embeddings porque el modelo no sabe cómo están ordenados los parches de la imagen. Los position embeddings también son learnable y tienen el mismo tamaño que los patch embeddings. Finalmente, todos los embeddings se pasan al codificador Transformer.
La salida, específicamente solo la salida con el token
[CLS], se pasa a un cabezal de perceptrón multicapa (MLP). El objetivo de preentrenamiento de ViT es simplemente la clasificación. Al igual que otros cabezales de clasificación, el cabezal MLP convierte la salida en logits sobre las etiquetas de clase y calcula la pérdida de entropía cruzada para encontrar la clase más probable.
¿Listo para probar la clasificación de imágenes? ¡Consulta nuestra guía completa de clasificación de imágenes para aprender a hacer fine-tuning de ViT y usarlo para inferencia!
[!TIP] Observa el paralelismo entre ViT y BERT: ambos usan un token especial (
[CLS]) para capturar la representación general, ambos agregan información de posición a sus embeddings y ambos usan un codificador Transformer para procesar la secuencia de tokens/parches.