Arquitectura de los modelos Transformer
En esta sección, analizaremos la arquitectura de los modelos Transformer y profundizaremos en los conceptos de atención, arquitectura codificador-decodificador y más.
[!WARNING] 🚀 Aquí subimos el nivel. Esta sección es detallada y técnica, así que no te preocupes si no entiendes todo de inmediato. Retomaremos estos conceptos más adelante en el curso.
Un poco de historia de los Transformer[[a-bit-of-transformer-history]]
Aquí tienes algunos puntos de referencia en la (corta) historia de los modelos Transformer:
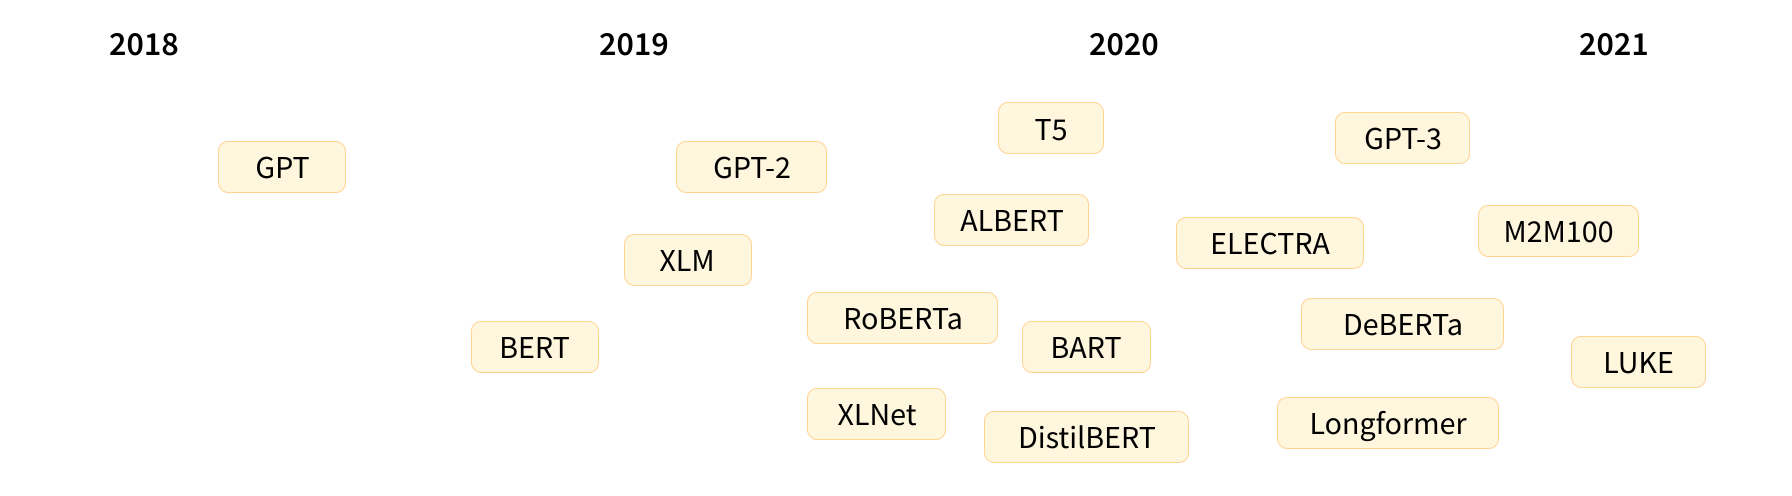
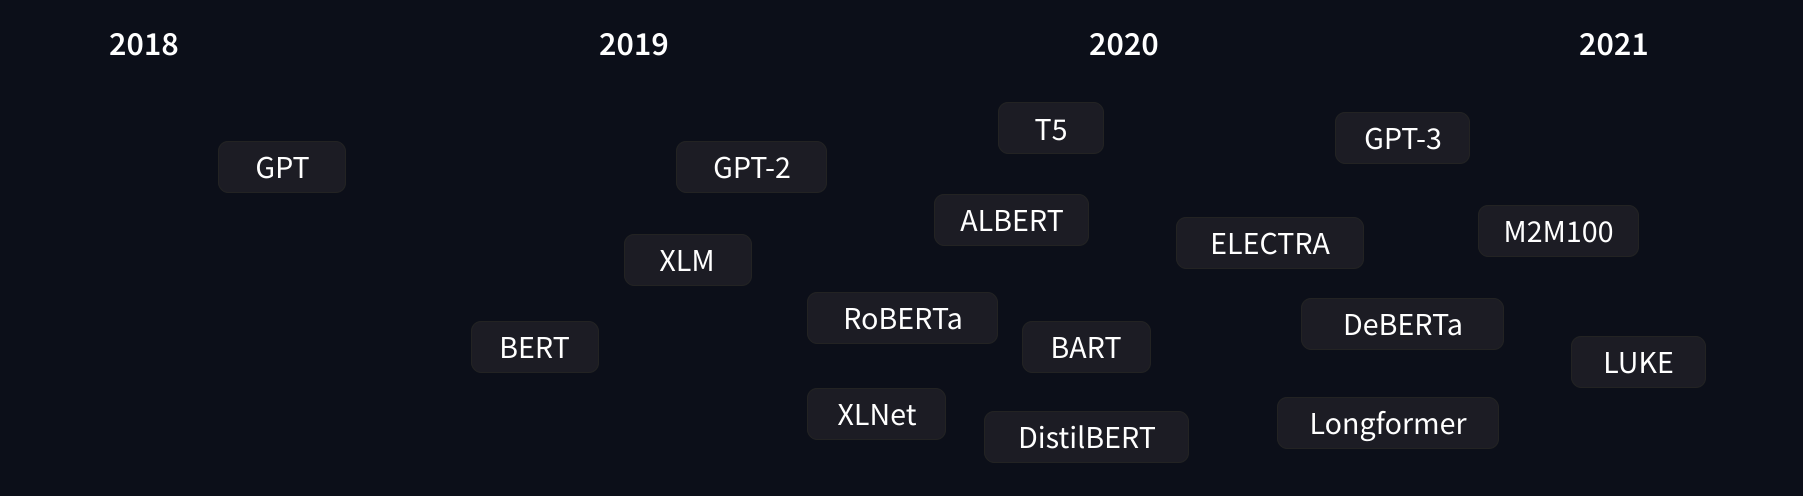
La arquitectura Transformer se introdujo en junio de 2017. El enfoque de la investigación original estaba en las tareas de traducción. A esto le siguió la introducción de varios modelos influyentes, incluyendo:
Junio de 2018: GPT, el primer modelo Transformer preentrenado, utilizado para fine-tuning en varias tareas de PNL y que obtuvo resultados de última generación.
Octubre de 2018: BERT, otro gran modelo preentrenado, este diseñado para producir mejores resúmenes de oraciones (¡más sobre esto en el próximo capítulo!).
Febrero de 2019: GPT-2, una versión mejorada (y más grande) de GPT que no se lanzó inmediatamente al público debido a preocupaciones éticas.
Octubre de 2019: T5, una implementación de la arquitectura Transformer de secuencia a secuencia enfocada en múltiples tareas.
Mayo de 2020, GPT-3, una versión aún más grande de GPT-2 que es capaz de funcionar bien en una variedad de tareas sin necesidad de fine-tuning (llamado zero-shot learning).
Enero de 2022: InstructGPT, una versión de GPT-3 que fue entrenada para seguir mejor las instrucciones.
Enero de 2023: Llama, un modelo de lenguaje grande capaz de generar texto en una variedad de idiomas.
Marzo de 2023: Mistral, un modelo de lenguaje de 7 mil millones de parámetros que supera a Llama 2 13B en todos los benchmarks evaluados, aprovechando la atención de consulta agrupada para una inferencia más rápida y la atención de ventana deslizante para manejar secuencias de longitud arbitraria.
Mayo de 2024: Gemma 2, una familia de modelos abiertos ligeros y de última generación que van desde 2B hasta 27B de parámetros, que incorporan atenciones locales-globales intercaladas y atención de consulta de grupo, con modelos más pequeños entrenados usando destilación de conocimiento para ofrecer un rendimiento competitivo con modelos 2-3 veces más grandes.
Noviembre de 2024: SmolLM2, un modelo de lenguaje pequeño de última generación (de 135 millones a 1.7 mil millones de parámetros) que logra un rendimiento impresionante a pesar de su tamaño compacto, y que abre nuevas posibilidades para dispositivos móviles y de borde.
Esta lista está lejos de ser exhaustiva y solo pretende destacar algunos de los diferentes tipos de modelos Transformer. En general, se pueden agrupar en tres categorías:
- Similares a GPT (también llamados modelos Transformer autorregresivos)
- Similares a BERT (también llamados modelos Transformer de auto-codificación)
- Similares a T5 (también llamados modelos Transformer de secuencia a secuencia)
Profundizaremos en estas familias más adelante.
Los Transformer son modelos de lenguaje[[transformers-are-language-models]]
Todos los modelos Transformer mencionados anteriormente (GPT, BERT, T5, etc.) han sido entrenados como modelos de lenguaje. Esto significa que han sido entrenados con grandes cantidades de texto sin procesar de forma auto-supervisada.
El aprendizaje auto-supervisado es un tipo de entrenamiento en el que el objetivo se calcula automáticamente a partir de las entradas del modelo. ¡Esto significa que no se necesitan humanos para etiquetar los datos!
Este tipo de modelo desarrolla una comprensión estadística del lenguaje en el que ha sido entrenado, pero es menos útil para tareas prácticas específicas. Por ello, el modelo preentrenado general pasa por un proceso llamado transfer learning o fine-tuning. Durante este proceso, el modelo se ajusta de forma supervisada —es decir, utilizando etiquetas anotadas por humanos— para una tarea determinada.
Un ejemplo de tarea es predecir la siguiente palabra en una oración después de haber leído las n palabras anteriores. Esto se llama modelado de lenguaje causal porque la salida depende de las entradas pasadas y presentes, pero no de las futuras.
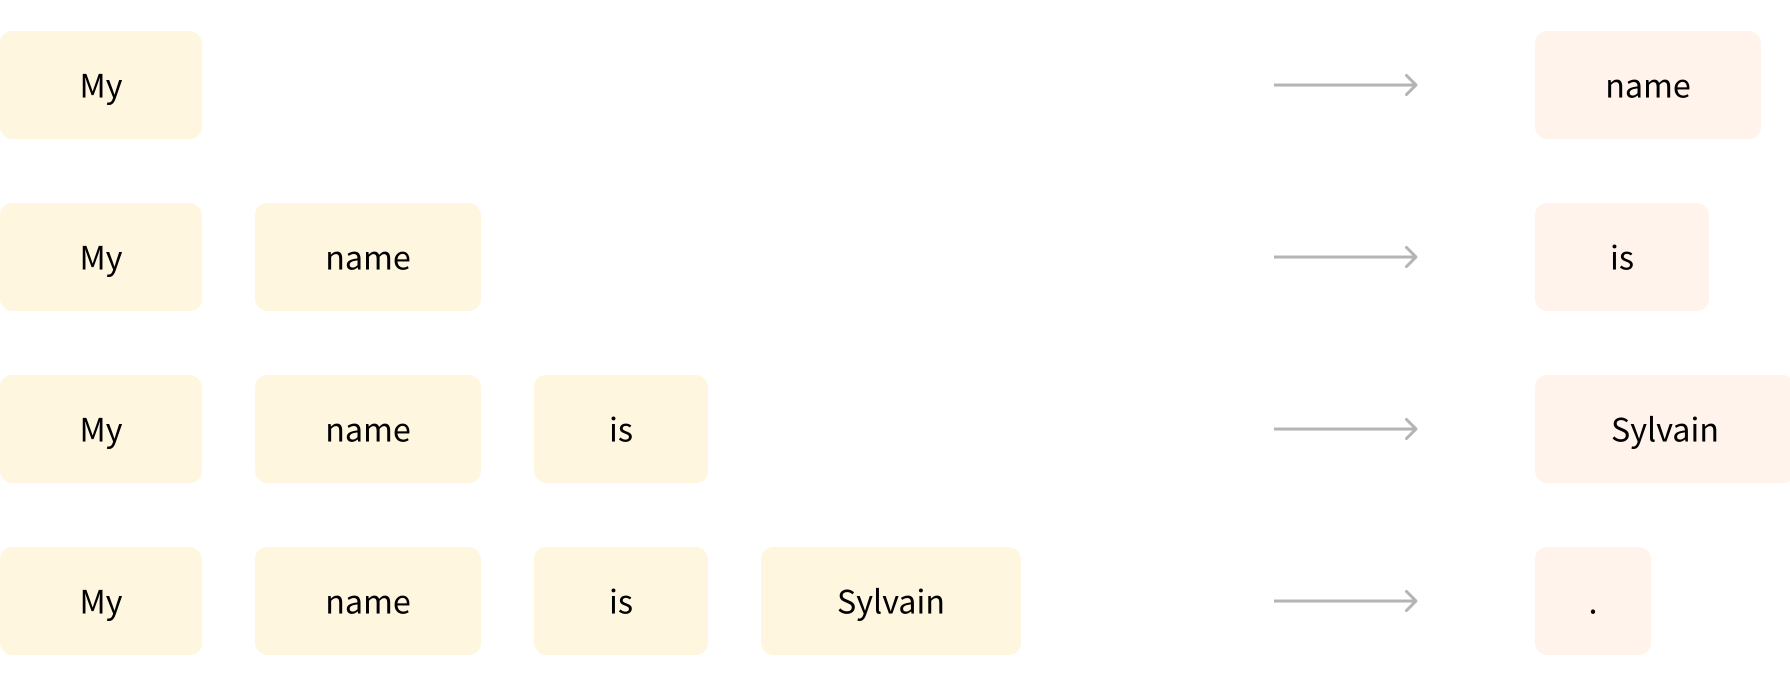
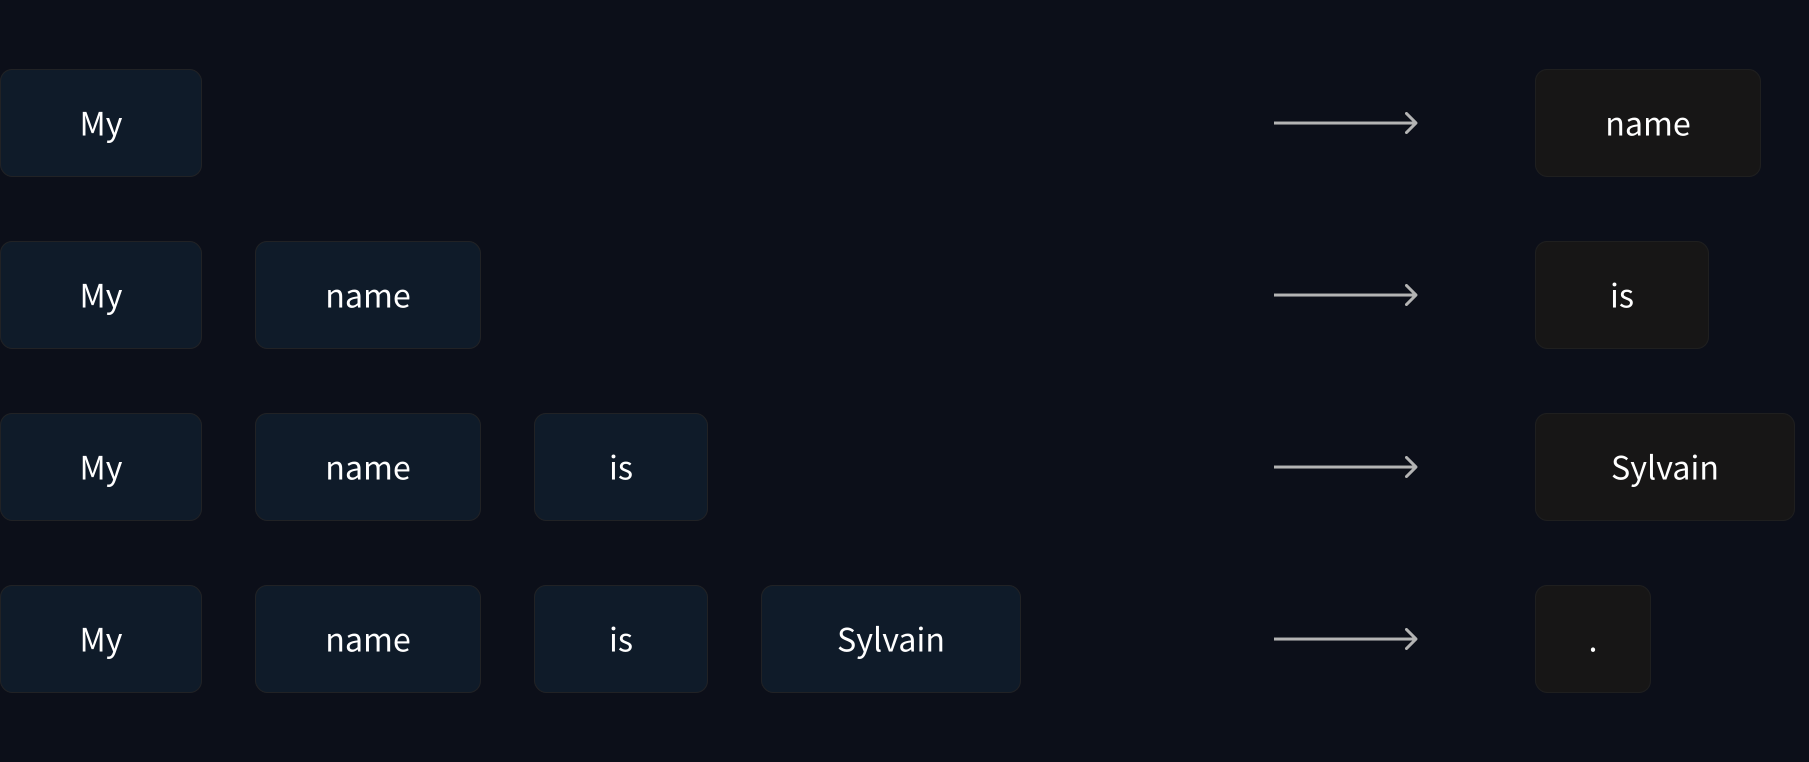
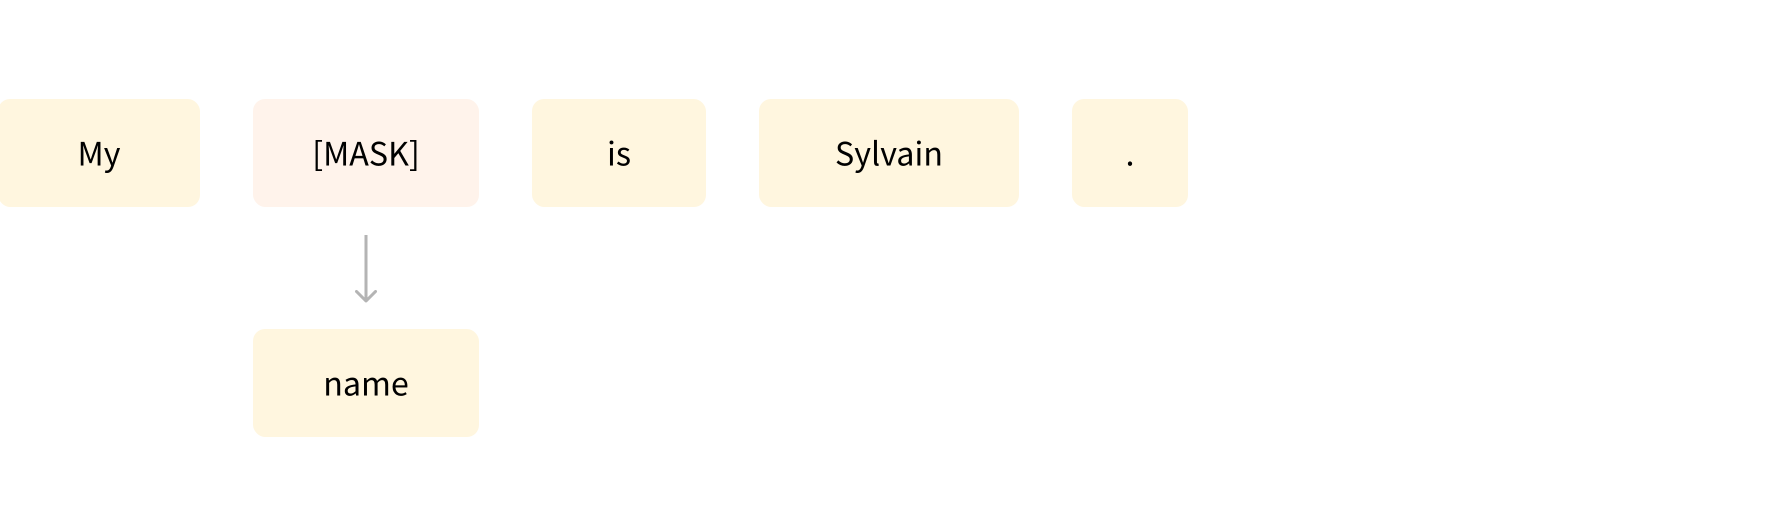
Otro ejemplo es el modelado de lenguaje enmascarado, en el que el modelo predice una palabra enmascarada en la oración.
Los Transformer son modelos grandes[[transformers-are-big-models]]
Aparte de algunas excepciones (como DistilBERT), la estrategia general para lograr un mejor rendimiento es aumentar el tamaño de los modelos, así como la cantidad de datos con los que se preentrenan.
Desafortunadamente, entrenar un modelo, especialmente uno grande, requiere una gran cantidad de datos. Esto se vuelve muy costoso en términos de tiempo y recursos computacionales. Incluso se traduce en un impacto ambiental, como se puede ver en el siguiente gráfico.
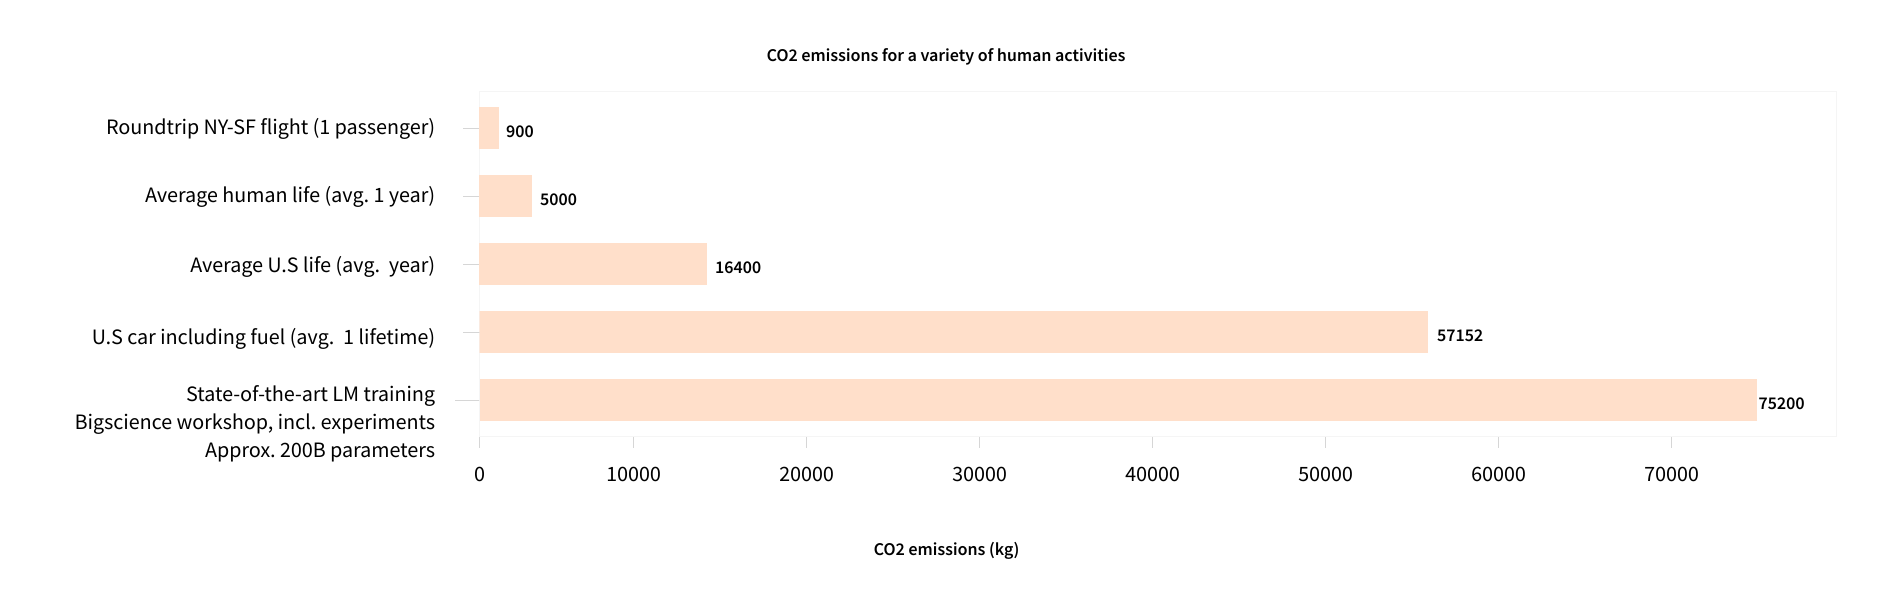
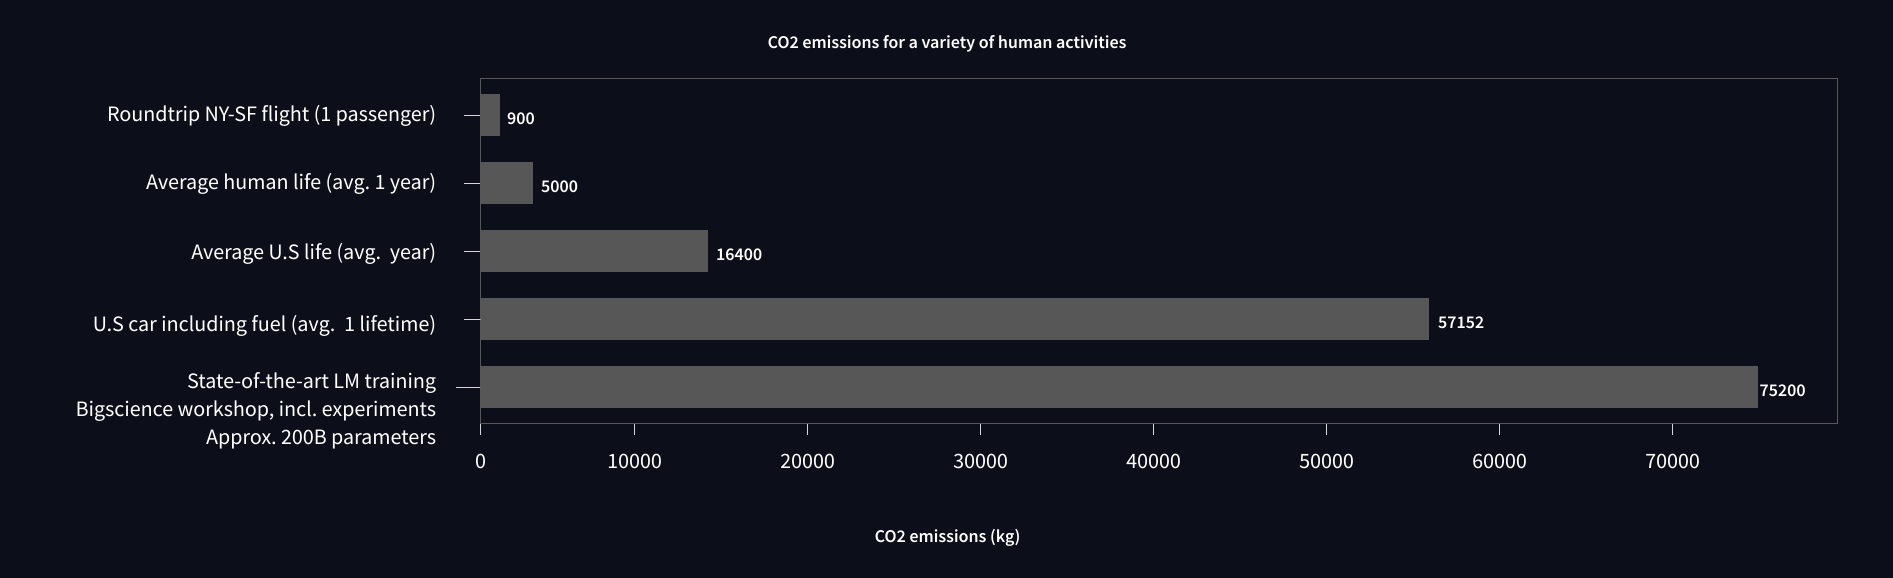
Y esto muestra un proyecto para un modelo (muy grande) liderado por un equipo que intenta conscientemente reducir el impacto ambiental del preentrenamiento. La huella de ejecutar muchas pruebas para obtener los mejores hiperparámetros sería aún mayor.
Imagina si cada vez que un equipo de investigación, una organización estudiantil o una empresa quisiera entrenar un modelo, lo hiciera desde cero. ¡Esto generaría enormes e innecesarios costos globales!
Por eso, compartir modelos de lenguaje es fundamental: compartir los pesos entrenados y construir sobre pesos ya entrenados reduce el costo computacional general y la huella de carbono de la comunidad.
Por cierto, puedes evaluar la huella de carbono del entrenamiento de tus modelos a través de varias herramientas. Por ejemplo, ML CO2 Impact o Code Carbon, que está integrado en 🤗 Transformers. Para saber más sobre esto, puedes leer esta publicación de blog que te mostrará cómo generar un archivo emissions.csv con una estimación de la huella de tu entrenamiento, así como la documentación de 🤗 Transformers que aborda este tema.
Transfer Learning[[transfer-learning]]
El preentrenamiento es el acto de entrenar un modelo desde cero: los pesos se inicializan aleatoriamente y el entrenamiento comienza sin ningún conocimiento previo.
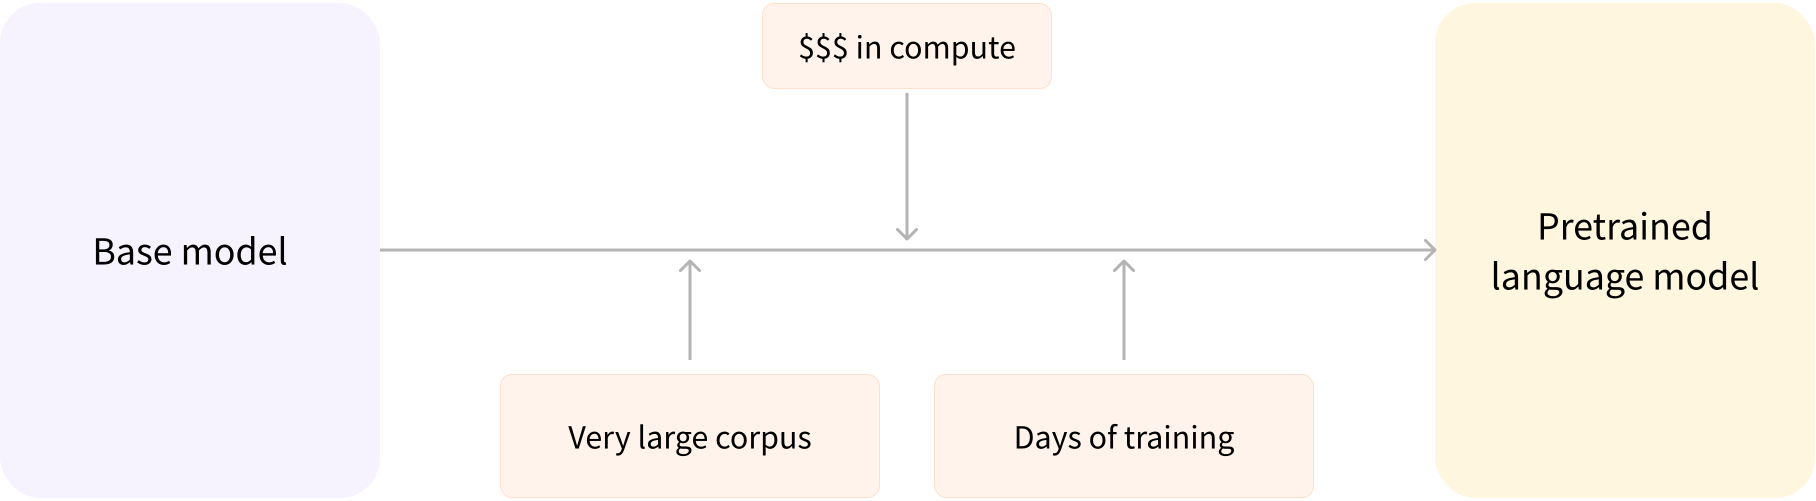
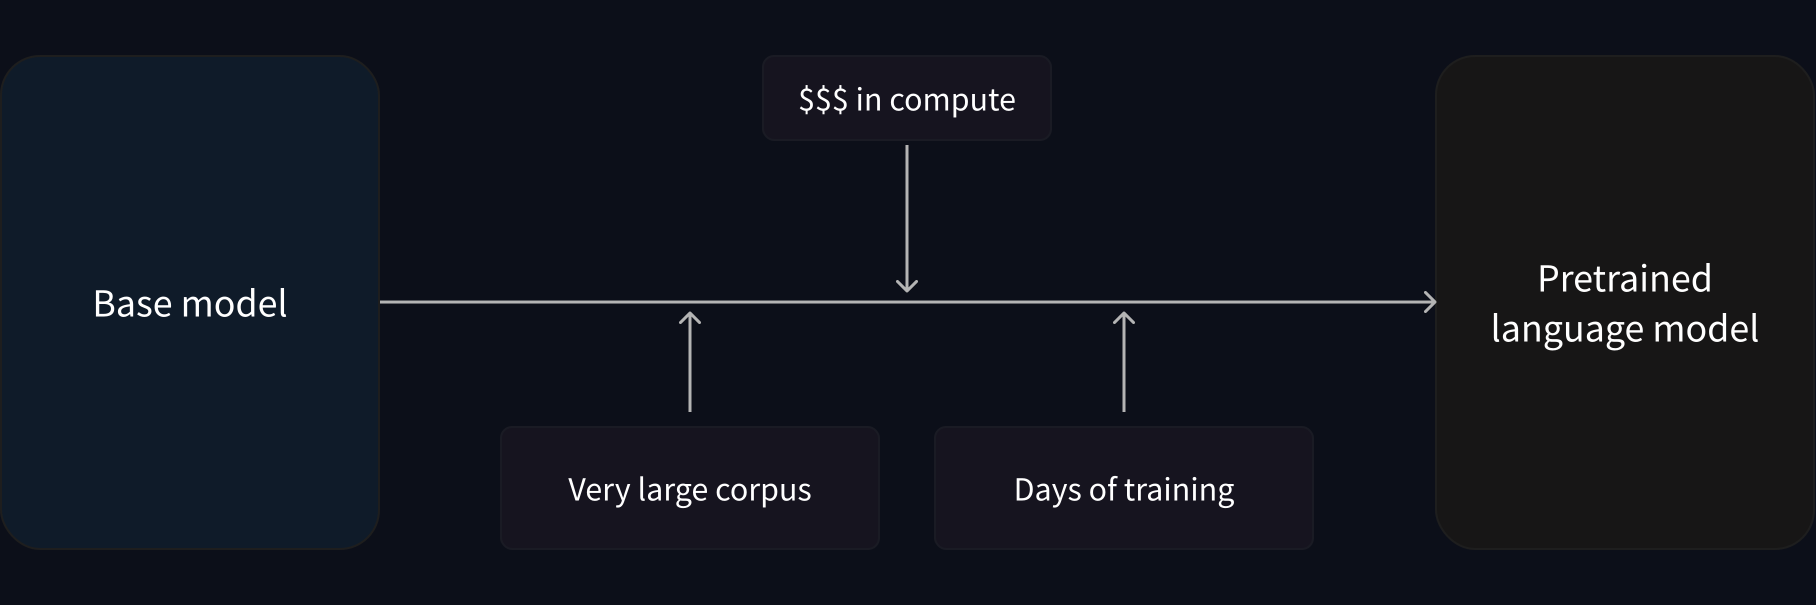
Este preentrenamiento se realiza generalmente con grandes cantidades de datos. Por lo tanto, requiere un corpus de datos muy grande, y el entrenamiento puede tardar varias semanas.
El fine-tuning, por otro lado, es el entrenamiento que se realiza después de que un modelo ha sido preentrenado. Para realizar el fine-tuning, primero adquieres un modelo de lenguaje preentrenado, luego realizas un entrenamiento adicional con un conjunto de datos específico para tu tarea. Espera, ¿por qué no simplemente entrenar el modelo para tu caso de uso final desde el principio (scratch)? Hay un par de razones:
- El modelo preentrenado ya fue entrenado con un conjunto de datos que tiene algunas similitudes con el conjunto de datos de fine-tuning. El proceso de fine-tuning puede así aprovechar el conocimiento adquirido por el modelo inicial durante el preentrenamiento (por ejemplo, con problemas de PNL, el modelo preentrenado tendrá algún tipo de comprensión estadística del lenguaje que estás usando para tu tarea).
- Dado que el modelo preentrenado ya fue entrenado con muchos datos, el fine-tuning requiere muchos menos datos para obtener resultados decentes.
- Por la misma razón, la cantidad de tiempo y recursos necesarios para obtener buenos resultados es mucho menor.
Por ejemplo, se podría aprovechar un modelo preentrenado en inglés y luego ajustarlo con un corpus de arXiv, lo que daría como resultado un modelo basado en ciencia/investigación. El fine-tuning solo requerirá una cantidad limitada de datos: el conocimiento que el modelo preentrenado ha adquirido se "transfiere", de ahí el término transfer learning.
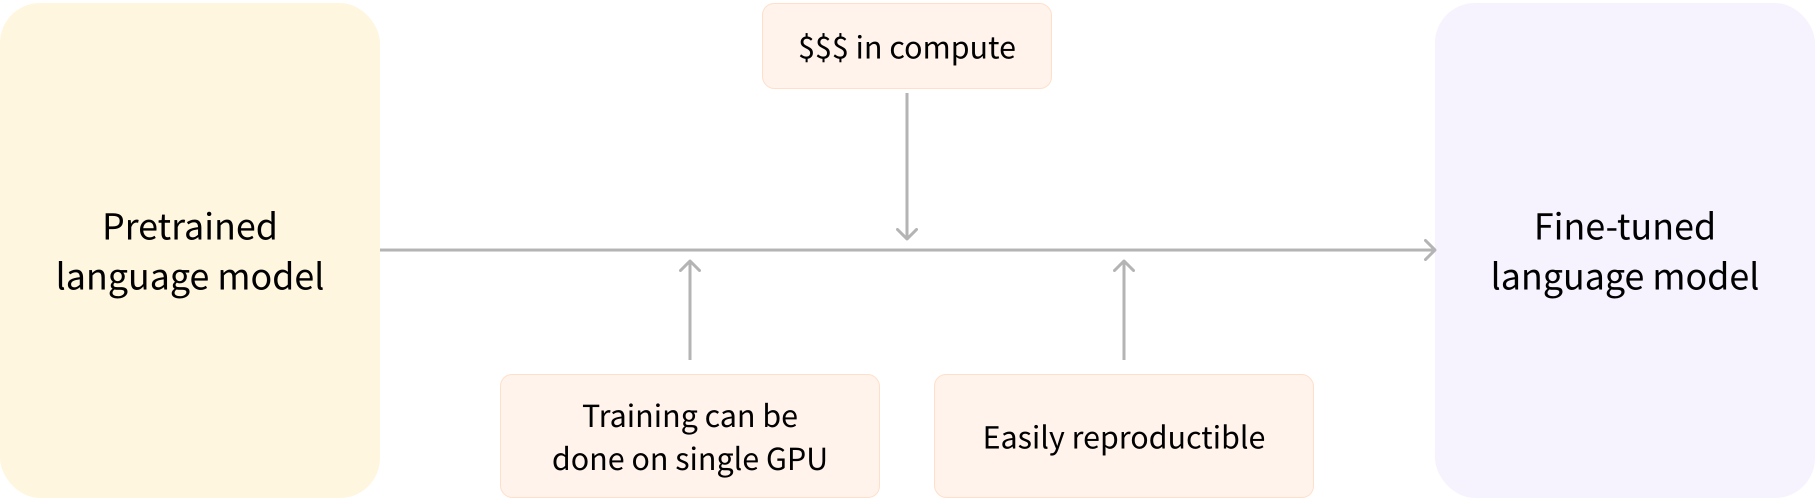
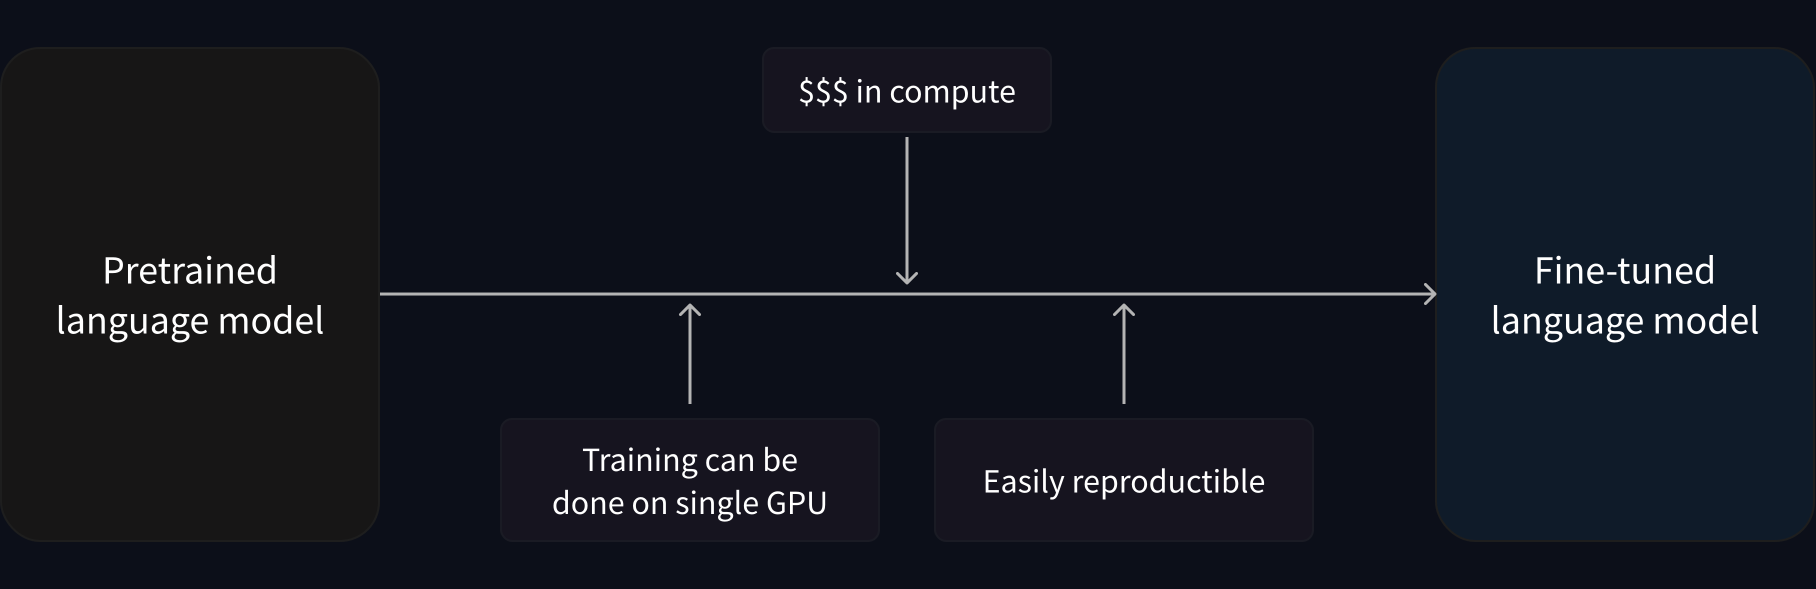
El fine-tuning de un modelo, por lo tanto, tiene menores costos de tiempo, datos, financieros y ambientales. También es más rápido y fácil iterar sobre diferentes esquemas de fine-tuning, ya que el entrenamiento es menos restrictivo que un preentrenamiento completo.
Este proceso también logrará mejores resultados que entrenar desde cero (a menos que tengas muchos datos), por lo que siempre debes intentar aprovechar un modelo preentrenado —uno lo más cercano posible a la tarea que tienes entre manos— y ajustarlo.
Arquitectura general de los Transformer[[general-transformer-architecture]]
En esta sección, repasaremos la arquitectura general del modelo Transformer. No te preocupes si no entiendes algunos de los conceptos; hay secciones detalladas más adelante que cubren cada uno de los componentes.
El modelo se compone principalmente de dos bloques:
- Codificador (izquierda): El codificador recibe una entrada y construye una representación de ella (sus características). Esto significa que el modelo está optimizado para adquirir comprensión de la entrada.
- Decodificador (derecha): El decodificador utiliza la representación del codificador (características) junto con otras entradas para generar una secuencia objetivo. Esto significa que el modelo está optimizado para generar salidas.
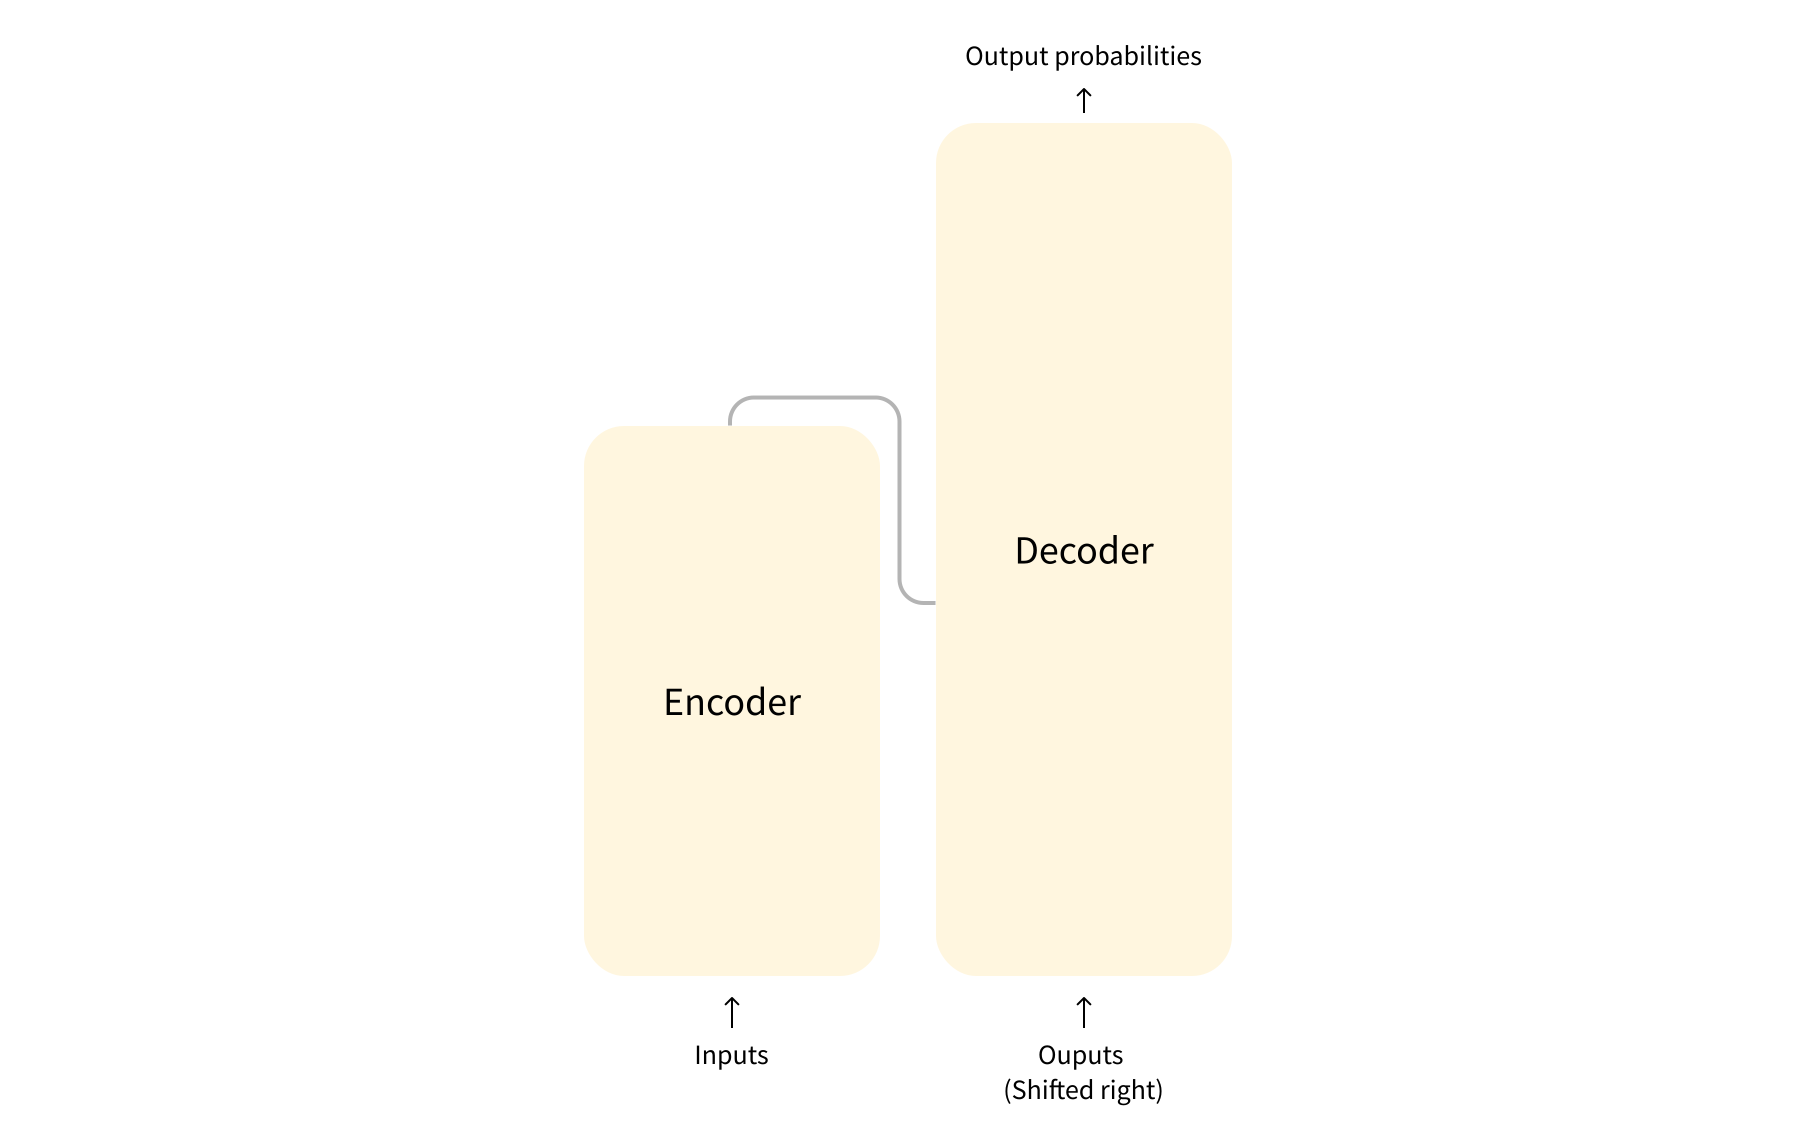
Cada una de estas partes se puede usar de forma independiente, según la tarea:
- Modelos solo con codificador: Buenos para tareas que requieren la comprensión de la entrada, como la clasificación de oraciones y el reconocimiento de entidades nombradas.
- Modelos solo con decodificador: Buenos para tareas generativas como la generación de texto.
- Modelos codificador-decodificador o modelos de secuencia a secuencia: Buenos para tareas generativas que requieren una entrada, como la traducción o el resumen.
Profundizaremos en estas arquitecturas de forma independiente en secciones posteriores.
Capas de atención[[attention-layers]]
Una característica clave de los modelos Transformer es que están construidos con capas especiales llamadas capas de atención. De hecho, el título del artículo que introdujo la arquitectura Transformer fue "Attention Is All You Need" (¡La atención es todo lo que necesitas!). Exploraremos los detalles de las capas de atención más adelante en el curso; por ahora, todo lo que necesitas saber es que esta capa le dirá al modelo que preste atención específica a ciertas palabras en la oración que le pasaste (y que ignore más o menos las demás) al tratar con la representación de cada palabra.
Para poner esto en contexto, considera la tarea de traducir texto del inglés al francés. Dada la entrada "You like this course", un modelo de traducción también necesitará prestar atención a la palabra adyacente "You" para obtener la traducción correcta de la palabra "like", porque en francés el verbo "like" se conjuga de manera diferente según el sujeto. El resto de la oración, sin embargo, no es útil para la traducción de esa palabra. De la misma manera, al traducir "this", el modelo también necesitará prestar atención a la palabra "course", porque "this" se traduce de manera diferente según si el sustantivo asociado es masculino o femenino. De nuevo, las otras palabras de la oración no importarán para la traducción de "course". Con oraciones más complejas (y reglas gramaticales más complejas), el modelo necesitaría prestar especial atención a palabras que podrían aparecer más lejos en la oración para traducir correctamente cada palabra.
El mismo concepto se aplica a cualquier tarea asociada con el lenguaje natural: una palabra por sí misma tiene un significado, pero ese significado se ve profundamente afectado por el contexto, que puede ser cualquier otra palabra (o palabras) antes o después de la palabra que se está estudiando.
Ahora que tienes una idea de qué tratan las capas de atención, echemos un vistazo más de cerca a la arquitectura Transformer.
La arquitectura original[[the-original-architecture]]
La arquitectura Transformer fue diseñada originalmente para la traducción. Durante el entrenamiento, el codificador recibe entradas (oraciones) en un idioma determinado, mientras que el decodificador recibe las mismas oraciones en el idioma de destino deseado. En el codificador, las capas de atención pueden usar todas las palabras de una oración (ya que, como acabamos de ver, la traducción de una palabra dada puede depender de lo que hay después y antes de ella en la oración). El decodificador, sin embargo, funciona secuencialmente y solo puede prestar atención a las palabras de la oración que ya ha traducido (es decir, solo las palabras anteriores a la palabra que se está generando actualmente). Por ejemplo, cuando hemos predicho las tres primeras palabras del objetivo traducido, se las damos al decodificador, que luego usa todas las entradas del codificador para intentar predecir la cuarta palabra.
Para acelerar las cosas durante el entrenamiento (cuando el modelo tiene acceso a las oraciones objetivo), al decodificador se le alimenta todo el objetivo, pero no se le permite usar palabras futuras (si tuviera acceso a la palabra en la posición 2 al intentar predecir la palabra en la posición 2, ¡el problema no sería muy difícil!). Por ejemplo, al intentar predecir la cuarta palabra, la capa de atención solo tendrá acceso a las palabras en las posiciones 1 a 3.
La arquitectura original del Transformer se veía así, con el codificador a la izquierda y el decodificador a la derecha:
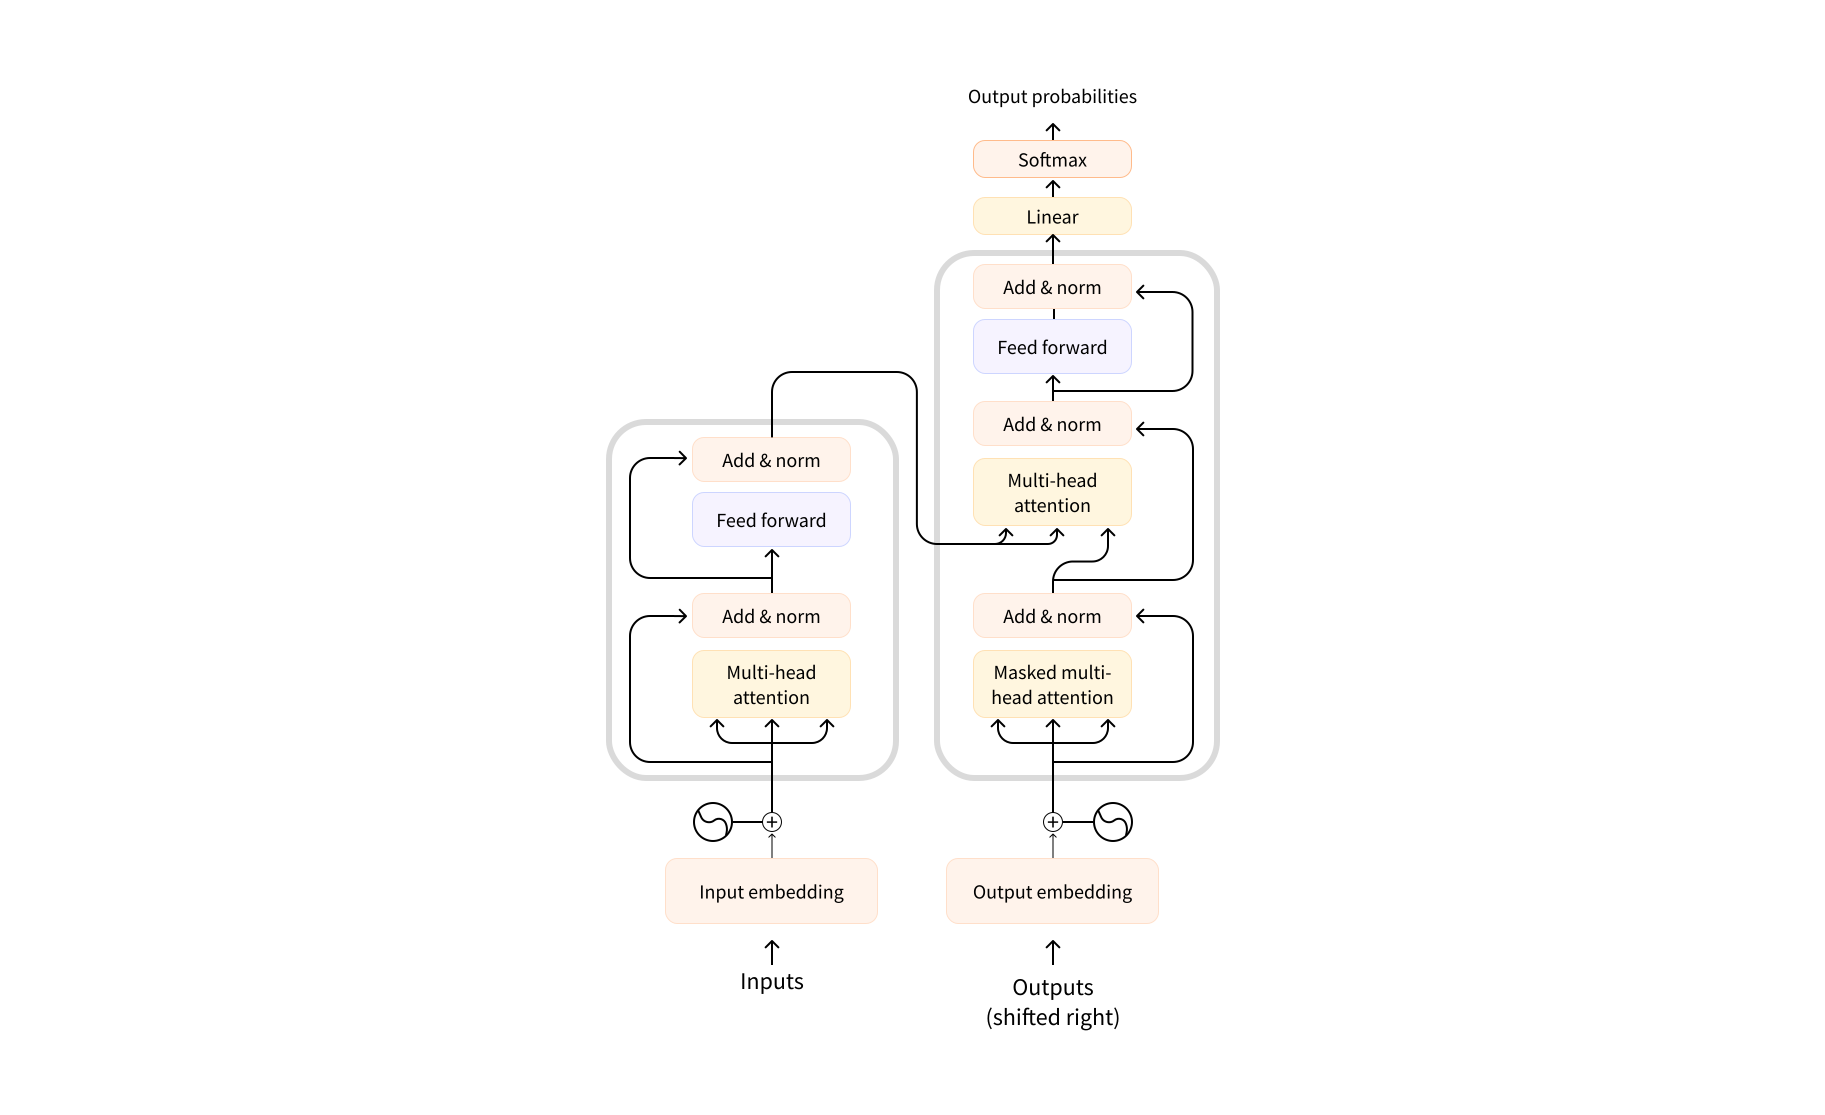
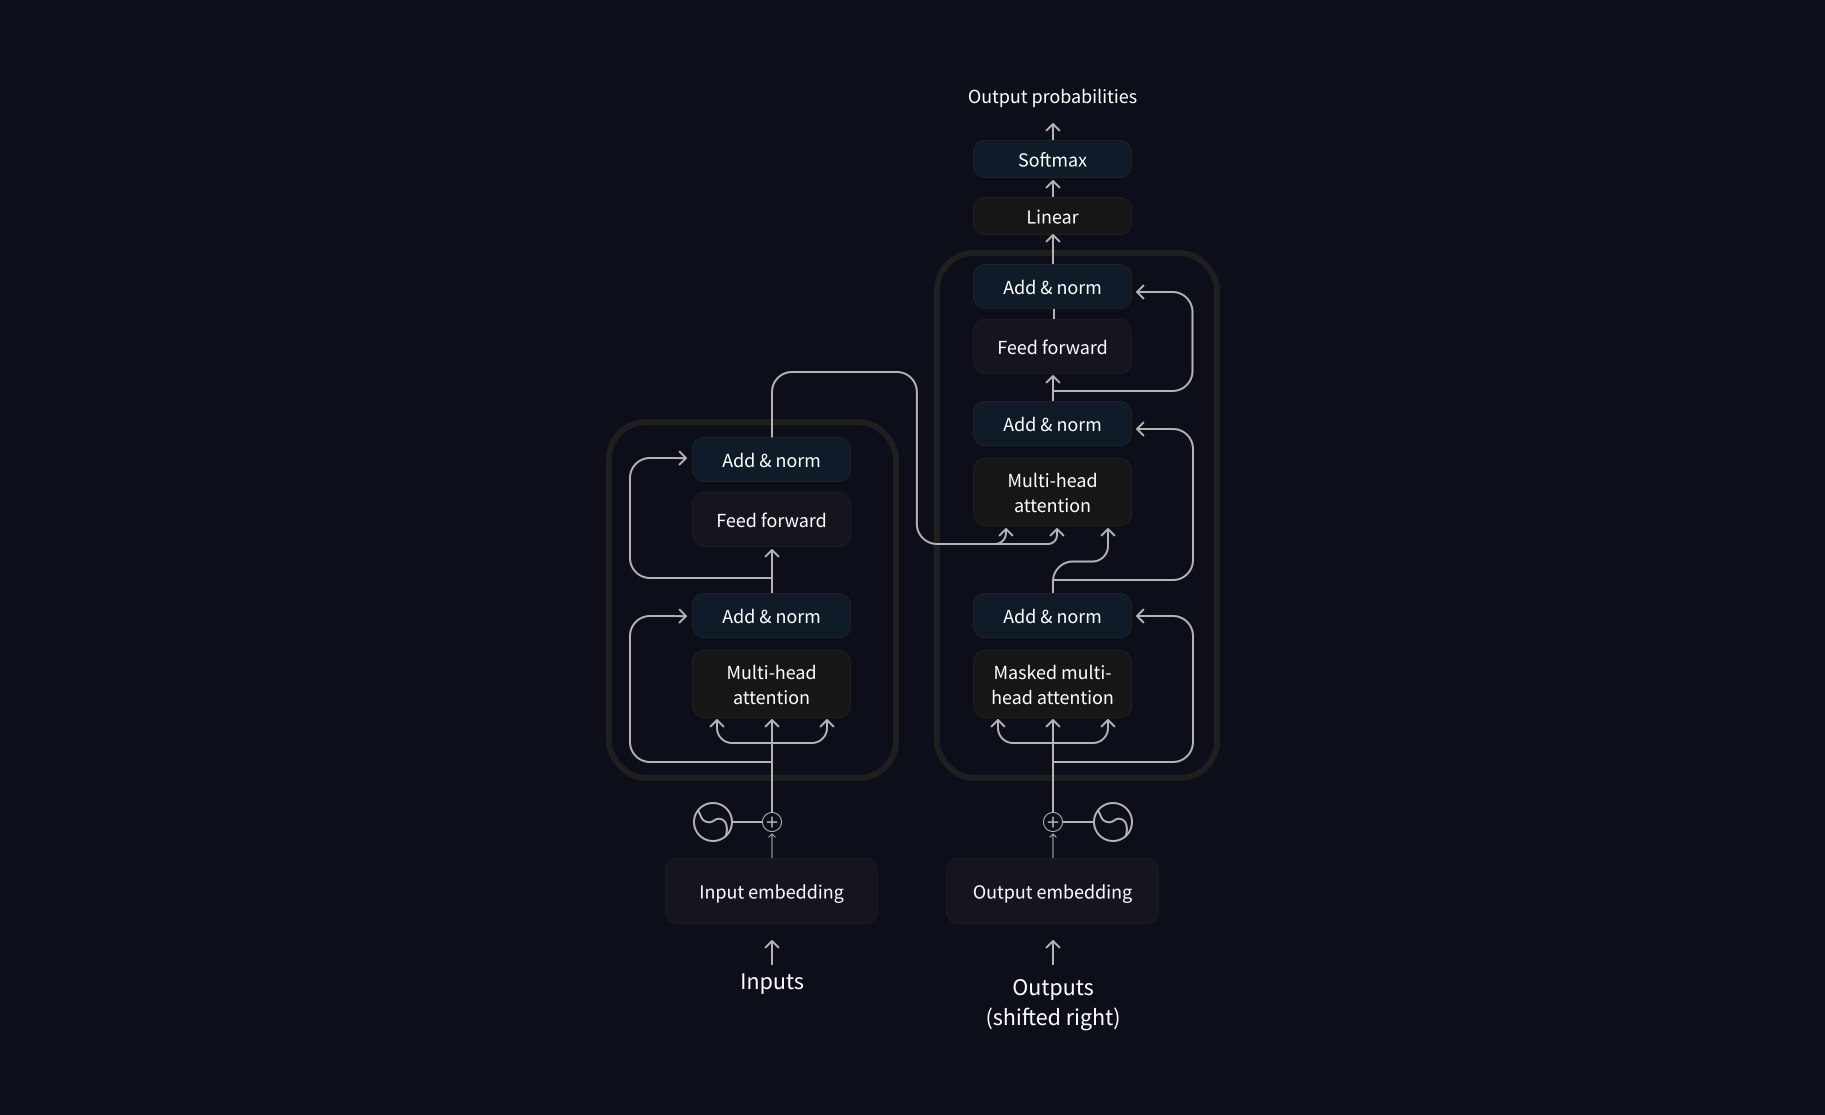
Ten en cuenta que la primera capa de atención en un bloque decodificador presta atención a todas las entradas (pasadas) del decodificador, pero la segunda capa de atención utiliza la salida del codificador. Por lo tanto, puede acceder a toda la oración de entrada para predecir mejor la palabra actual. Esto es muy útil, ya que diferentes idiomas pueden tener reglas gramaticales que colocan las palabras en diferentes órdenes, o algún contexto proporcionado más adelante en la oración puede ser útil para determinar la mejor traducción de una palabra determinada.
La máscara de atención también se puede usar en el codificador/decodificador para evitar que el modelo preste atención a algunas palabras especiales, por ejemplo, la palabra de relleno especial utilizada para que todas las entradas tengan la misma longitud al agrupar oraciones.
Arquitecturas vs. checkpoints[[architecture-vs-checkpoints]]
A medida que profundicemos en los modelos Transformer en este curso, verás menciones de arquitecturas y checkpoints, así como de modelos. Estos términos tienen significados ligeramente diferentes:
- Arquitectura: Es el esqueleto del modelo, la definición de cada capa y cada operación que ocurre dentro del modelo.
- Checkpoints: Son los pesos que se cargarán en una arquitectura determinada.
- Modelo: Es un término general que no es tan preciso como "arquitectura" o "checkpoint": puede significar ambos. Este curso especificará arquitectura o checkpoint cuando sea importante para reducir la ambigüedad.
Por ejemplo, BERT es una arquitectura, mientras que bert-base-cased, un conjunto de pesos entrenados por el equipo de Google para la primera versión de BERT, es un checkpoint. Sin embargo, se puede decir "el modelo BERT" y "el modelo bert-base-cased".