Capacidades avanzadas de los tokenizers
{#if fw === 'pt'}
{:else}
{/if}
En esta sección, examinaremos más de cerca las capacidades de los tokenizers en 🤗 Transformers. Hasta ahora, solo los hemos usado para tokenizar entradas o decodificar IDs de vuelta a texto, pero los tokenizers —especialmente aquellos respaldados por la biblioteca 🤗 Tokenizers— pueden hacer mucho más. Para ilustrar estas características adicionales, exploraremos cómo reproducir los resultados de las pipelines token-classification (que llamamos ner) y question-answering que encontramos por primera vez en el Capítulo 1.
En la siguiente discusión, a menudo haremos la distinción entre tokenizers "lentos" y "rápidos". Los tokenizers lentos son aquellos escritos en Python dentro de la biblioteca 🤗 Transformers, mientras que las versiones rápidas son las proporcionadas por 🤗 Tokenizers, que están escritas en Rust. Si recuerdas la tabla del Capítulo 5 que informaba cuánto tiempo le tomaba a un tokenizer rápido y a uno lento tokenizar el Drug Review Dataset, deberías tener una idea de por qué los llamamos rápidos y lentos:
| Tokenizer rápido | Tokenizer lento | |
|---|---|---|
batched=True |
10.8s | 4min41s |
batched=False |
59.2s | 5min3s |
[!WARNING] ⚠️ Al tokenizar una sola oración, no siempre verás una diferencia de velocidad entre las versiones lenta y rápida del mismo tokenizer. De hecho, ¡la versión rápida podría ser incluso más lenta! Solo al tokenizar muchos textos en paralelo al mismo tiempo podrás ver claramente la diferencia.
Codificación por lotes[[batch-encoding]]
La salida de un tokenizer no es un diccionario simple de Python; lo que obtenemos es en realidad un objeto especial BatchEncoding. Es una subclase de un diccionario (por eso pudimos indexar ese resultado sin ningún problema antes), pero con métodos adicionales que son usados principalmente por los tokenizers rápidos.
Además de sus capacidades de paralelización, la funcionalidad clave de los tokenizers rápidos es que siempre rastrean el tramo original de texto del que provienen los tokens finales, una característica que llamamos *offset mapping*. Esto, a su vez, desbloquea características como mapear cada palabra a los tokens que generó o mapear cada carácter del texto original al token en el que se encuentra, y viceversa.
Veamos un ejemplo:
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
example = "My name is Sylvain and I work at Hugging Face in Brooklyn."
encoding = tokenizer(example)
print(type(encoding))
Como mencionamos anteriormente, obtenemos un objeto BatchEncoding en la salida del tokenizer:
<class 'transformers.tokenization_utils_base.BatchEncoding'>
Dado que la clase AutoTokenizer elige un tokenizer rápido por defecto, podemos usar los métodos adicionales que este objeto BatchEncoding proporciona. Tenemos dos formas de verificar si nuestro tokenizer es rápido o lento. Podemos verificar el atributo is_fast del tokenizer:
tokenizer.is_fast
True
o verificar el mismo atributo de nuestro encoding:
encoding.is_fast
True
Veamos qué nos permite hacer un tokenizer rápido. Primero, podemos acceder a los tokens sin tener que convertir los IDs de nuevo a tokens:
encoding.tokens()
['[CLS]', 'My', 'name', 'is', 'S', '##yl', '##va', '##in', 'and', 'I', 'work', 'at', 'Hu', '##gging', 'Face', 'in',
 'Brooklyn', '.', '[SEP]']
En este caso, el token en el índice 5 es ##yl, que forma parte de la palabra "Sylvain" en la oración original. También podemos usar el método word_ids() para obtener el índice de la palabra de la que proviene cada token:
encoding.word_ids()
[None, 0, 1, 2, 3, 3, 3, 3, 4, 5, 6, 7, 8, 8, 9, 10, 11, 12, None]
Podemos ver que los tokens especiales del tokenizer [CLS] y [SEP] se mapean a None, y luego cada token se mapea a la palabra de la que se origina. Esto es especialmente útil para determinar si un token está al principio de una palabra o si dos tokens están en la misma palabra. Podríamos confiar en el prefijo ## para eso, pero solo funciona para tokenizers tipo BERT; este método funciona para cualquier tipo de tokenizer siempre que sea rápido. En el próximo capítulo, veremos cómo podemos usar esta capacidad para aplicar correctamente las etiquetas que tenemos para cada palabra a los tokens en tareas como el reconocimiento de entidades nombradas (NER) y el etiquetado de partes del discurso (POS). También podemos usarlo para enmascarar todos los tokens que provienen de la misma palabra en el modelado de lenguaje enmascarado (una técnica llamada *whole word masking*).
[!TIP] La noción de lo que es una palabra es complicada. Por ejemplo, ¿"I'll" (una contracción de "I will") cuenta como una o dos palabras? En realidad, depende del tokenizer y de la operación de pre-tokenización que aplique. Algunos tokenizers simplemente dividen por espacios, por lo que lo considerarán una palabra. Otros usan puntuación además de espacios, por lo que lo considerarán dos palabras.
✏️ ¡Pruébalo! Crea un tokenizer a partir de los checkpoints
bert-base-casedyroberta-basey tokeniza "81s" con ellos. ¿Qué observas? ¿Cuáles son los IDs de las palabras?
De manera similar, existe un método sentence_ids() que podemos usar para mapear un token a la oración de la que proviene (aunque en este caso, el token_type_ids devuelto por el tokenizer puede darnos la misma información).
Por último, podemos mapear cualquier palabra o token a caracteres en el texto original, y viceversa, a través de los métodos word_to_chars() o token_to_chars() y char_to_word() o char_to_token(). Por ejemplo, el método word_ids() nos dijo que ##yl es parte de la palabra en el índice 3, pero ¿qué palabra es en la oración? Podemos averiguarlo así:
start, end = encoding.word_to_chars(3)
example[start:end]
Sylvain
Como mencionamos anteriormente, todo esto es posible gracias a que el tokenizer rápido rastrea el tramo de texto del que proviene cada token en una lista de *offsets*. Para ilustrar su uso, a continuación te mostraremos cómo replicar manualmente los resultados de la pipeline token-classification.
[!TIP] ✏️ ¡Pruébalo! Crea tu propio texto de ejemplo y ve si puedes entender qué tokens están asociados con el ID de palabra, y también cómo extraer los rangos de caracteres para una sola palabra. Para puntos extra, intenta usar dos oraciones como entrada y ve si los IDs de oración tienen sentido para ti.
Dentro de la pipeline token-classification[[inside-the-token-classification-pipeline]]
En el Capítulo 1 tuvimos nuestro primer contacto con la aplicación de NER —donde la tarea es identificar qué partes del texto corresponden a entidades como personas, ubicaciones u organizaciones— con la función pipeline() de 🤗 Transformers. Luego, en el Capítulo 2, vimos cómo una pipeline agrupa las tres etapas necesarias para obtener las predicciones de un texto sin procesar: tokenización, pasar las entradas a través del modelo y post-procesamiento. Los primeros dos pasos en la pipeline token-classification son los mismos que en cualquier otra pipeline, pero el post-procesamiento es un poco más complejo, ¡veamos cómo!
{#if fw === 'pt'}
{:else}
{/if}
Obteniendo los resultados base con la pipeline[[getting-the-base-results-with-the-pipeline]]
Primero, tomemos una pipeline de clasificación de tokens para que podamos obtener algunos resultados para comparar manualmente. El modelo utilizado por defecto es dbmdz/bert-large-cased-finetuned-conll03-english; realiza NER en oraciones:
from transformers import pipeline

token_classifier = pipeline("token-classification")
token_classifier("My name is Sylvain and I work at Hugging Face in Brooklyn.")
[{'entity': 'I-PER', 'score': 0.9993828, 'index': 4, 'word': 'S', 'start': 11, 'end': 12},
 {'entity': 'I-PER', 'score': 0.99815476, 'index': 5, 'word': '##yl', 'start': 12, 'end': 14},
 {'entity': 'I-PER', 'score': 0.99590725, 'index': 6, 'word': '##va', 'start': 14, 'end': 16},
 {'entity': 'I-PER', 'score': 0.9992327, 'index': 7, 'word': '##in', 'start': 16, 'end': 18},
 {'entity': 'I-ORG', 'score': 0.97389334, 'index': 12, 'word': 'Hu', 'start': 33, 'end': 35},
 {'entity': 'I-ORG', 'score': 0.976115, 'index': 13, 'word': '##gging', 'start': 35, 'end': 40},
 {'entity': 'I-ORG', 'score': 0.98879766, 'index': 14, 'word': 'Face', 'start': 41, 'end': 45},
 {'entity': 'I-LOC', 'score': 0.99321055, 'index': 16, 'word': 'Brooklyn', 'start': 49, 'end': 57}]
El modelo identificó correctamente cada token generado por "Sylvain" como una persona, cada token generado por "Hugging Face" como una organización, y el token "Brooklyn" como una ubicación. También podemos pedirle a la pipeline que agrupe los tokens que corresponden a la misma entidad:
from transformers import pipeline

token_classifier = pipeline("token-classification", aggregation_strategy="simple")
token_classifier("My name is Sylvain and I work at Hugging Face in Brooklyn.")
[{'entity_group': 'PER', 'score': 0.9981694, 'word': 'Sylvain', 'start': 11, 'end': 18},
 {'entity_group': 'ORG', 'score': 0.97960204, 'word': 'Hugging Face', 'start': 33, 'end': 45},
 {'entity_group': 'LOC', 'score': 0.99321055, 'word': 'Brooklyn', 'start': 49, 'end': 57}]
El aggregation_strategy elegido cambiará las puntuaciones calculadas para cada entidad agrupada. Con "simple" la puntuación es simplemente la media de las puntuaciones de cada token en la entidad dada: por ejemplo, la puntuación de "Sylvain" es la media de las puntuaciones que vimos en el ejemplo anterior para los tokens S, ##yl, ##va y ##in. Otras estrategias disponibles son:
"first", donde la puntuación de cada entidad es la puntuación del primer token de esa entidad (así para "Sylvain" sería 0.993828, la puntuación del tokenS)"max", donde la puntuación de cada entidad es la puntuación máxima de los tokens en esa entidad (así para "Hugging Face" sería 0.98879766, la puntuación de "Face")"average", donde la puntuación de cada entidad es el promedio de las puntuaciones de las palabras que componen esa entidad (así para "Sylvain" no habría diferencia con la estrategia"simple", pero "Hugging Face" tendría una puntuación de 0.9819, el promedio de las puntuaciones para "Hugging", 0.975, y "Face", 0.98879)
¡Ahora veamos cómo obtener estos resultados sin usar la función pipeline()!
De entradas a predicciones[[from-inputs-to-predictions]]
{#if fw === 'pt'}
Primero necesitamos tokenizar nuestra entrada y pasarla por el modelo. Esto se hace exactamente como en el Capítulo 2; instanciamos el tokenizer y el modelo usando las clases AutoXxx y luego los usamos en nuestro ejemplo:
from transformers import AutoTokenizer, AutoModelForTokenClassification

model_checkpoint = "dbmdz/bert-large-cased-finetuned-conll03-english"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModelForTokenClassification.from_pretrained(model_checkpoint)

example = "My name is Sylvain and I work at Hugging Face in Brooklyn."
inputs = tokenizer(example, return_tensors="pt")
outputs = model(**inputs)
Como estamos usando AutoModelForTokenClassification aquí, obtenemos un conjunto de logits para cada token en la secuencia de entrada:
print(inputs["input_ids"].shape)
print(outputs.logits.shape)
torch.Size([1, 19])
torch.Size([1, 19, 9])
{:else}
Primero necesitamos tokenizar nuestra entrada y pasarla por el modelo. Esto se hace exactamente como en el Capítulo 2; instanciamos el tokenizer y el modelo usando las clases TFAutoXxx y luego los usamos en nuestro ejemplo:
from transformers import AutoTokenizer, TFAutoModelForTokenClassification

model_checkpoint = "dbmdz/bert-large-cased-finetuned-conll03-english"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = TFAutoModelForTokenClassification.from_pretrained(model_checkpoint)

example = "My name is Sylvain and I work at Hugging Face in Brooklyn."
inputs = tokenizer(example, return_tensors="tf")
outputs = model(**inputs)
Como estamos usando TFAutoModelForTokenClassification aquí, obtenemos un conjunto de logits para cada token en la secuencia de entrada:
print(inputs["input_ids"].shape)
print(outputs.logits.shape)
(1, 19)
(1, 19, 9)
{/if}
Tenemos un lote con 1 secuencia de 19 tokens y el modelo tiene 9 etiquetas diferentes, por lo que la salida del modelo tiene una forma de 1 x 19 x 9. Al igual que para la pipeline de clasificación de texto, usamos una función softmax para convertir esos logits a probabilidades, y tomamos el argmax para obtener predicciones (ten en cuenta que podemos tomar el argmax en los logits porque el softmax no cambia el orden):
{#if fw === 'pt'}
probabilities = torch.nn.functional.softmax(outputs.logits, dim=-1)[0].tolist()
predictions = outputs.logits.argmax(dim=-1)[0].tolist()
print(predictions)
{:else}
probabilities = tf.math.softmax(outputs.logits, axis=-1)[0]
probabilities = probabilities.numpy().tolist()
predictions = tf.math.argmax(outputs.logits, axis=-1)[0]
predictions = predictions.numpy().tolist()
print(predictions)
{/if}
[0, 0, 0, 0, 4, 4, 4, 4, 0, 0, 0, 0, 6, 6, 6, 0, 8, 0, 0]
El atributo model.config.id2label contiene el mapeo de índices a etiquetas que podemos usar para dar sentido a las predicciones:
model.config.id2label
{0: 'O',
 1: 'B-MISC',
 2: 'I-MISC',
 3: 'B-PER',
 4: 'I-PER',
 5: 'B-ORG',
 6: 'I-ORG',
 7: 'B-LOC',
 8: 'I-LOC'}
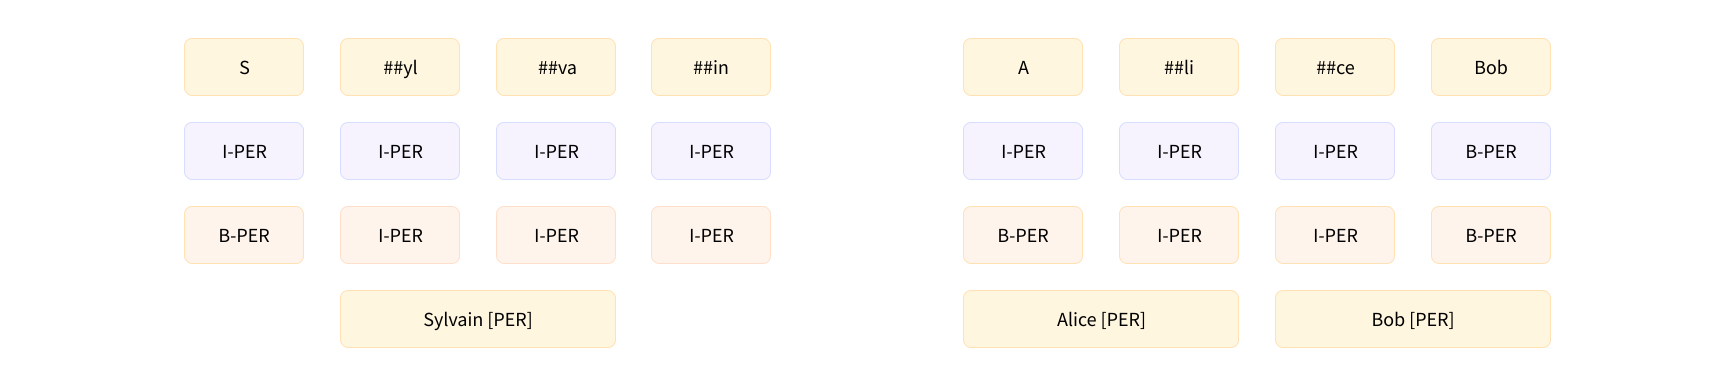
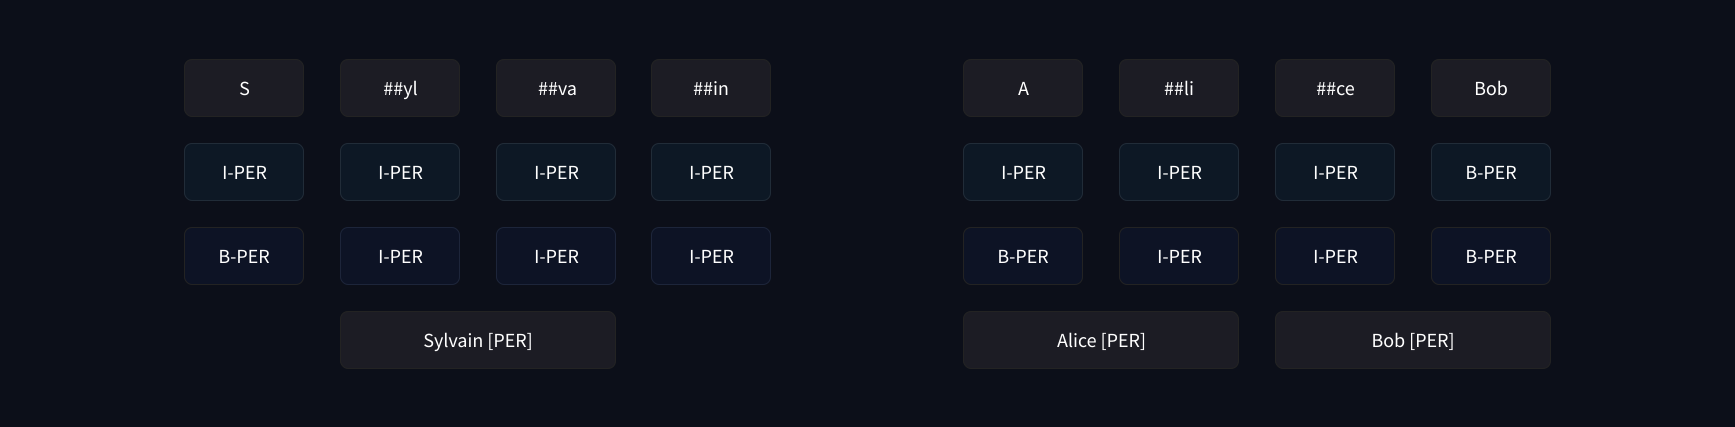
Como vimos anteriormente, hay 9 etiquetas: O es la etiqueta para los tokens que no están en ninguna entidad nombrada (significa "fuera"), y luego tenemos dos etiquetas para cada tipo de entidad (miscelánea, persona, organización y ubicación). La etiqueta B-XXX indica que el token está al principio de una entidad XXX y la etiqueta I-XXX indica que el token está dentro de la entidad XXX. Por ejemplo, en el ejemplo actual esperaríamos que nuestro modelo clasificara el token S como B-PER (principio de una entidad de persona) y los tokens ##yl, ##va y ##in como I-PER (dentro de una entidad de persona).
Podrías pensar que el modelo se equivocó en este caso al dar la etiqueta I-PER a estos cuatro tokens, pero eso no es del todo cierto. En realidad, existen dos formatos para esas etiquetas B- y I-: *IOB1* e *IOB2*. El formato IOB2 (en rosa a continuación) es el que presentamos, mientras que en el formato IOB1 (en azul), las etiquetas que comienzan con B- solo se usan para separar dos entidades adyacentes del mismo tipo. El modelo que estamos usando fue ajustado en un conjunto de datos que utiliza ese formato, por lo que asigna la etiqueta I-PER al token S.
Con este mapa, estamos listos para reproducir (casi por completo) los resultados de la primera pipeline; simplemente podemos tomar la puntuación y la etiqueta de cada token que no fue clasificado como O:
results = []
tokens = inputs.tokens()

for idx, pred in enumerate(predictions):
    label = model.config.id2label[pred]
    if label != "O":
        results.append(
            {"entity": label, "score": probabilities[idx][pred], "word": tokens[idx]}
        )

print(results)
[{'entity': 'I-PER', 'score': 0.9993828, 'index': 4, 'word': 'S'},
 {'entity': 'I-PER', 'score': 0.99815476, 'index': 5, 'word': '##yl'},
 {'entity': 'I-PER', 'score': 0.99590725, 'index': 6, 'word': '##va'},
 {'entity': 'I-PER', 'score': 0.9992327, 'index': 7, 'word': '##in'},
 {'entity': 'I-ORG', 'score': 0.97389334, 'index': 12, 'word': 'Hu'},
 {'entity': 'I-ORG', 'score': 0.976115, 'index': 13, 'word': '##gging'},
 {'entity': 'I-ORG', 'score': 0.98879766, 'index': 14, 'word': 'Face'},
 {'entity': 'I-LOC', 'score': 0.99321055, 'index': 16, 'word': 'Brooklyn'}]
Esto es muy similar a lo que teníamos antes, con una excepción: la pipeline también nos dio información sobre el start y end de cada entidad en la oración original. Aquí es donde nuestro mapeo de offsets entrará en juego. Para obtener los offsets, solo tenemos que establecer return_offsets_mapping=True cuando aplicamos el tokenizer a nuestras entradas:
inputs_with_offsets = tokenizer(example, return_offsets_mapping=True)
inputs_with_offsets["offset_mapping"]
[(0, 0), (0, 2), (3, 7), (8, 10), (11, 12), (12, 14), (14, 16), (16, 18), (19, 22), (23, 24), (25, 29), (30, 32),
 (33, 35), (35, 40), (41, 45), (46, 48), (49, 57), (57, 58), (0, 0)]
Cada tupla es el tramo de texto correspondiente a cada token, donde (0, 0) está reservado para los tokens especiales. Vimos antes que el token en el índice 5 es ##yl, que tiene (12, 14) como offsets aquí. Si tomamos el segmento correspondiente en nuestro ejemplo:
example[12:14]
obtenemos el tramo de texto adecuado sin el ##:
yl
Usando esto, ahora podemos completar los resultados anteriores:
results = []
inputs_with_offsets = tokenizer(example, return_offsets_mapping=True)
tokens = inputs_with_offsets.tokens()
offsets = inputs_with_offsets["offset_mapping"]

for idx, pred in enumerate(predictions):
    label = model.config.id2label[pred]
    if label != "O":
        start, end = offsets[idx]
        results.append(
            {
                "entity": label,
                "score": probabilities[idx][pred],
                "word": tokens[idx],
                "start": start,
                "end": end,
            }
        )

print(results)
[{'entity': 'I-PER', 'score': 0.9993828, 'index': 4, 'word': 'S', 'start': 11, 'end': 12},
 {'entity': 'I-PER', 'score': 0.99815476, 'index': 5, 'word': '##yl', 'start': 12, 'end': 14},
 {'entity': 'I-PER', 'score': 0.99590725, 'index': 6, 'word': '##va', 'start': 14, 'end': 16},
 {'entity': 'I-PER', 'score': 0.9992327, 'index': 7, 'word': '##in', 'start': 16, 'end': 18},
 {'entity': 'I-ORG', 'score': 0.97389334, 'index': 12, 'word': 'Hu', 'start': 33, 'end': 35},
 {'entity': 'I-ORG', 'score': 0.976115, 'index': 13, 'word': '##gging', 'start': 35, 'end': 40},
 {'entity': 'I-ORG', 'score': 0.98879766, 'index': 14, 'word': 'Face', 'start': 41, 'end': 45},
 {'entity': 'I-LOC', 'score': 0.99321055, 'index': 16, 'word': 'Brooklyn', 'start': 49, 'end': 57}]
¡Esto es lo mismo que obtuvimos de la primera pipeline!
Agrupando entidades[[grouping-entities]]
Usar los offsets para determinar las claves de inicio y fin de cada entidad es útil, pero esa información no es estrictamente necesaria. Sin embargo, cuando queremos agrupar las entidades, los offsets nos ahorrarán mucho código desordenado. Por ejemplo, si quisiéramos agrupar los tokens Hu, ##gging y Face, podríamos crear reglas especiales que digan que los dos primeros deben adjuntarse mientras se elimina el ##, y el Face debe agregarse con un espacio ya que no comienza con ##, pero eso solo funcionaría para este tipo particular de tokenizer. Tendríamos que escribir otro conjunto de reglas para un tokenizer SentencePiece o Byte-Pair-Encoding (discutido más adelante en este capítulo).
Con los offsets, todo ese código personalizado desaparece: simplemente podemos tomar el tramo en el texto original que comienza con el primer token y termina con el último token. Así, en el caso de los tokens Hu, ##gging y Face, deberíamos comenzar en el carácter 33 (el principio de Hu) y terminar antes del carácter 45 (el final de Face):
example[33:45]
Hugging Face
Para escribir el código que post-procesa las predicciones mientras agrupa entidades, agruparemos entidades que son consecutivas y están etiquetadas con I-XXX, excepto la primera, que puede estar etiquetada como B-XXX o I-XXX (es decir, dejamos de agrupar una entidad cuando obtenemos un O, un nuevo tipo de entidad, o un B-XXX que nos indica que está comenzando una entidad del mismo tipo):
results = []
inputs_with_offsets = tokenizer(example, return_offsets_mapping=True)
tokens = inputs_with_offsets.tokens()
offsets = inputs_with_offsets["offset_mapping"]

idx = 0
while idx < len(predictions):
    pred = predictions[idx]
    label = model.config.id2label[pred]
    if label != "O":
        # Remove the B- or I-
        label = label[2:]
        start, _ = offsets[idx]

        # Grab all the tokens labeled with I-label
        all_scores = []
        while (
            idx < len(predictions)
            and model.config.id2label[predictions[idx]] == f"I-{label}"
        ):
            all_scores.append(probabilities[idx][pred])
            _, end = offsets[idx]
            idx += 1

        # The score is the mean of all the scores of the tokens in that grouped entity
        score = np.mean(all_scores).item()
        word = example[start:end]
        results.append(
            {
                "entity_group": label,
                "score": score,
                "word": word,
                "start": start,
                "end": end,
            }
        )
    idx += 1

print(results)
¡Y obtenemos los mismos resultados que con nuestra segunda pipeline!
[{'entity_group': 'PER', 'score': 0.9981694, 'word': 'Sylvain', 'start': 11, 'end': 18},
 {'entity_group': 'ORG', 'score': 0.97960204, 'word': 'Hugging Face', 'start': 33, 'end': 45},
 {'entity_group': 'LOC', 'score': 0.99321055, 'word': 'Brooklyn', 'start': 49, 'end': 57}]
Otro ejemplo de una tarea donde estos offsets son extremadamente útiles es la respuesta a preguntas. Profundizar en esa pipeline, lo que haremos en la siguiente sección, también nos permitirá echar un vistazo a una última característica de los tokenizers en la biblioteca 🤗 Transformers: lidiar con tokens desbordados cuando truncamos una entrada a una longitud dada.