Entrenando un modelo de lenguaje desde cero
{#if fw === 'pt'}
{:else}
{/if}
Hasta ahora, hemos usado principalmente modelos preentrenados y los hemos ajustado para nuevos casos de uso reutilizando los pesos del preentrenamiento. Como vimos en el Capítulo 1, esto se conoce comúnmente como aprendizaje por transferencia, y es una estrategia muy exitosa para aplicar modelos Transformer a la mayoría de los casos de uso del mundo real donde los datos etiquetados son escasos. En este capítulo, adoptaremos un enfoque diferente y entrenaremos un modelo completamente nuevo desde cero. Este es un buen enfoque si tienes muchos datos y son muy diferentes de los datos de preentrenamiento usados para los modelos disponibles. Sin embargo, también requiere muchos más recursos computacionales preentrenar un modelo de lenguaje que solo ajustar uno existente. Ejemplos donde puede tener sentido entrenar un nuevo modelo incluyen conjuntos de datos que consisten en notas musicales, secuencias moleculares como ADN o lenguajes de programación. Estos últimos han ganado tracción recientemente gracias a herramientas como TabNine y Copilot de GitHub, impulsadas por el modelo Codex de OpenAI, que pueden generar largas secuencias de código. Esta tarea de generación de texto se aborda mejor con modelos de lenguaje autorregresivos o causales como GPT-2.
En esta sección construiremos una versión reducida de un modelo de generación de código: nos enfocaremos en completados de una línea en lugar de funciones o clases completas, usando un subconjunto de código Python. Cuando trabajas con datos en Python, estás en contacto frecuente con el stack de ciencia de datos de Python, que consiste en las librerías matplotlib, seaborn, pandas y scikit-learn. Al usar esos frameworks, es común necesitar buscar comandos específicos, por lo que sería bueno si pudiéramos usar un modelo para completar estas llamadas por nosotros.
En el Capítulo 6 creamos un tokenizador eficiente para procesar código fuente de Python, pero lo que aún necesitamos es un conjunto de datos a gran escala para preentrenar un modelo. Aquí, aplicaremos nuestro tokenizador a un corpus de código Python derivado de repositorios de GitHub. Luego usaremos la API Trainer y 🤗 Accelerate para entrenar el modelo. ¡Manos a la obra!
Esto en realidad muestra el modelo que fue entrenado y subido al Hub usando el código que se muestra en esta sección. Puedes encontrarlo aquí. Ten en cuenta que, dado que hay cierta aleatorización en la generación de texto, probablemente obtendrás un resultado ligeramente diferente.
Recolectando los datos[[gathering-the-data]]
El código Python está abundantemente disponible en repositorios de código como GitHub, que podemos usar para crear un conjunto de datos extrayendo cada repositorio de Python. Este fue el enfoque adoptado en el libro de texto de Transformers para preentrenar un gran modelo GPT-2. Usando un volcado de GitHub de aproximadamente 180 GB que contenía aproximadamente 20 millones de archivos Python llamado codeparrot, los autores construyeron un conjunto de datos que luego compartieron en el Hugging Face Hub.
Sin embargo, entrenar con el corpus completo consume tiempo y recursos computacionales, y solo necesitamos el subconjunto del conjunto de datos relacionado con el stack de ciencia de datos de Python. Entonces, comencemos filtrando el conjunto de datos codeparrot para todos los archivos que incluyen cualquiera de las librerías de este stack. Debido al tamaño del conjunto de datos, queremos evitar descargarlo; en su lugar, usaremos la función de streaming para filtrarlo sobre la marcha. Para ayudarnos a filtrar las muestras de código usando las librerías que mencionamos anteriormente, usaremos la siguiente función:
def any_keyword_in_string(string, keywords):
    for keyword in keywords:
        if keyword in string:
            return True
    return False
Probémoslo con dos ejemplos:
filters = ["pandas", "sklearn", "matplotlib", "seaborn"]
example_1 = "import numpy as np"
example_2 = "import pandas as pd"

print(
    any_keyword_in_string(example_1, filters), any_keyword_in_string(example_2, filters)
)
False True
Podemos usar esto para crear una función que transmitirá el conjunto de datos y filtrará los elementos que queremos:
from collections import defaultdict
from tqdm import tqdm
from datasets import Dataset


def filter_streaming_dataset(dataset, filters):
    filtered_dict = defaultdict(list)
    total = 0
    for sample in tqdm(iter(dataset)):
        total += 1
        if any_keyword_in_string(sample["content"], filters):
            for k, v in sample.items():
                filtered_dict[k].append(v)
    print(f"{len(filtered_dict['content'])/total:.2%} of data after filtering.")
    return Dataset.from_dict(filtered_dict)
Luego podemos simplemente aplicar esta función al conjunto de datos de streaming:
# This cell will take a very long time to execute, so you should skip it and go to
# the next one!
from datasets import load_dataset

split = "train"  # "valid"
filters = ["pandas", "sklearn", "matplotlib", "seaborn"]

data = load_dataset(f"transformersbook/codeparrot-{split}", split=split, streaming=True)
filtered_data = filter_streaming_dataset(data, filters)
3.26% of data after filtering.
Esto nos deja con aproximadamente el 3% del conjunto de datos original, lo cual sigue siendo bastante considerable: ¡el conjunto de datos resultante es de 6 GB y consiste en 600,000 scripts de Python!
Filtrar el conjunto de datos completo puede tardar de 2 a 3 horas, dependiendo de tu máquina y ancho de banda. Si no quieres pasar por este largo proceso, te proporcionamos el conjunto de datos filtrado en el Hub para que lo descargues:
from datasets import load_dataset, DatasetDict

ds_train = load_dataset("huggingface-course/codeparrot-ds-train", split="train")
ds_valid = load_dataset("huggingface-course/codeparrot-ds-valid", split="validation")

raw_datasets = DatasetDict(
    {
        "train": ds_train,  # .shuffle().select(range(50000)),
        "valid": ds_valid,  # .shuffle().select(range(500))
    }
)

raw_datasets
DatasetDict({
    train: Dataset({
        features: ['repo_name', 'path', 'copies', 'size', 'content', 'license'],
        num_rows: 606720
    })
    valid: Dataset({
        features: ['repo_name', 'path', 'copies', 'size', 'content', 'license'],
        num_rows: 3322
    })
})
[!TIP] Preentrenar el modelo de lenguaje tomará un tiempo. Te sugerimos que primero ejecutes el ciclo de entrenamiento en una muestra de los datos, descomentando las dos líneas parciales anteriores, y te asegures de que el entrenamiento se complete con éxito y los modelos se almacenen. ¡Nada es más frustrante que un entrenamiento que falla en el último paso porque olvidaste crear una carpeta o porque hay un error tipográfico al final del ciclo de entrenamiento!
Veamos un ejemplo del conjunto de datos. Solo mostraremos los primeros 200 caracteres de cada campo:
for key in raw_datasets["train"][0]:
    print(f"{key.upper()}: {raw_datasets['train'][0][key][:200]}")
'REPO_NAME: kmike/scikit-learn'
'PATH: sklearn/utils/__init__.py'
'COPIES: 3'
'SIZE: 10094'
'''CONTENT: """
The :mod:`sklearn.utils` module includes various utilites.
"""

from collections import Sequence


from scipy.sparse import issparse


from .murmurhash import murm
LICENSE: bsd-3-clause'''
Podemos ver que el campo content contiene el código con el que queremos que nuestro modelo entrene. Ahora que tenemos un conjunto de datos, necesitamos preparar los textos para que estén en un formato adecuado para el preentrenamiento.
Preparando el conjunto de datos[[preparing-the-dataset]]
El primer paso será tokenizar los datos para poder usarlos en el entrenamiento. Dado que nuestro objetivo es principalmente autocompletar llamadas a funciones cortas, podemos mantener el tamaño del contexto relativamente pequeño. Esto tiene el beneficio de que podemos entrenar el modelo mucho más rápido y requiere significativamente menos memoria. Si es importante para tu aplicación tener más contexto (por ejemplo, si quieres que el modelo escriba pruebas unitarias basadas en un archivo con la definición de la función), asegúrate de aumentar ese número, pero también ten en cuenta que esto conlleva una mayor huella de memoria de GPU. Por ahora, fijemos el tamaño del contexto en 128 tokens, a diferencia de los 1,024 o 2,048 usados en GPT-2 o GPT-3, respectivamente.
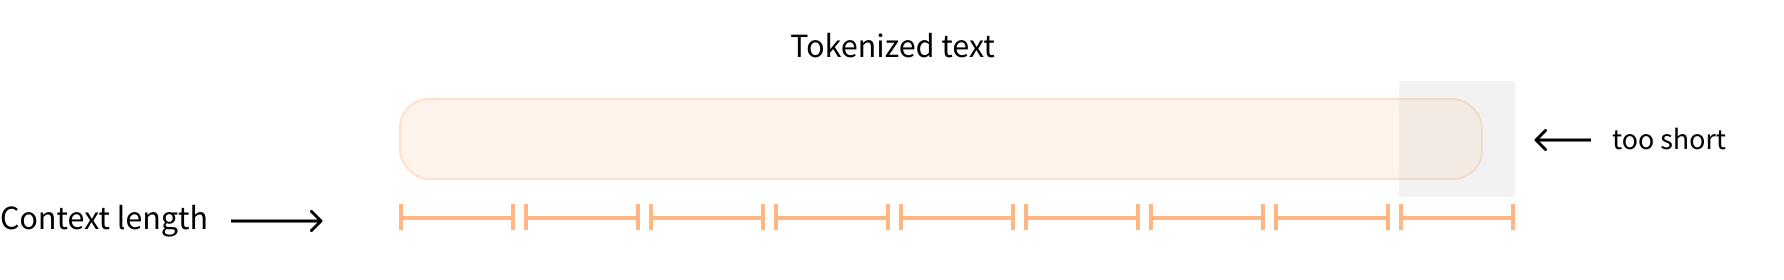
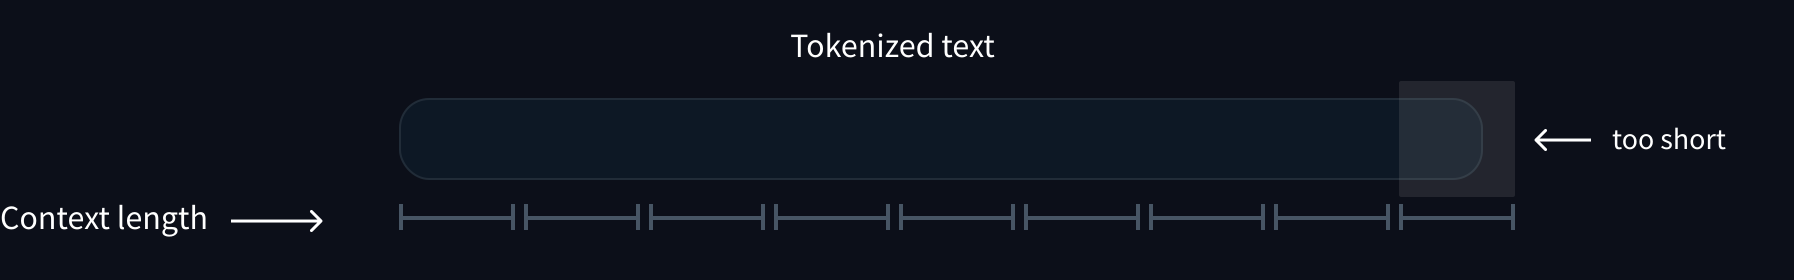
La mayoría de los documentos contienen muchos más de 128 tokens, por lo que simplemente truncar las entradas a la longitud máxima eliminaría una gran fracción de nuestro conjunto de datos. En su lugar, usaremos la opción return_overflowing_tokens para tokenizar toda la entrada y dividirla en varios fragmentos, como hicimos en el Capítulo 6. También usaremos la opción return_length para devolver automáticamente la longitud de cada fragmento creado. A menudo, el último fragmento será más pequeño que el tamaño del contexto, y nos desharemos de estas piezas para evitar problemas de relleno; realmente no las necesitamos, ya que tenemos muchos datos de todos modos.
Veamos exactamente cómo funciona esto observando los dos primeros ejemplos:
from transformers import AutoTokenizer

context_length = 128
tokenizer = AutoTokenizer.from_pretrained("huggingface-course/code-search-net-tokenizer")

outputs = tokenizer(
    raw_datasets["train"][:2]["content"],
    truncation=True,
    max_length=context_length,
    return_overflowing_tokens=True,
    return_length=True,
)

print(f"Input IDs length: {len(outputs['input_ids'])}")
print(f"Input chunk lengths: {(outputs['length'])}")
print(f"Chunk mapping: {outputs['overflow_to_sample_mapping']}")
Input IDs length: 34
Input chunk lengths: [128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 117, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 128, 41]
Chunk mapping: [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]
Podemos ver que obtenemos 34 segmentos en total de esos dos ejemplos. Observando las longitudes de los fragmentos, podemos ver que los fragmentos al final de ambos documentos tienen menos de 128 tokens (117 y 41, respectivamente). Estos representan solo una pequeña fracción del total de fragmentos que tenemos, por lo que podemos descartarlos con seguridad. Con el campo overflow_to_sample_mapping, también podemos reconstruir qué fragmentos pertenecían a qué muestras de entrada.
Con esta operación estamos usando una característica útil de la función Dataset.map() en 🤗 Datasets, que es que no requiere mapas uno a uno; como vimos en la sección 3, podemos crear lotes con más o menos elementos que el lote de entrada. Esto es útil al realizar operaciones como el aumento o filtrado de datos que cambian el número de elementos. En nuestro caso, al tokenizar cada elemento en fragmentos del tamaño de contexto especificado, creamos muchas muestras de cada documento. Solo necesitamos asegurarnos de eliminar las columnas existentes, ya que tienen un tamaño conflictivo. Si quisiéramos conservarlas, podríamos repetirlas apropiadamente y devolverlas dentro de la llamada Dataset.map():
def tokenize(element):
    outputs = tokenizer(
        element["content"],
        truncation=True,
        max_length=context_length,
        return_overflowing_tokens=True,
        return_length=True,
    )
    input_batch = []
    for length, input_ids in zip(outputs["length"], outputs["input_ids"]):
        if length == context_length:
            input_batch.append(input_ids)
    return {"input_ids": input_batch}


tokenized_datasets = raw_datasets.map(
    tokenize, batched=True, remove_columns=raw_datasets["train"].column_names
)
tokenized_datasets
DatasetDict({
    train: Dataset({
        features: ['input_ids'],
        num_rows: 16702061
    })
    valid: Dataset({
        features: ['input_ids'],
        num_rows: 93164
    })
})
Ahora tenemos 16.7 millones de ejemplos con 128 tokens cada uno, lo que corresponde a aproximadamente 2.1 mil millones de tokens en total. Como referencia, los modelos GPT-3 y Codex de OpenAI se entrenan con 300 y 100 mil millones de tokens, respectivamente, donde los modelos Codex se inicializan a partir de los puntos de control de GPT-3. Nuestro objetivo en esta sección no es competir con estos modelos, que pueden generar textos largos y coherentes, sino crear una versión reducida que proporcione una función de autocompletado rápido para científicos de datos.
Ahora que tenemos el conjunto de datos listo, ¡configuremos el modelo!
[!TIP] ✏️ ¡Pruébalo! Deshacerse de todos los fragmentos que son más pequeños que el tamaño del contexto no fue un gran problema aquí porque estamos usando ventanas de contexto pequeñas. A medida que aumentes el tamaño del contexto (o si tienes un corpus de documentos cortos), la fracción de fragmentos que se descartan también crecerá. Una forma más eficiente de preparar los datos es unir todas las muestras tokenizadas en un lote con un token
eos_token_iden el medio, y luego realizar el troceado en las secuencias concatenadas. Como ejercicio, modifica la funcióntokenize()para que use ese enfoque. Ten en cuenta que querrás establecertruncation=Falsey eliminar los otros argumentos del tokenizador para obtener la secuencia completa de IDs de token.
Inicializando un nuevo modelo[[initializing-a-new-model]]
Nuestro primer paso es inicializar un modelo GPT-2 desde cero. Usaremos la misma configuración para nuestro modelo que para el modelo GPT-2 pequeño, así que cargamos la configuración preentrenada, nos aseguramos de que el tamaño del tokenizador coincida con el tamaño del vocabulario del modelo y pasamos los IDs de token bos y eos (principio y fin de secuencia):
{#if fw === 'pt'}
from transformers import AutoTokenizer, GPT2LMHeadModel, AutoConfig

config = AutoConfig.from_pretrained(
    "gpt2",
    vocab_size=len(tokenizer),
    n_ctx=context_length,
    bos_token_id=tokenizer.bos_token_id,
    eos_token_id=tokenizer.eos_token_id,
)
Con esa configuración, podemos cargar un nuevo modelo. Ten en cuenta que esta es la primera vez que no usamos la función from_pretrained(), ya que en realidad estamos inicializando un modelo nosotros mismos:
model = GPT2LMHeadModel(config)
model_size = sum(t.numel() for t in model.parameters())
print(f"GPT-2 size: {model_size/1000**2:.1f}M parameters")
GPT-2 size: 124.2M parameters
{:else}
from transformers import AutoTokenizer, TFGPT2LMHeadModel, AutoConfig

config = AutoConfig.from_pretrained(
    "gpt2",
    vocab_size=len(tokenizer),
    n_ctx=context_length,
    bos_token_id=tokenizer.bos_token_id,
    eos_token_id=tokenizer.eos_token_id,
)
Con esa configuración, podemos cargar un nuevo modelo. Ten en cuenta que esta es la primera vez que no usamos la función from_pretrained(), ya que en realidad estamos inicializando un modelo nosotros mismos:
model = TFGPT2LMHeadModel(config)
model(model.dummy_inputs)  # Builds the model
model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
transformer (TFGPT2MainLayer multiple                  124242432
=================================================================
Total params: 124,242,432
Trainable params: 124,242,432
Non-trainable params: 0
_________________________________________________________________
{/if}
Nuestro modelo tiene 124M parámetros que tendremos que ajustar. Antes de que podamos empezar a entrenar, necesitamos configurar un recopilador de datos que se encargará de crear los lotes. Podemos usar el recopilador DataCollatorForLanguageModeling, que está diseñado específicamente para el modelado de lenguaje (como el nombre sugiere sutilmente). Además de apilar y rellenar lotes, también se encarga de crear las etiquetas del modelo de lenguaje; en el modelado de lenguaje causal, las entradas también sirven como etiquetas (simplemente desplazadas un elemento), y este recopilador de datos las crea sobre la marcha durante el entrenamiento para que no necesitemos duplicar las input_ids.
Ten en cuenta que DataCollatorForLanguageModeling soporta tanto el modelado de lenguaje enmascarado (MLM) como el modelado de lenguaje causal (CLM). Por defecto, prepara los datos para MLM, pero podemos cambiar a CLM configurando el argumento mlm=False:
{#if fw === 'pt'}
from transformers import DataCollatorForLanguageModeling

tokenizer.pad_token = tokenizer.eos_token
data_collator = DataCollatorForLanguageModeling(tokenizer, mlm=False)
{:else}
from transformers import DataCollatorForLanguageModeling

tokenizer.pad_token = tokenizer.eos_token
data_collator = DataCollatorForLanguageModeling(tokenizer, mlm=False, return_tensors="tf")
{/if}
Echemos un vistazo a un ejemplo:
out = data_collator([tokenized_datasets["train"][i] for i in range(5)])
for key in out:
    print(f"{key} shape: {out[key].shape}")
{#if fw === 'pt'}
input_ids shape: torch.Size([5, 128])
attention_mask shape: torch.Size([5, 128])
labels shape: torch.Size([5, 128])
{:else}
input_ids shape: (5, 128)
attention_mask shape: (5, 128)
labels shape: (5, 128)
{/if}
Podemos ver que los ejemplos han sido apilados y todos los tensores tienen la misma forma.
{#if fw === 'tf'}
Ahora podemos usar el método prepare_tf_dataset() para convertir nuestros conjuntos de datos en conjuntos de datos de TensorFlow con el recopilador de datos que creamos anteriormente:
tf_train_dataset = model.prepare_tf_dataset(
    tokenized_datasets["train"],
    collate_fn=data_collator,
    shuffle=True,
    batch_size=32,
)
tf_eval_dataset = model.prepare_tf_dataset(
    tokenized_datasets["valid"],
    collate_fn=data_collator,
    shuffle=False,
    batch_size=32,
)
{/if}
[!WARNING] ⚠️ El desplazamiento de las entradas y etiquetas para alinearlas ocurre dentro del modelo, por lo que el recopilador de datos simplemente copia las entradas para crear las etiquetas.
Ahora tenemos todo listo para entrenar nuestro modelo, ¡después de todo no fue tanto trabajo! Antes de comenzar a entrenar, debemos iniciar sesión en Hugging Face. Si estás trabajando en un notebook, puedes hacerlo con la siguiente función de utilidad:
from huggingface_hub import notebook_login

notebook_login()
Esto mostrará un widget donde puedes ingresar tus credenciales de inicio de sesión de Hugging Face.
Si no estás trabajando en un notebook, simplemente escribe la siguiente línea en tu terminal:
huggingface-cli login
{#if fw === 'pt'}
Todo lo que queda por hacer es configurar los argumentos de entrenamiento y encender el Trainer. Usaremos un programa de tasa de aprendizaje de coseno con algo de calentamiento y un tamaño de lote efectivo de 256 (per_device_train_batch_size * gradient_accumulation_steps). La acumulación de gradientes se usa cuando un solo lote no cabe en la memoria, y construye incrementalmente el gradiente a través de varias pasadas hacia adelante/hacia atrás. Veremos esto en acción cuando creemos el ciclo de entrenamiento con 🤗 Accelerate.
from transformers import Trainer, TrainingArguments

args = TrainingArguments(
    output_dir="codeparrot-ds",
    per_device_train_batch_size=32,
    per_device_eval_batch_size=32,
    evaluation_strategy="steps",
    eval_steps=5_000,
    logging_steps=5_000,
    gradient_accumulation_steps=8,
    num_train_epochs=1,
    weight_decay=0.1,
    warmup_steps=1_000,
    lr_scheduler_type="cosine",
    learning_rate=5e-4,
    save_steps=5_000,
    fp16=True,
    push_to_hub=True,
)

trainer = Trainer(
    model=model,
    tokenizer=tokenizer,
    args=args,
    data_collator=data_collator,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["valid"],
)
Ahora podemos simplemente iniciar el Trainer y esperar a que termine el entrenamiento. Dependiendo de si lo ejecutas en el conjunto de entrenamiento completo o en un subconjunto, esto tomará 20 o 2 horas, respectivamente, ¡así que tómate unos cafés y un buen libro para leer!
trainer.train()
Una vez que el entrenamiento se complete, podemos subir el modelo y el tokenizador al Hub:
trainer.push_to_hub()
{:else}
Todo lo que queda por hacer es configurar los hiperparámetros de entrenamiento y llamar a compile() y fit(). Usaremos un programa de tasa de aprendizaje con algo de calentamiento para mejorar la estabilidad del entrenamiento:
from transformers import create_optimizer


num_train_steps = len(tf_train_dataset)
optimizer, schedule = create_optimizer(
    init_lr=5e-5,
    num_warmup_steps=1_000,
    num_train_steps=num_train_steps,
    weight_decay_rate=0.01,
)
model.compile(optimizer=optimizer)

# Train in mixed-precision float16
tf.keras.mixed_precision.set_global_policy("mixed_float16")
Ahora podemos simplemente llamar a model.fit() y esperar a que termine el entrenamiento. Dependiendo de si lo ejecutas en el conjunto de entrenamiento completo o en un subconjunto, esto tomará 20 o 2 horas, respectivamente, ¡así que tómate unos cafés y un buen libro para leer! Una vez que el entrenamiento se complete, podemos subir el modelo y el tokenizador al Hub:
from transformers.keras_callbacks import PushToHubCallback

callback = PushToHubCallback(output_dir="codeparrot-ds", tokenizer=tokenizer)

model.fit(tf_train_dataset, validation_data=tf_eval_dataset, callbacks=[callback])
{/if}
[!TIP] ✏️ ¡Pruébalo! Solo nos tomó unas 30 líneas de código, además del
TrainingArguments, pasar de textos sin procesar a entrenar GPT-2. ¡Pruébalo con tu propio conjunto de datos y ve si puedes obtener buenos resultados!
[!TIP] {#if fw === 'pt'}
💡 Si tienes acceso a una máquina con múltiples GPUs, intenta ejecutar el código allí. El
Trainergestiona automáticamente múltiples máquinas, y esto puede acelerar enormemente el entrenamiento.{:else}
💡 Si tienes acceso a una máquina con múltiples GPUs, puedes intentar usar un contexto
MirroredStrategypara acelerar sustancialmente el entrenamiento. Necesitarás crear un objetotf.distribute.MirroredStrategyy asegurarte de que cualquier métodoto_tf_dataset()oprepare_tf_dataset(), así como la creación del modelo y la llamada afit(), se ejecuten en su contextoscope(). Puedes ver la documentación sobre esto aquí.{/if}
Generación de código con un pipeline[[code-generation-with-a-pipeline]]
Ahora es el momento de la verdad: ¡veamos qué tan bien funciona el modelo entrenado! Podemos ver en los registros que la pérdida disminuyó constantemente, pero para poner a prueba el modelo, veamos qué tan bien funciona con algunas indicaciones. Para hacerlo, envolveremos el modelo en un pipeline de generación de texto, y lo pondremos en la GPU para generaciones rápidas si hay una disponible:
{#if fw === 'pt'}
from transformers import pipeline

device = torch.device("cuda") if torch.cuda.is_available() else torch.device("cpu")
pipe = pipeline(
    "text-generation", model="huggingface-course/codeparrot-ds", device=device
)
{:else}
from transformers import pipeline

course_model = TFGPT2LMHeadModel.from_pretrained("huggingface-course/codeparrot-ds")
course_tokenizer = AutoTokenizer.from_pretrained("huggingface-course/codeparrot-ds")
pipe = pipeline(
    "text-generation", model=course_model, tokenizer=course_tokenizer, device=0
)
{/if}
Comencemos con la sencilla tarea de crear un diagrama de dispersión:
txt = """\
# create some data
x = np.random.randn(100)
y = np.random.randn(100)

# create scatter plot with x, y
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# create some data
x = np.random.randn(100)
y = np.random.randn(100)

# create scatter plot with x, y
plt.scatter(x, y)

# create scatter
El resultado parece correcto. ¿También funciona para una operación pandas? Veamos si podemos crear un DataFrame a partir de dos arrays:
txt = """\
# create some data
x = np.random.randn(100)
y = np.random.randn(100)

# create dataframe from x and y
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# create some data
x = np.random.randn(100)
y = np.random.randn(100)

# create dataframe from x and y
df = pd.DataFrame({'x': x, 'y': y})
df.insert(0,'x', x)
for
Bien, esa es la respuesta correcta, aunque luego inserta la columna x de nuevo. Dado que el número de tokens generados es limitado, el siguiente bucle for se corta. Veamos si podemos hacer algo un poco más complejo y hacer que el modelo nos ayude a usar la operación groupby:
txt = """\
# dataframe with profession, income and name
df = pd.DataFrame({'profession': x, 'income':y, 'name': z})

# calculate the mean income per profession
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# dataframe with profession, income and name
df = pd.DataFrame({'profession': x, 'income':y, 'name': z})

# calculate the mean income per profession
profession = df.groupby(['profession']).mean()

# compute the
No está mal; esa es la forma correcta de hacerlo. Finalmente, veamos si también podemos usarlo para scikit-learn y configurar un modelo de Random Forest:
txt = """
# import random forest regressor from scikit-learn
from sklearn.ensemble import RandomForestRegressor

# fit random forest model with 300 estimators on X, y:
"""
print(pipe(txt, num_return_sequences=1)[0]["generated_text"])
# import random forest regressor from scikit-learn
from sklearn.ensemble import RandomForestRegressor

# fit random forest model with 300 estimators on X, y:
rf = RandomForestRegressor(n_estimators=300, random_state=random_state, max_depth=3)
rf.fit(X, y)
rf
{#if fw === 'tf'}
Observando estos pocos ejemplos, parece que el modelo ha aprendido parte de la sintaxis del stack de ciencia de datos de Python. Por supuesto, necesitaríamos evaluar el modelo más a fondo antes de implementarlo en el mundo real, pero este sigue siendo un prototipo impresionante.
{:else}
Observando estos pocos ejemplos, parece que el modelo ha aprendido parte de la sintaxis del stack de ciencia de datos de Python (por supuesto, necesitaríamos evaluarlo más a fondo antes de implementar el modelo en el mundo real). Sin embargo, a veces se requiere más personalización del entrenamiento del modelo para lograr el rendimiento necesario para un caso de uso dado. Por ejemplo, ¿qué pasaría si quisiéramos actualizar dinámicamente el tamaño del lote o tener un ciclo de entrenamiento condicional que omita los ejemplos incorrectos sobre la marcha? Una opción sería subclasificar el Trainer y agregar los cambios necesarios, pero a veces es más simple escribir el ciclo de entrenamiento desde cero. Ahí es donde entra en juego 🤗 Accelerate.
{/if}
{#if fw === 'pt'}
Entrenando con 🤗 Accelerate[[training-with-accelerate]]
Hemos visto cómo entrenar un modelo con el Trainer, lo que permite cierta personalización. Sin embargo, a veces queremos un control total sobre el ciclo de entrenamiento, o queremos hacer algunos cambios exóticos. En este caso, 🤗 Accelerate es una excelente opción, y en esta sección repasaremos los pasos para usarlo para entrenar nuestro modelo. Para hacer las cosas más interesantes, también agregaremos un giro al ciclo de entrenamiento.
Dado que estamos principalmente interesados en el autocompletado sensato para las librerías de ciencia de datos, tiene sentido dar más peso a las muestras de entrenamiento que hacen un mayor uso de estas librerías. Podemos identificar fácilmente estos ejemplos mediante el uso de palabras clave como plt, pd, sk, fit y predict, que son los nombres de importación más frecuentes para matplotlib.pyplot, pandas y sklearn, así como el patrón fit/predict de este último. Si cada uno de estos se representa como un solo token, podemos verificar fácilmente si ocurren en la secuencia de entrada. Los tokens pueden tener un prefijo de espacio en blanco, por lo que también verificaremos esas versiones en el vocabulario del tokenizador. Para verificar que funciona, agregaremos un token de prueba que debería dividirse en múltiples tokens:
keytoken_ids = []
for keyword in [
    "plt",
    "pd",
    "sk",
    "fit",
    "predict",
    " plt",
    " pd",
    " sk",
    " fit",
    " predict",
    "testtest",
]:
    ids = tokenizer([keyword]).input_ids[0]
    if len(ids) == 1:
        keytoken_ids.append(ids[0])
    else:
        print(f"Keyword has not single token: {keyword}")
'Keyword has not single token: testtest'
¡Genial, eso parece funcionar muy bien! Ahora podemos escribir una función de pérdida personalizada que tome la secuencia de entrada, los logits y los tokens clave que acabamos de seleccionar como entradas. Primero necesitamos alinear los logits y las entradas: la secuencia de entrada desplazada una posición a la derecha forma las etiquetas, ya que el siguiente token es la etiqueta para el token actual. Podemos lograr esto comenzando las etiquetas desde el segundo token de la secuencia de entrada, ya que el modelo no hace una predicción para el primer token de todos modos. Luego cortamos el último logit, ya que no tenemos una etiqueta para el token que sigue a la secuencia de entrada completa. Con eso podemos calcular la pérdida por muestra y contar las ocurrencias de todas las palabras clave en cada muestra. Finalmente, calculamos el promedio ponderado sobre todas las muestras usando las ocurrencias como pesos. Como no queremos descartar todas las muestras que no tienen palabras clave, agregamos 1 a los pesos:
from torch.nn import CrossEntropyLoss


def keytoken_weighted_loss(inputs, logits, keytoken_ids, alpha=1.0):
    # Shift so that tokens < n predict n
    shift_labels = inputs[..., 1:].contiguous()
    shift_logits = logits[..., :-1, :].contiguous()
    # Calculate per-token loss
    loss_fct = CrossEntropyLoss(reduce=False)
    loss = loss_fct(shift_logits.view(-1, shift_logits.size(-1)), shift_labels.view(-1))
    # Resize and average loss per sample
    loss_per_sample = loss.view(shift_logits.size(0), shift_logits.size(1)).mean(axis=1)
    # Calculate and scale weighting
    weights = torch.stack([(inputs == kt).float() for kt in keytoken_ids]).sum(
        axis=[0, 2]
    )
    weights = alpha * (1.0 + weights)
    # Calculate weighted average
    weighted_loss = (loss_per_sample * weights).mean()
    return weighted_loss
Antes de que podamos empezar a entrenar con esta increíble nueva función de pérdida, necesitamos preparar algunas cosas:
- Necesitamos cargadores de datos para cargar los datos en lotes.
- Necesitamos configurar los parámetros de decaimiento de peso.
- De vez en cuando queremos evaluar, por lo que tiene sentido envolver el código de evaluación en una función.
Comencemos con los cargadores de datos. Solo necesitamos establecer el formato del conjunto de datos en "torch", y luego podemos pasarlo a un DataLoader de PyTorch con el tamaño de lote apropiado:
from torch.utils.data.dataloader import DataLoader

tokenized_datasets.set_format("torch")
train_dataloader = DataLoader(tokenized_datasets["train"], batch_size=32, shuffle=True)
eval_dataloader = DataLoader(tokenized_datasets["valid"], batch_size=32)
A continuación, agrupamos los parámetros para que el optimizador sepa cuáles obtendrán un decaimiento de peso adicional. Por lo general, todos los términos de sesgo y pesos de LayerNorm están exentos de esto; así es como podemos hacerlo:
weight_decay = 0.1


def get_grouped_params(model, no_decay=["bias", "LayerNorm.weight"]):
    params_with_wd, params_without_wd = [], []
    for n, p in model.named_parameters():
        if any(nd in n for nd in no_decay):
            params_without_wd.append(p)
        else:
            params_with_wd.append(p)
    return [
        {"params": params_with_wd, "weight_decay": weight_decay},
        {"params": params_without_wd, "weight_decay": 0.0},
    ]
Dado que queremos evaluar el modelo regularmente en el conjunto de validación durante el entrenamiento, escribamos también una función para eso. Simplemente recorre el cargador de datos de evaluación y recopila todas las pérdidas en todos los procesos:
def evaluate():
    model.eval()
    losses = []
    for step, batch in enumerate(eval_dataloader):
        with torch.no_grad():
            outputs = model(batch["input_ids"], labels=batch["input_ids"])

        losses.append(accelerator.gather(outputs.loss))
    loss = torch.mean(torch.cat(losses))
    try:
        perplexity = torch.exp(loss)
    except OverflowError:
        perplexity = float("inf")
    return loss.item(), perplexity.item()
Con la función evaluate() podemos reportar la pérdida y la perplejidad a intervalos regulares. A continuación, redefinimos nuestro modelo para asegurarnos de que entrenamos desde cero de nuevo:
model = GPT2LMHeadModel(config)
Luego podemos definir nuestro optimizador, usando la función de antes para dividir los parámetros para el decaimiento de peso:
from torch.optim import AdamW

optimizer = AdamW(get_grouped_params(model), lr=5e-4)
Ahora preparemos el modelo, el optimizador y los cargadores de datos para que podamos comenzar a entrenar:
from accelerate import Accelerator

accelerator = Accelerator(fp16=True)

model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
[!TIP] 🚨 Si estás entrenando en una TPU, necesitarás mover todo el código a partir de la celda anterior a una función de entrenamiento dedicada. Consulta el Capítulo 3 para más detalles.
Ahora que hemos enviado nuestro train_dataloader a accelerator.prepare(), podemos usar su longitud para calcular el número de pasos de entrenamiento. Recuerda que siempre debemos hacer esto después de preparar el cargador de datos, ya que ese método cambiará su longitud. Usamos un programa lineal clásico desde la tasa de aprendizaje hasta 0:
from transformers import get_scheduler

num_train_epochs = 1
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    name="linear",
    optimizer=optimizer,
    num_warmup_steps=1_000,
    num_training_steps=num_training_steps,
)
Por último, para subir nuestro modelo al Hub, necesitaremos crear un objeto Repository en una carpeta de trabajo. Primero inicia sesión en Hugging Face Hub, si aún no lo has hecho. Determinaremos el nombre del repositorio a partir del ID del modelo que queremos darle a nuestro modelo (siéntete libre de reemplazar el repo_name con tu propia elección; solo necesita contener tu nombre de usuario, que es lo que hace la función get_full_repo_name()):
from huggingface_hub import Repository, get_full_repo_name

model_name = "codeparrot-ds-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'sgugger/codeparrot-ds-accelerate'
Luego podemos clonar ese repositorio en una carpeta local. Si ya existe, esta carpeta local debe ser un clon existente del repositorio con el que estamos trabajando:
output_dir = "codeparrot-ds-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
Ahora podemos subir cualquier cosa que guardemos en output_dir llamando al método repo.push_to_hub(). Esto nos ayudará a subir los modelos intermedios al final de cada época.
Antes de entrenar, hagamos una prueba rápida para ver si la función de evaluación funciona correctamente:
evaluate()
(10.934126853942871, 56057.14453125)
Esos son valores muy altos para la pérdida y la perplejidad, pero eso no es sorprendente ya que aún no hemos entrenado el modelo. Con eso, tenemos todo preparado para escribir la parte central del script de entrenamiento: el ciclo de entrenamiento. En el ciclo de entrenamiento iteramos sobre el cargador de datos y pasamos los lotes al modelo. Con los logits, podemos evaluar nuestra función de pérdida personalizada. Escalamos la pérdida por el número de pasos de acumulación de gradientes para no crear pérdidas mayores al agregar más pasos. Antes de optimizar, también recortamos los gradientes para una mejor convergencia. Finalmente, cada pocos pasos evaluamos el modelo en el conjunto de evaluación con nuestra nueva función evaluate():
from tqdm.notebook import tqdm

gradient_accumulation_steps = 8
eval_steps = 5_000

model.train()
completed_steps = 0
for epoch in range(num_train_epochs):
    for step, batch in tqdm(
        enumerate(train_dataloader, start=1), total=num_training_steps
    ):
        logits = model(batch["input_ids"]).logits
        loss = keytoken_weighted_loss(batch["input_ids"], logits, keytoken_ids)
        if step % 100 == 0:
            accelerator.print(
                {
                    "samples": step * samples_per_step,
                    "steps": completed_steps,
                    "loss/train": loss.item() * gradient_accumulation_steps,
                }
            )
        loss = loss / gradient_accumulation_steps
        accelerator.backward(loss)
        if step % gradient_accumulation_steps == 0:
            accelerator.clip_grad_norm_(model.parameters(), 1.0)
            optimizer.step()
            lr_scheduler.step()
            optimizer.zero_grad()
            completed_steps += 1
        if (step % (eval_steps * gradient_accumulation_steps)) == 0:
            eval_loss, perplexity = evaluate()
            accelerator.print({"loss/eval": eval_loss, "perplexity": perplexity})
            model.train()
            accelerator.wait_for_everyone()
            unwrapped_model = accelerator.unwrap_model(model)
            unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
            if accelerator.is_main_process:
                tokenizer.save_pretrained(output_dir)
                repo.push_to_hub(
                    commit_message=f"Training in progress step {step}", blocking=False
                )
Y eso es todo, ahora tienes tu propio ciclo de entrenamiento personalizado para modelos de lenguaje causal como GPT-2 que puedes personalizar aún más según tus necesidades.
[!TIP] ✏️ ¡Pruébalo! Crea tu propia función de pérdida personalizada adaptada a tu caso de uso, o agrega otro paso personalizado al ciclo de entrenamiento.
[!TIP] ✏️ ¡Pruébalo! Cuando ejecutas experimentos de entrenamiento largos, es una buena idea registrar métricas importantes usando herramientas como TensorBoard o Weights & Biases. Agrega un registro adecuado al ciclo de entrenamiento para que siempre puedas verificar cómo va el entrenamiento.
{/if}