Resumen de texto con modelos Transformer
{#if fw === 'pt'}
{:else}
{/if}
En esta sección, veremos cómo se pueden usar los modelos Transformer para condensar documentos largos en resúmenes, una tarea conocida como resumen de texto. Esta es una de las tareas de PNL más desafiantes, ya que requiere una variedad de habilidades, como comprender pasajes largos y generar texto coherente que capture los temas principales de un documento. Sin embargo, cuando se hace bien, el resumen de texto es una herramienta poderosa que puede acelerar varios procesos comerciales al aliviar la carga de los expertos en el dominio de leer documentos largos en detalle.
Aunque ya existen varios modelos preentrenados para resumen en el Hugging Face Hub, casi todos ellos solo son adecuados para documentos en inglés. Así que, para darle un giro a esta sección, entrenaremos un modelo bilingüe para inglés y español. Al final de esta sección, tendrás un modelo que puede resumir reseñas de clientes como la que se muestra aquí:
Como veremos, estos resúmenes son concisos porque se aprenden de los títulos que los clientes proporcionan en sus reseñas de productos. Comencemos por armar un corpus bilingüe adecuado para esta tarea.
Preparando un corpus multilingüe[[preparing-a-multilingual-corpus]]
Usaremos el Corpus Multilingüe de Reseñas de Amazon para crear nuestro resumidor bilingüe. Este corpus consta de reseñas de productos de Amazon en seis idiomas y se usa típicamente para comparar clasificadores multilingües. Sin embargo, dado que cada reseña va acompañada de un título corto, ¡podemos usar los títulos como resúmenes objetivo para que nuestro modelo aprenda de ellos! Para empezar, descarguemos los subconjuntos en inglés y español del Hugging Face Hub:
from datasets import load_dataset

spanish_dataset = load_dataset("amazon_reviews_multi", "es")
english_dataset = load_dataset("amazon_reviews_multi", "en")
english_dataset
DatasetDict({
    train: Dataset({
        features: ['review_id', 'product_id', 'reviewer_id', 'stars', 'review_body', 'review_title', 'language', 'product_category'],
        num_rows: 200000
    })
    validation: Dataset({
        features: ['review_id', 'product_id', 'reviewer_id', 'stars', 'review_body', 'review_title', 'language', 'product_category'],
        num_rows: 5000
    })
    test: Dataset({
        features: ['review_id', 'product_id', 'reviewer_id', 'stars', 'review_body', 'review_title', 'language', 'product_category'],
        num_rows: 5000
    })
})
Como puedes ver, para cada idioma hay 200,000 reseñas para la división train, y 5,000 reseñas para cada una de las divisiones validation y test. La información de la reseña que nos interesa está contenida en las columnas review_body y review_title. Echemos un vistazo a algunos ejemplos creando una función simple que toma una muestra aleatoria del conjunto de entrenamiento con las técnicas que aprendimos en el Capítulo 5:
def show_samples(dataset, num_samples=3, seed=42):
    sample = dataset["train"].shuffle(seed=seed).select(range(num_samples))
    for example in sample:
        print(f"\n'>> Title: {example['review_title']}'")
        print(f"'>> Review: {example['review_body']}'")


show_samples(english_dataset)
'>> Title: Worked in front position, not rear'
'>> Review: 3 stars because these are not rear brakes as stated in the item description. At least the mount adapter only worked on the front fork of the bike that I got it for.'

'>> Title: meh'
'>> Review: Does it’s job and it’s gorgeous but mine is falling apart, I had to basically put it together again with hot glue'

'>> Title: Can\'t beat these for the money'
'>> Review: Bought this for handling miscellaneous aircraft parts and hanger "stuff" that I needed to organize; it really fit the bill. The unit arrived quickly, was well packaged and arrived intact (always a good sign). There are five wall mounts-- three on the top and two on the bottom. I wanted to mount it on the wall, so all I had to do was to remove the top two layers of plastic drawers, as well as the bottom corner drawers, place it when I wanted and mark it; I then used some of the new plastic screw in wall anchors (the 50 pound variety) and it easily mounted to the wall. Some have remarked that they wanted dividers for the drawers, and that they made those. Good idea. My application was that I needed something that I can see the contents at about eye level, so I wanted the fuller-sized drawers. I also like that these are the new plastic that doesn\'t get brittle and split like my older plastic drawers did. I like the all-plastic construction. It\'s heavy duty enough to hold metal parts, but being made of plastic it\'s not as heavy as a metal frame, so you can easily mount it to the wall and still load it up with heavy stuff, or light stuff. No problem there. For the money, you can\'t beat it. Best one of these I\'ve bought to date-- and I\'ve been using some version of these for over forty years.'
[!TIP] ✏️ ¡Pruébalo! Cambia la semilla aleatoria en el comando
Dataset.shuffle()para explorar otras reseñas en el corpus. Si hablas español, echa un vistazo a algunas de las reseñas enspanish_datasetpara ver si los títulos también parecen resúmenes razonables.
Esta muestra muestra la diversidad de reseñas que uno suele encontrar en línea, que van de positivas a negativas (¡y todo lo demás!). Aunque el ejemplo con el título "meh" no es muy informativo, los otros títulos parecen resúmenes decentes de las reseñas. Entrenar un modelo de resumen con las 400,000 reseñas tomaría demasiado tiempo en una sola GPU, así que en su lugar nos centraremos en generar resúmenes para un solo dominio de productos. Para tener una idea de qué dominios podemos elegir, convirtamos english_dataset a un pandas.DataFrame y calculemos el número de reseñas por categoría de producto:
english_dataset.set_format("pandas")
english_df = english_dataset["train"][:]
# Show counts for top 20 products
english_df["product_category"].value_counts()[:20]
home                      17679
apparel                   15951
wireless                  15717
other                     13418
beauty                    12091
drugstore                 11730
kitchen                   10382
toy                        8745
sports                     8277
automotive                 7506
lawn_and_garden            7327
home_improvement           7136
pet_products               7082
digital_ebook_purchase     6749
pc                         6401
electronics                6186
office_product             5521
shoes                      5197
grocery                    4730
book                       3756
Name: product_category, dtype: int64
Los productos más populares en el conjunto de datos en inglés son artículos para el hogar, ropa y electrónica inalámbrica. Sin embargo, para mantenernos en el tema de Amazon, centrémonos en resumir reseñas de libros, ¡después de todo, en esto se fundó la empresa! Podemos ver dos categorías de productos que encajan (book y digital_ebook_purchase), así que filtremos los conjuntos de datos en ambos idiomas solo para estos productos. Como vimos en el Capítulo 5, la función Dataset.filter() nos permite segmentar un conjunto de datos de manera muy eficiente, por lo que podemos definir una función simple para hacer esto:
def filter_books(example):
    return (
        example["product_category"] == "book"
        or example["product_category"] == "digital_ebook_purchase"
    )
Ahora, cuando apliquemos esta función a english_dataset y spanish_dataset, el resultado contendrá solo aquellas filas que involucren las categorías de libros. Antes de aplicar el filtro, cambiemos el formato de english_dataset de "pandas" de nuevo a "arrow":
english_dataset.reset_format()
Luego podemos aplicar la función de filtro, y como verificación de cordura, inspeccionemos una muestra de reseñas para ver si realmente tratan sobre libros:
spanish_books = spanish_dataset.filter(filter_books)
english_books = english_dataset.filter(filter_books)
show_samples(english_books)
'>> Title: I\'m dissapointed.'
'>> Review: I guess I had higher expectations for this book from the reviews. I really thought I\'d at least like it. The plot idea was great. I loved Ash but, it just didnt go anywhere. Most of the book was about their radio show and talking to callers. I wanted the author to dig deeper so we could really get to know the characters. All we know about Grace is that she is attractive looking, Latino and is kind of a brat. I\'m dissapointed.'

'>> Title: Good art, good price, poor design'
'>> Review: I had gotten the DC Vintage calendar the past two years, but it was on backorder forever this year and I saw they had shrunk the dimensions for no good reason. This one has good art choices but the design has the fold going through the picture, so it\'s less aesthetically pleasing, especially if you want to keep a picture to hang. For the price, a good calendar'

'>> Title: Helpful'
'>> Review: Nearly all the tips useful and. I consider myself an intermediate to advanced user of OneNote. I would highly recommend.'
De acuerdo, podemos ver que las reseñas no son estrictamente sobre libros y podrían referirse a cosas como calendarios y aplicaciones electrónicas como OneNote. Sin embargo, el dominio parece adecuado para entrenar un modelo de resumen. Antes de ver varios modelos adecuados para esta tarea, tenemos una última parte de preparación de datos que hacer: combinar las reseñas en inglés y español como un solo objeto DatasetDict. 🤗 Datasets proporciona una práctica función concatenate_datasets() que (como su nombre indica) apilará dos objetos Dataset uno encima del otro. Así, para crear nuestro conjunto de datos bilingüe, recorreremos cada división, concatenaremos los conjuntos de datos para esa división y mezclaremos el resultado para asegurar que nuestro modelo no se sobreajuste a un solo idioma:
from datasets import concatenate_datasets, DatasetDict

books_dataset = DatasetDict()

for split in english_books.keys():
    books_dataset[split] = concatenate_datasets(
        [english_books[split], spanish_books[split]]
    )
    books_dataset[split] = books_dataset[split].shuffle(seed=42)

# Peek at a few examples
show_samples(books_dataset)
'>> Title: Easy to follow!!!!'
'>> Review: I loved The dash diet weight loss Solution. Never hungry. I would recommend this diet. Also the menus are well rounded. Try it. Has lots of the information need thanks.'

'>> Title: PARCIALMENTE DAÑADO'
'>> Review: Me llegó el día que tocaba, junto a otros libros que pedí, pero la caja llegó en mal estado lo cual dañó las esquinas de los libros porque venían sin protección (forro).'

'>> Title: no lo he podido descargar'
'>> Review: igual que el anterior'
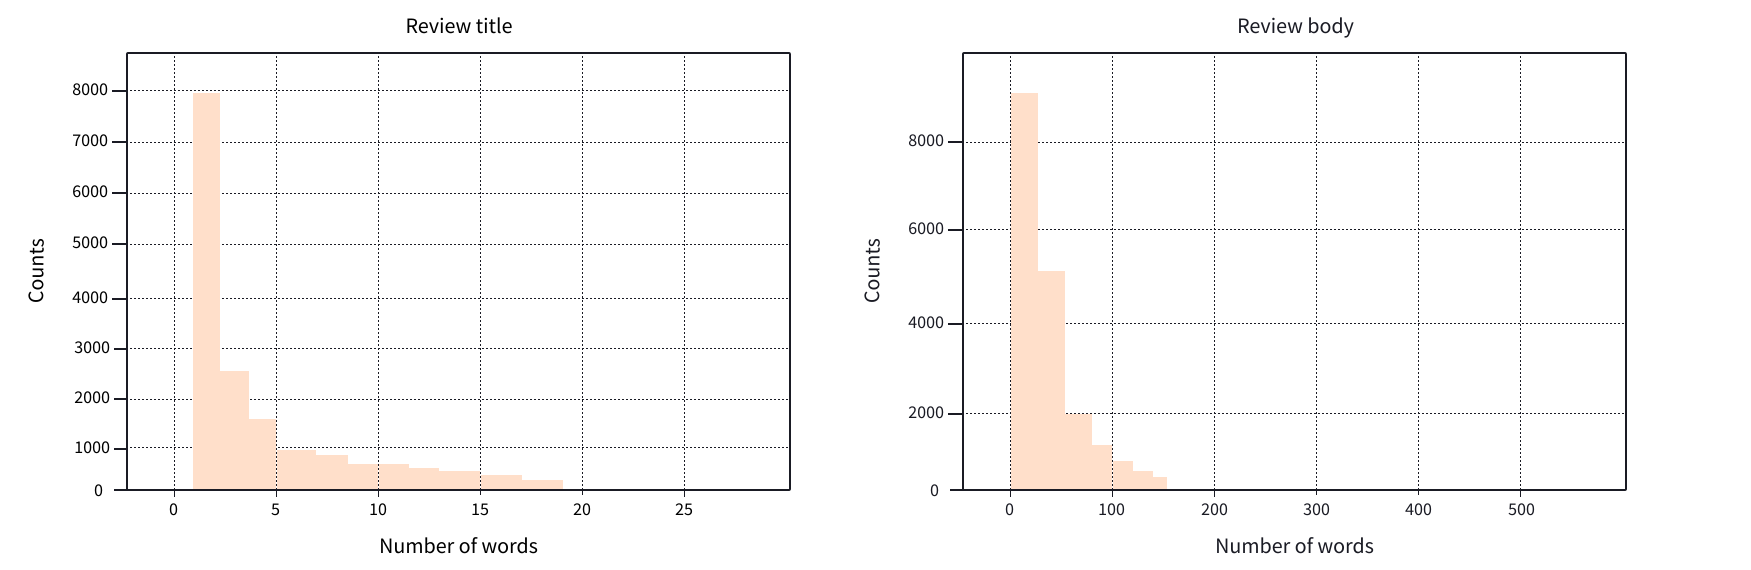
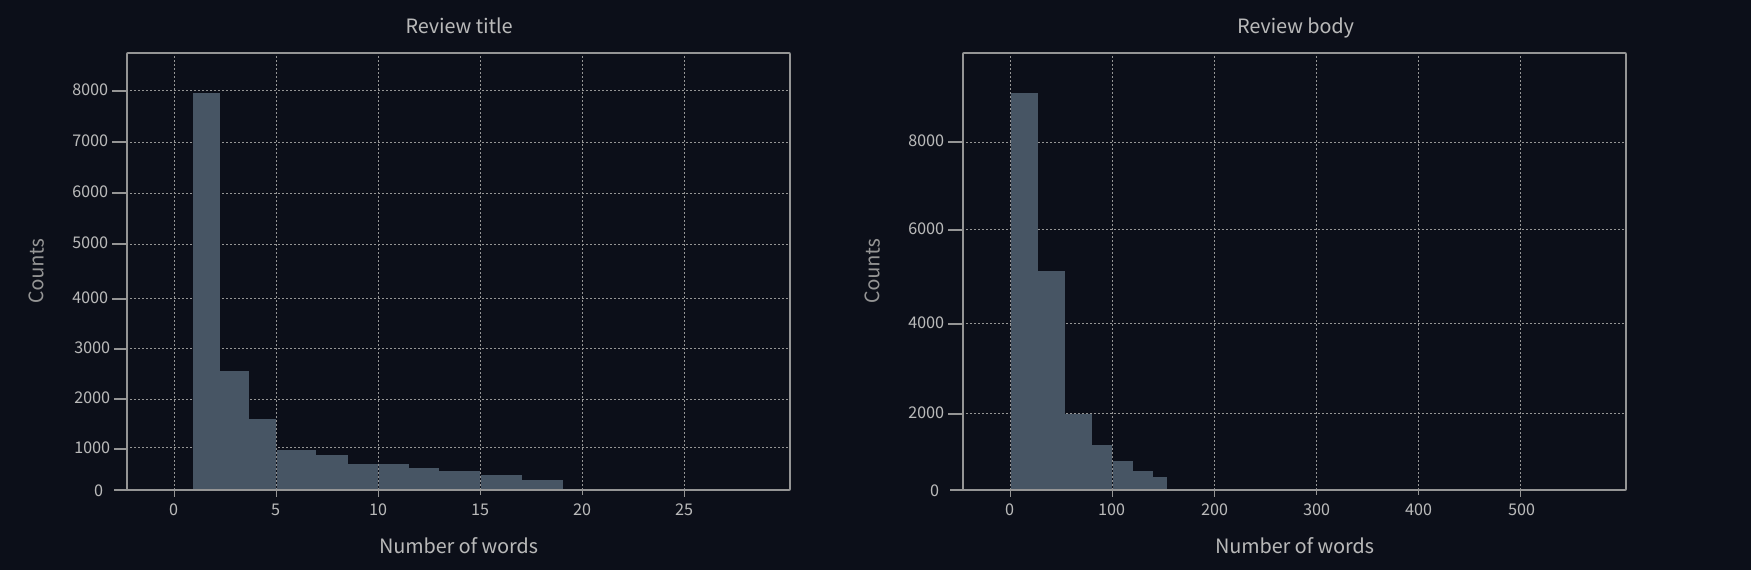
¡Esto ciertamente parece una mezcla de reseñas en inglés y español! Ahora que tenemos un corpus de entrenamiento, una última cosa que verificar es la distribución de palabras en las reseñas y sus títulos. Esto es especialmente importante para las tareas de resumen, donde los resúmenes de referencia cortos en los datos pueden sesgar el modelo para que solo genere una o dos palabras en los resúmenes generados. Los gráficos a continuación muestran las distribuciones de palabras, y podemos ver que los títulos están fuertemente sesgados hacia solo 1-2 palabras:
Para solucionar esto, filtraremos los ejemplos con títulos muy cortos para que nuestro modelo pueda producir resúmenes más interesantes. Dado que estamos tratando con textos en inglés y español, podemos usar una heurística aproximada para dividir los títulos por espacios en blanco y luego usar nuestro confiable método Dataset.filter() de la siguiente manera:
books_dataset = books_dataset.filter(lambda x: len(x["review_title"].split()) > 2)
Ahora que hemos preparado nuestro corpus, ¡echemos un vistazo a algunos posibles modelos Transformer que se podrían ajustar con él!
Modelos para resumen de texto[[models-for-text-summarization]]
Si lo piensas bien, el resumen de texto es una tarea similar a la traducción automática: tenemos un cuerpo de texto como una reseña que nos gustaría "traducir" a una versión más corta que capture las características sobresalientes de la entrada. En consecuencia, la mayoría de los modelos Transformer para resumen adoptan la arquitectura codificador-decodificador que encontramos por primera vez en el Capítulo 1, aunque hay algunas excepciones como la familia de modelos GPT que también se pueden usar para resumen en configuraciones de pocas muestras. La siguiente tabla enumera algunos modelos preentrenados populares que se pueden ajustar para resumen.
| Modelo Transformer | Descripción | ¿Multilingüe? |
|---|---|---|
| GPT-2 | Aunque entrenado como un modelo de lenguaje autorregresivo, puedes hacer que GPT-2 genere resúmenes añadiendo "TL;DR" al final del texto de entrada. | ❌ |
| PEGASUS | Utiliza un objetivo de preentrenamiento para predecir oraciones enmascaradas en textos de varias oraciones. Este objetivo de preentrenamiento está más cerca del resumen que del modelado de lenguaje simple y obtiene puntuaciones altas en los puntos de referencia populares. | ❌ |
| T5 | Una arquitectura Transformer universal que formula todas las tareas en un marco de texto a texto; por ejemplo, el formato de entrada para que el modelo resuma un documento es summarize: ARTICLE. |
❌ |
| mT5 | Una versión multilingüe de T5, preentrenada en el corpus multilingüe Common Crawl (mC4), que cubre 101 idiomas. | ✅ |
| BART | Una nueva arquitectura Transformer con una pila de codificador y decodificador entrenada para reconstruir entradas corruptas que combina los esquemas de preentrenamiento de BERT y GPT-2. | ❌ |
| mBART-50 | Una versión multilingüe de BART, preentrenada en 50 idiomas. | ✅ |
Como puedes ver en esta tabla, la mayoría de los modelos Transformer para resumen (y de hecho la mayoría de las tareas de PNL) son monolingües. Esto es genial si tu tarea es en un idioma de "altos recursos" como el inglés o el alemán, pero menos para los miles de otros idiomas que se usan en todo el mundo. Afortunadamente, existe una clase de modelos Transformer multilingües, como mT5 y mBART, que vienen al rescate. Estos modelos se preentrenan utilizando el modelado de lenguaje, pero con un giro: en lugar de entrenar en un corpus de un solo idioma, se entrenan conjuntamente en textos en más de 50 idiomas a la vez.
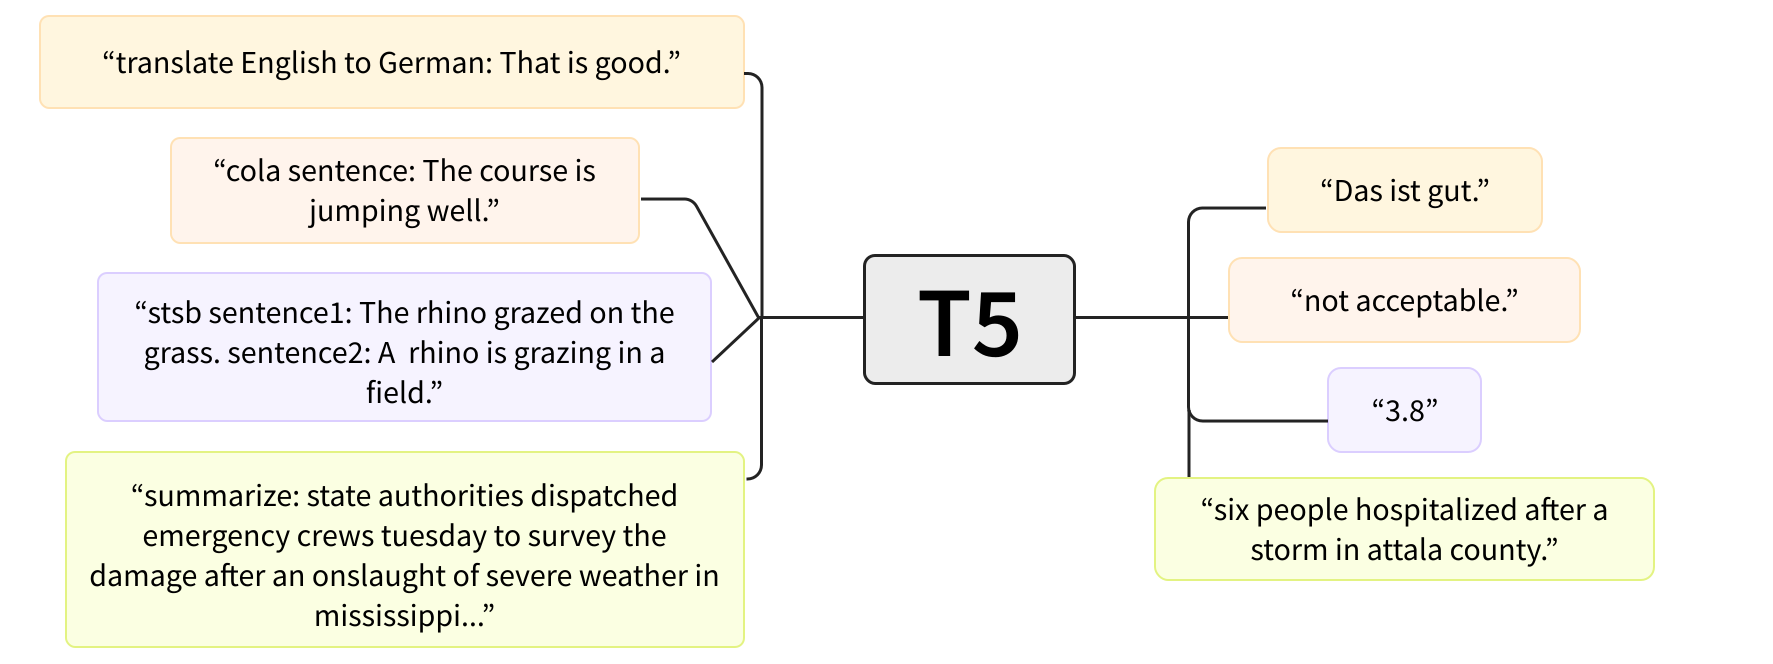
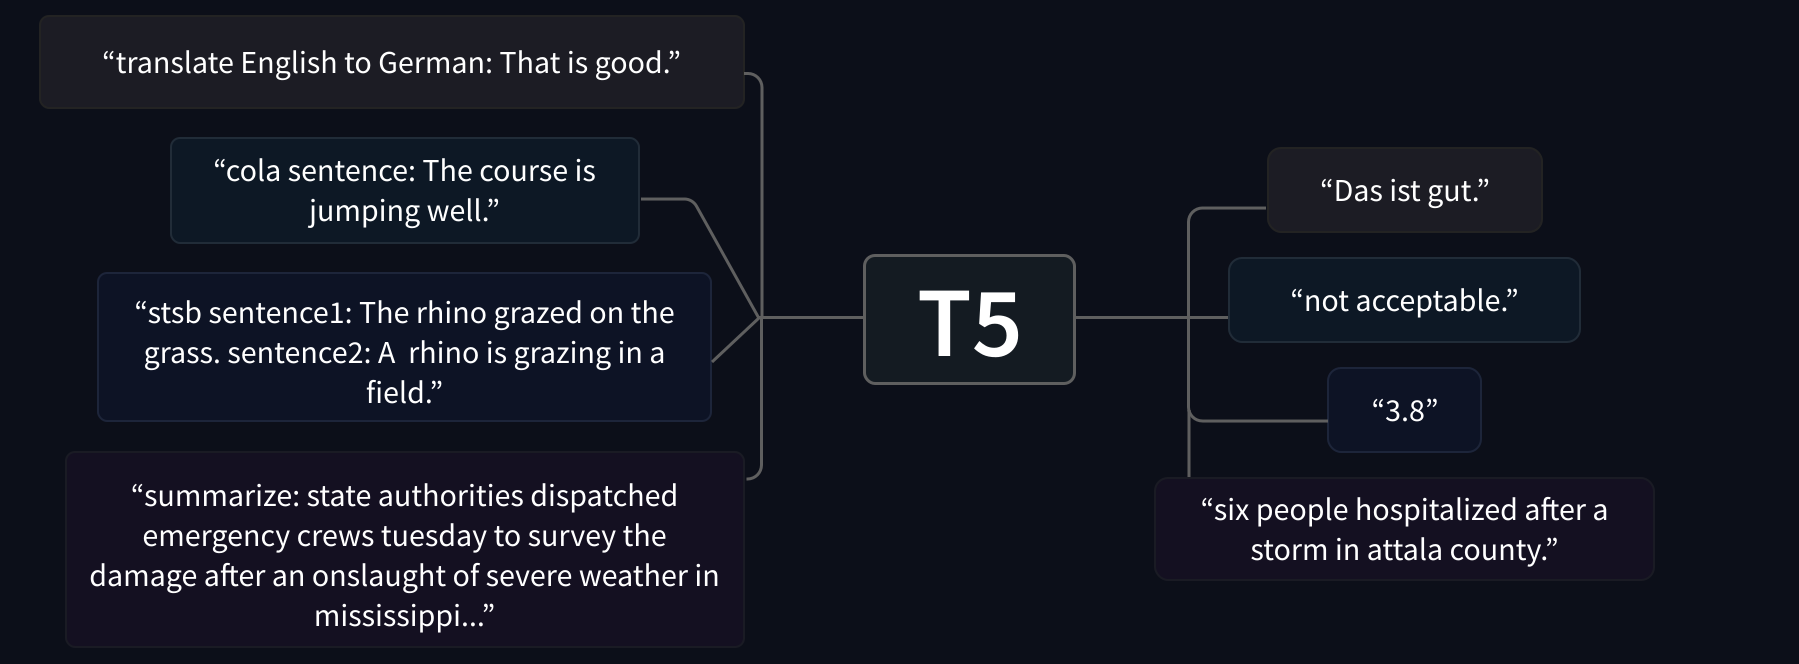
Nos centraremos en mT5, una arquitectura interesante basada en T5 que fue preentrenada en un marco de texto a texto. En T5, cada tarea de PNL se formula en términos de un prefijo de prompt como summarize: que condiciona al modelo para adaptar el texto generado al prompt. Como se muestra en la figura siguiente, esto hace que T5 sea extremadamente versátil, ¡ya que puedes resolver muchas tareas con un solo modelo!
mT5 no usa prefijos, pero comparte gran parte de la versatilidad de T5 y tiene la ventaja de ser multilingüe. Ahora que hemos elegido un modelo, echemos un vistazo a la preparación de nuestros datos para el entrenamiento.
[!TIP] ✏️ ¡Pruébalo! Una vez que hayas trabajado en esta sección, mira qué tan bien se compara mT5 con mBART ajustando este último con las mismas técnicas. Para puntos extra, también puedes intentar ajustar T5 solo con las reseñas en inglés. Dado que T5 tiene un prompt de prefijo especial, deberás anteponer
summarize:a los ejemplos de entrada en los pasos de preprocesamiento a continuación.
Preprocesamiento de los datos[[preprocessing-the-data]]
Nuestra siguiente tarea es tokenizar y codificar nuestras reseñas y sus títulos. Como de costumbre, comenzamos cargando el tokenizador asociado con el punto de control del modelo preentrenado. Usaremos mt5-small como nuestro punto de control para poder ajustar el modelo en un tiempo razonable:
from transformers import AutoTokenizer

model_checkpoint = "google/mt5-small"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
[!TIP] 💡 En las primeras etapas de tus proyectos de PNL, una buena práctica es entrenar una clase de modelos "pequeños" con una pequeña muestra de datos. Esto te permite depurar e iterar más rápido hacia un flujo de trabajo de extremo a extremo. Una vez que estés seguro de los resultados, ¡siempre puedes escalar el modelo simplemente cambiando el punto de control del modelo!
Probemos el tokenizador mT5 con un pequeño ejemplo:
inputs = tokenizer("I loved reading the Hunger Games!")
inputs
{'input_ids': [336, 259, 28387, 11807, 287, 62893, 295, 12507, 1], 'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1, 1]}
Aquí podemos ver los familiares input_ids y attention_mask que encontramos en nuestros primeros experimentos de ajuste fino en el Capítulo 3. Decodifiquemos estos ID de entrada con la función convert_ids_to_tokens() del tokenizador para ver con qué tipo de tokenizador estamos tratando:
tokenizer.convert_ids_to_tokens(inputs.input_ids)
['▁I', '▁', 'loved', '▁reading', '▁the', '▁Hung', 'er', '▁Games', '</s>']
El carácter Unicode especial ▁ y el token de fin de secuencia </s> indican que estamos tratando con el tokenizador SentencePiece, que se basa en el algoritmo de segmentación Unigram discutido en el Capítulo 6. Unigram es especialmente útil para corpora multilingües, ya que permite que SentencePiece sea agnóstico a los acentos, la puntuación y el hecho de que muchos idiomas, como el japonés, no tienen caracteres de espacio en blanco.
Para tokenizar nuestro corpus, tenemos que lidiar con una sutileza asociada con el resumen: debido a que nuestras etiquetas también son texto, es posible que excedan el tamaño máximo de contexto del modelo. Esto significa que necesitamos aplicar truncamiento tanto a las reseñas como a sus títulos para asegurarnos de no pasar entradas excesivamente largas a nuestro modelo. Los tokenizadores en 🤗 Transformers proporcionan un ingenioso argumento text_target que te permite tokenizar las etiquetas en paralelo a las entradas. Aquí hay un ejemplo de cómo se procesan las entradas y los objetivos para mT5:
max_input_length = 512
max_target_length = 30


def preprocess_function(examples):
    model_inputs = tokenizer(
        examples["review_body"],
        max_length=max_input_length,
        truncation=True,
    )
    labels = tokenizer(
        examples["review_title"], max_length=max_target_length, truncation=True
    )
    model_inputs["labels"] = labels["input_ids"]
    return model_inputs
Recorramos este código para entender lo que está sucediendo. Lo primero que hemos hecho es definir valores para max_input_length y max_target_length, que establecen los límites superiores para la longitud de nuestras reseñas y títulos. Dado que el cuerpo de la reseña es típicamente mucho más grande que el título, hemos escalado estos valores en consecuencia.
Con preprocess_function(), es entonces una cuestión sencilla tokenizar todo el corpus usando la práctica función Dataset.map() que hemos usado extensivamente a lo largo de este curso:
tokenized_datasets = books_dataset.map(preprocess_function, batched=True)
Ahora que el corpus ha sido preprocesado, echemos un vistazo a algunas métricas que se usan comúnmente para el resumen. Como veremos, no hay una solución mágica cuando se trata de medir la calidad del texto generado por máquina.
[!TIP] 💡 Es posible que hayas notado que usamos
batched=Trueen nuestra funciónDataset.map()anterior. Esto codifica los ejemplos en lotes de 1,000 (el valor predeterminado) y te permite usar las capacidades de multihilo de los tokenizadores rápidos en 🤗 Transformers. Siempre que sea posible, ¡intenta usarbatched=Truepara aprovechar al máximo tu preprocesamiento!
Métricas para el resumen de texto[[metrics-for-text-summarization]]
En comparación con la mayoría de las otras tareas que hemos cubierto en este curso, medir el rendimiento de las tareas de generación de texto como el resumen o la traducción no es tan sencillo. Por ejemplo, dada una reseña como "Me encantó leer Los Juegos del Hambre", hay varios resúmenes válidos, como "Me encantaron Los Juegos del Hambre" o "Los Juegos del Hambre es una gran lectura". Claramente, aplicar algún tipo de coincidencia exacta entre el resumen generado y la etiqueta no es una buena solución; incluso los humanos tendrían un rendimiento deficiente con una métrica así, porque todos tenemos nuestro propio estilo de escritura.
Para el resumen, una de las métricas más utilizadas es la puntuación ROUGE (abreviatura de Recall-Oriented Understudy for Gisting Evaluation). La idea básica detrás de esta métrica es comparar un resumen generado con un conjunto de resúmenes de referencia que suelen ser creados por humanos. Para ser más precisos, supongamos que queremos comparar los dos resúmenes siguientes:
generated_summary = "I absolutely loved reading the Hunger Games"
reference_summary = "I loved reading the Hunger Games"
Una forma de compararlos podría ser contar el número de palabras superpuestas, que en este caso sería 6. Sin embargo, esto es un poco burdo, así que en su lugar ROUGE se basa en calcular las puntuaciones de precisión y exhaustividad para la superposición.
[!TIP] 🙋 No te preocupes si es la primera vez que oyes hablar de precisión y exhaustividad; veremos algunos ejemplos explícitos juntos para que todo quede claro. Estas métricas suelen encontrarse en tareas de clasificación, así que si quieres entender cómo se definen la precisión y la exhaustividad en ese contexto, te recomendamos consultar las guías
scikit-learn.
Para ROUGE, la exhaustividad mide cuánto del resumen de referencia es capturado por el generado. Si solo comparamos palabras, la exhaustividad se puede calcular según la siguiente fórmula:
$$ \mathrm{Exhaustividad} = \frac{\mathrm{Número,de,palabras,superpuestas}}{\mathrm{Número,total,de,palabras,en,el,resumen,de,referencia}} $$
Para nuestro ejemplo simple anterior, esta fórmula da una exhaustividad perfecta de 6/6 = 1; es decir, todas las palabras del resumen de referencia han sido producidas por el modelo. Esto puede sonar genial, pero imagina si nuestro resumen generado hubiera sido "Realmente, realmente me encantó leer Los Juegos del Hambre toda la noche". Esto también tendría una exhaustividad perfecta, pero es discutiblemente un resumen peor ya que es verboso. Para lidiar con estos escenarios, también calculamos la precisión, que en el contexto de ROUGE mide cuánto del resumen generado fue relevante:
$$ \mathrm{Precisión} = \frac{\mathrm{Número,de,palabras,superpuestas}}{\mathrm{Número,total,de,palabras,en,el,resumen,generado}} $$
Aplicando esto a nuestro resumen verboso, obtenemos una precisión de 6/10 = 0.6, lo cual es considerablemente peor que la precisión de 6/7 = 0.86 obtenida por nuestro resumen más corto. En la práctica, generalmente se calculan tanto la precisión como la exhaustividad, y luego se informa la puntuación F1 (la media armónica de precisión y exhaustividad). Podemos hacer esto fácilmente en 🤗 Datasets instalando primero el paquete rouge_score:
!pip install rouge_score
y luego cargando la métrica ROUGE de la siguiente manera:
rouge_score = evaluate.load("rouge")
Luego podemos usar la función rouge_score.compute() para calcular todas las métricas a la vez:
scores = rouge_score.compute(
    predictions=[generated_summary], references=[reference_summary]
)
scores
{'rouge1': AggregateScore(low=Score(precision=0.86, recall=1.0, fmeasure=0.92), mid=Score(precision=0.86, recall=1.0, fmeasure=0.92), high=Score(precision=0.86, recall=1.0, fmeasure=0.92)),
 'rouge2': AggregateScore(low=Score(precision=0.67, recall=0.8, fmeasure=0.73), mid=Score(precision=0.67, recall=0.8, fmeasure=0.73), high=Score(precision=0.67, recall=0.8, fmeasure=0.73)),
 'rougeL': AggregateScore(low=Score(precision=0.86, recall=1.0, fmeasure=0.92), mid=Score(precision=0.86, recall=1.0, fmeasure=0.92), high=Score(precision=0.86, recall=1.0, fmeasure=0.92)),
 'rougeLsum': AggregateScore(low=Score(precision=0.86, recall=1.0, fmeasure=0.92), mid=Score(precision=0.86, recall=1.0, fmeasure=0.92), high=Score(precision=0.86, recall=1.0, fmeasure=0.92))}
Vaya, hay mucha información en esa salida, ¿qué significa todo? Primero, 🤗 Datasets calcula intervalos de confianza para la precisión, la exhaustividad y la puntuación F1; estos son los atributos low, mid y high que puedes ver aquí. Además, 🤗 Datasets calcula una variedad de puntuaciones ROUGE que se basan en diferentes tipos de granularidad de texto al comparar los resúmenes generados y de referencia. La variante rouge1 es la superposición de unigramas; esta es solo una forma elegante de decir la superposición de palabras y es exactamente la métrica que hemos discutido anteriormente. Para verificar esto, extraigamos el valor mid de nuestras puntuaciones:
scores["rouge1"].mid
Score(precision=0.86, recall=1.0, fmeasure=0.92)
¡Genial, los números de precisión y exhaustividad coinciden! Ahora, ¿qué pasa con esas otras puntuaciones ROUGE? rouge2 mide la superposición entre bigramas (piensa en la superposición de pares de palabras), mientras que rougeL y rougeLsum miden las secuencias de palabras coincidentes más largas buscando las subcadenas comunes más largas en los resúmenes generados y de referencia. El "sum" en rougeLsum se refiere al hecho de que esta métrica se calcula sobre un resumen completo, mientras que rougeL se calcula como el promedio sobre oraciones individuales.
[!TIP] ✏️ ¡Pruébalo! Crea tu propio ejemplo de un resumen generado y de referencia y comprueba si las puntuaciones ROUGE resultantes coinciden con un cálculo manual basado en las fórmulas de precisión y exhaustividad. Para puntos extra, divide el texto en bigramas y compara la precisión y exhaustividad para la métrica
rouge2.
Usaremos estas puntuaciones ROUGE para seguir el rendimiento de nuestro modelo, pero antes de hacerlo, ¡hagamos algo que todo buen profesional de PNL debería hacer: crear una línea base sólida pero simple!
Creando una línea base sólida[[creating-a-strong-baseline]]
Una línea base común para el resumen de texto es simplemente tomar las primeras tres oraciones de un artículo, a menudo llamada la línea base lead-3. Podríamos usar puntos para rastrear los límites de las oraciones, pero esto fallará en acrónimos como "EE. UU." o "ONU", así que en su lugar usaremos la biblioteca nltk, que incluye un algoritmo mejor para manejar estos casos. Puedes instalar el paquete usando pip de la siguiente manera:
!pip install nltk
y luego descarga las reglas de puntuación:
nltk.download("punkt")
A continuación, importamos el tokenizador de oraciones de nltk y creamos una función simple para extraer las tres primeras oraciones de una reseña. La convención en el resumen de texto es separar cada resumen con un salto de línea, así que incluyamos esto también y probémoslo en un ejemplo de entrenamiento:
from nltk.tokenize import sent_tokenize


def three_sentence_summary(text):
    return "\n".join(sent_tokenize(text)[:3])


print(three_sentence_summary(books_dataset["train"][1]["review_body"]))
'I grew up reading Koontz, and years ago, I stopped,convinced i had "outgrown" him.'
'Still,when a friend was looking for something suspenseful too read, I suggested Koontz.'
'She found Strangers.'
Esto parece funcionar, así que ahora implementemos una función que extraiga estos "resúmenes" de un conjunto de datos y calcule las puntuaciones ROUGE para la línea base:
def evaluate_baseline(dataset, metric):
    summaries = [three_sentence_summary(text) for text in dataset["review_body"]]
    return metric.compute(predictions=summaries, references=dataset["review_title"])
Luego podemos usar esta función para calcular las puntuaciones ROUGE sobre el conjunto de validación y embellecerlas un poco usando Pandas:
score = evaluate_baseline(books_dataset["validation"], rouge_score)
rouge_names = ["rouge1", "rouge2", "rougeL", "rougeLsum"]
rouge_dict = dict((rn, round(score[rn].mid.fmeasure * 100, 2)) for rn in rouge_names)
rouge_dict
{'rouge1': 16.74, 'rouge2': 8.83, 'rougeL': 15.6, 'rougeLsum': 15.96}
Podemos ver que la puntuación rouge2 es significativamente más baja que el resto; esto probablemente refleja el hecho de que los títulos de las reseñas suelen ser concisos y, por lo tanto, la línea base lead-3 es demasiado verbosa. Ahora que tenemos una buena línea base para trabajar, ¡dirijamos nuestra atención a ajustar mT5!
{#if fw === 'pt'}
Ajuste fino de mT5 con la API Trainer[[fine-tuning-mt5-with-the-trainer-api]]
El ajuste fino de un modelo para resumen es muy similar a las otras tareas que hemos cubierto en este capítulo. Lo primero que debemos hacer es cargar el modelo preentrenado desde el punto de control mt5-small. Dado que el resumen es una tarea de secuencia a secuencia, podemos cargar el modelo con la clase AutoModelForSeq2SeqLM, que descargará y almacenará en caché automáticamente los pesos:
from transformers import AutoModelForSeq2SeqLM

model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
{:else}
Ajuste fino de mT5 con Keras[[fine-tuning-mt5-with-keras]]
El ajuste fino de un modelo para la creación de resúmenes es muy similar a las otras tareas que hemos cubierto en este capítulo. Lo primero que debemos hacer es cargar el modelo preentrenado desde el punto de control mt5-small. Dado que la creación de resúmenes es una tarea de secuencia a secuencia, podemos cargar el modelo con la clase TFAutoModelForSeq2SeqLM, que descargará y almacenará en caché los pesos automáticamente:
from transformers import TFAutoModelForSeq2SeqLM

model = TFAutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
{/if}
[!TIP] 💡 Si te preguntas por qué no ves ninguna advertencia sobre el ajuste fino del modelo en una tarea posterior, es porque para las tareas de secuencia a secuencia mantenemos todos los pesos de la red. Compara esto con nuestro modelo de clasificación de texto en el Capítulo 3, donde la cabeza del modelo preentrenado fue reemplazada por una red inicializada aleatoriamente.
Lo siguiente que debemos hacer es iniciar sesión en Hugging Face Hub. Si estás ejecutando este código en un notebook, puedes hacerlo con la siguiente función de utilidad:
from huggingface_hub import notebook_login

notebook_login()
que mostrará un widget donde puedes ingresar tus credenciales. Alternativamente, puedes ejecutar este comando en tu terminal e iniciar sesión allí:
huggingface-cli login
{#if fw === 'pt'}
Necesitaremos generar resúmenes para calcular las puntuaciones ROUGE durante el entrenamiento. Afortunadamente, 🤗 Transformers proporciona clases dedicadas Seq2SeqTrainingArguments y Seq2SeqTrainer que pueden hacer esto por nosotros automáticamente. Para ver cómo funciona esto, primero definamos los hiperparámetros y otros argumentos para nuestros experimentos:
from transformers import Seq2SeqTrainingArguments

batch_size = 8
num_train_epochs = 8
# Show the training loss with every epoch
logging_steps = len(tokenized_datasets["train"]) // batch_size
model_name = model_checkpoint.split("/")[-1]

args = Seq2SeqTrainingArguments(
    output_dir=f"{model_name}-finetuned-amazon-en-es",
    evaluation_strategy="epoch",
    learning_rate=5.6e-5,
    per_device_train_batch_size=batch_size,
    per_device_eval_batch_size=batch_size,
    weight_decay=0.01,
    save_total_limit=3,
    num_train_epochs=num_train_epochs,
    predict_with_generate=True,
    logging_steps=logging_steps,
    push_to_hub=True,
)
Aquí, el argumento predict_with_generate se ha configurado para indicar que debemos generar resúmenes durante la evaluación para poder calcular las puntuaciones ROUGE para cada época. Como se discutió en el Capítulo 1, el decodificador realiza la inferencia prediciendo tokens uno por uno, y esto se implementa mediante el método generate() del modelo. Establecer predict_with_generate=True le dice al Seq2SeqTrainer que use ese método para la evaluación. También hemos ajustado algunos de los hiperparámetros predeterminados, como la tasa de aprendizaje, el número de épocas y la disminución de peso, y hemos establecido la opción save_total_limit para guardar solo hasta 3 puntos de control durante el entrenamiento; esto se debe a que incluso la versión "pequeña" de mT5 usa alrededor de un GB de espacio en el disco duro, y podemos ahorrar un poco de espacio limitando el número de copias que guardamos.
El argumento push_to_hub=True nos permitirá enviar el modelo al Hub después del entrenamiento; encontrarás el repositorio bajo tu perfil de usuario en la ubicación definida por output_dir. Ten en cuenta que puedes especificar el nombre del repositorio al que quieres enviar con el argumento hub_model_id (en particular, tendrás que usar este argumento para enviar a una organización). Por ejemplo, cuando enviamos el modelo a la organización huggingface-course, agregamos hub_model_id="huggingface-course/mt5-finetuned-amazon-en-es" a Seq2SeqTrainingArguments.
Lo siguiente que debemos hacer es proporcionar al entrenador una función compute_metrics() para que podamos evaluar nuestro modelo durante el entrenamiento. Para la creación de resúmenes, esto es un poco más complicado que simplemente llamar a rouge_score.compute() en las predicciones del modelo, ya que necesitamos decodificar las salidas y las etiquetas en texto antes de poder calcular las puntuaciones ROUGE. La siguiente función hace exactamente eso, y también utiliza la función sent_tokenize() de nltk para separar las oraciones del resumen con saltos de línea:
def compute_metrics(eval_pred):
    predictions, labels = eval_pred
    # Decode generated summaries into text
    decoded_preds = tokenizer.batch_decode(predictions, skip_special_tokens=True)
    # Replace -100 in the labels as we can't decode them
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    # Decode reference summaries into text
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)
    # ROUGE expects a newline after each sentence
    decoded_preds = ["\n".join(sent_tokenize(pred.strip())) for pred in decoded_preds]
    decoded_labels = ["\n".join(sent_tokenize(label.strip())) for label in decoded_labels]
    # Compute ROUGE scores
    result = rouge_score.compute(
        predictions=decoded_preds, references=decoded_labels, use_stemmer=True
    )
    # Extract the median scores
    result = {key: value.mid.fmeasure * 100 for key, value in result.items()}
    return {k: round(v, 4) for k, v in result.items()}
{/if}
A continuación, necesitamos definir un agrupador de datos para nuestra tarea de secuencia a secuencia. Dado que mT5 es un modelo Transformer codificador-decodificador, una sutileza al preparar nuestros lotes es que durante la decodificación necesitamos desplazar las etiquetas a la derecha en uno. Esto es necesario para asegurar que el decodificador solo vea las etiquetas de verdad fundamental anteriores y no las actuales o futuras, lo que sería fácil para el modelo memorizar. Esto es similar a cómo se aplica la autoatención enmascarada a las entradas en una tarea como el modelado de lenguaje causal.
Afortunadamente, 🤗 Transformers proporciona un agrupador DataCollatorForSeq2Seq que rellenará dinámicamente las entradas y las etiquetas por nosotros. Para instanciar este agrupador, simplemente necesitamos proporcionar el tokenizer y el model:
{#if fw === 'pt'}
from transformers import DataCollatorForSeq2Seq

data_collator = DataCollatorForSeq2Seq(tokenizer, model=model)
{:else}
from transformers import DataCollatorForSeq2Seq

data_collator = DataCollatorForSeq2Seq(tokenizer, model=model, return_tensors="tf")
{/if}
Veamos qué produce este agrupador cuando se le alimenta un pequeño lote de ejemplos. Primero, necesitamos eliminar las columnas con cadenas porque el agrupador no sabrá cómo rellenar estos elementos:
tokenized_datasets = tokenized_datasets.remove_columns(
    books_dataset["train"].column_names
)
Dado que el agrupador espera una lista de dicts, donde cada dict representa un solo ejemplo en el conjunto de datos, también necesitamos organizar los datos en el formato esperado antes de pasarlos al agrupador de datos:
features = [tokenized_datasets["train"][i] for i in range(2)]
data_collator(features)
{'attention_mask': tensor([[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
         1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0],
        [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
         1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]]), 'input_ids': tensor([[  1494,    259,   8622,    390,    259,    262,   2316,   3435,    955,
            772,    281,    772,   1617,    263,    305,  14701,    260,   1385,
           3031,    259,  24146,    332,   1037,    259,  43906,    305,    336,
            260,      1,      0,      0,      0,      0,      0,      0],
        [   259,  27531,  13483,    259,   7505,    260, 112240,  15192,    305,
          53198,    276,    259,  74060,    263,    260,    459,  25640,    776,
           2119,    336,    259,   2220,    259,  18896,    288,   4906,    288,
           1037,   3931,    260,   7083, 101476,   1143,    260,      1]]), 'labels': tensor([[ 7483,   259,  2364, 15695,     1,  -100],
        [  259, 27531, 13483,   259,  7505,     1]]), 'decoder_input_ids': tensor([[    0,  7483,   259,  2364, 15695,     1],
        [    0,   259, 27531, 13483,   259,  7505]])}
Lo principal a notar aquí es que el primer ejemplo es más largo que el segundo, por lo que el input_ids y el attention_mask del segundo ejemplo se han rellenado a la derecha con un token [PAD] (cuyo ID es 0). De manera similar, podemos ver que los labels se han rellenado con -100s, para asegurar que los tokens de relleno sean ignorados por la función de pérdida. Y finalmente, podemos ver un nuevo decoder_input_ids que ha desplazado las etiquetas a la derecha insertando un token [PAD] en la primera entrada.
{#if fw === 'pt'}
¡Finalmente tenemos todos los ingredientes que necesitamos para entrenar! Ahora simplemente necesitamos instanciar el entrenador con los argumentos estándar:
from transformers import Seq2SeqTrainer

trainer = Seq2SeqTrainer(
    model,
    args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    data_collator=data_collator,
    tokenizer=tokenizer,
    compute_metrics=compute_metrics,
)
y lanzar nuestra ejecución de entrenamiento:
trainer.train()
Durante el entrenamiento, deberías ver cómo la pérdida de entrenamiento disminuye y las puntuaciones ROUGE aumentan con cada época. Una vez que el entrenamiento esté completo, puedes ver las puntuaciones ROUGE finales ejecutando Trainer.evaluate():
trainer.evaluate()
{'eval_loss': 3.028524398803711,
 'eval_rouge1': 16.9728,
 'eval_rouge2': 8.2969,
 'eval_rougeL': 16.8366,
 'eval_rougeLsum': 16.851,
 'eval_gen_len': 10.1597,
 'eval_runtime': 6.1054,
 'eval_samples_per_second': 38.982,
 'eval_steps_per_second': 4.914}
De las puntuaciones podemos ver que nuestro modelo ha superado fácilmente nuestra línea base lead-3, ¡excelente! Lo último que queda por hacer es enviar los pesos del modelo al Hub, de la siguiente manera:
trainer.push_to_hub(commit_message="Training complete", tags="summarization")
'https://huggingface.co/huggingface-course/mt5-finetuned-amazon-en-es/commit/aa0536b829b28e73e1e4b94b8a5aacec420d40e0'
Esto guardará el punto de control y los archivos de configuración en output_dir, antes de subir todos los archivos al Hub. Al especificar el argumento tags, también nos aseguramos de que el widget en el Hub sea para una pipeline de resumen en lugar del predeterminado de generación de texto asociado con la arquitectura mT5 (para más información sobre las etiquetas de modelo, consulta la documentación de 🤗 Hub). La salida de trainer.push_to_hub() es una URL al hash de confirmación de Git, ¡así que puedes ver fácilmente los cambios que se hicieron en el repositorio del modelo!
Para finalizar esta sección, veamos cómo también podemos ajustar finamente mT5 usando las características de bajo nivel proporcionadas por 🤗 Accelerate.
{:else}
¡Casi estamos listos para entrenar! Solo necesitamos convertir nuestros conjuntos de datos a tf.data.Datasets usando el agrupador de datos que definimos anteriormente, y luego compile() y fit() el modelo. Primero, los conjuntos de datos:
tf_train_dataset = model.prepare_tf_dataset(
    tokenized_datasets["train"],
    collate_fn=data_collator,
    shuffle=True,
    batch_size=8,
)
tf_eval_dataset = model.prepare_tf_dataset(
    tokenized_datasets["validation"],
    collate_fn=data_collator,
    shuffle=False,
    batch_size=8,
)
Ahora, definimos nuestros hiperparámetros de entrenamiento y compilamos:
from transformers import create_optimizer


# The number of training steps is the number of samples in the dataset, divided by the batch size then multiplied
# by the total number of epochs. Note that the tf_train_dataset here is a batched tf.data.Dataset,
# not the original Hugging Face Dataset, so its len() is already num_samples // batch_size.
num_train_epochs = 8
num_train_steps = len(tf_train_dataset) * num_train_epochs
model_name = model_checkpoint.split("/")[-1]

optimizer, schedule = create_optimizer(
    init_lr=5.6e-5,
    num_warmup_steps=0,
    num_train_steps=num_train_steps,
    weight_decay_rate=0.01,
)

model.compile(optimizer=optimizer)

# Train in mixed-precision float16
tf.keras.mixed_precision.set_global_policy("mixed_float16")
Y finalmente, ajustamos el modelo. Usamos un PushToHubCallback para guardar el modelo en el Hub después de cada época, lo que nos permitirá usarlo para inferencia más tarde:
from transformers.keras_callbacks import PushToHubCallback

callback = PushToHubCallback(
    output_dir=f"{model_name}-finetuned-amazon-en-es", tokenizer=tokenizer
)

model.fit(
    tf_train_dataset, validation_data=tf_eval_dataset, callbacks=[callback], epochs=8
)
Obtuvimos algunos valores de pérdida durante el entrenamiento, pero en realidad nos gustaría ver las métricas ROUGE que calculamos anteriormente. Para obtener esas métricas, necesitaremos generar salidas del modelo y convertirlas a cadenas. Construyamos algunas listas de etiquetas y predicciones para que la métrica ROUGE las compare (ten en cuenta que si obtienes errores de importación para esta sección, es posible que necesites !pip install tqdm). También vamos a usar un truco que aumenta drásticamente el rendimiento: compilar nuestro código de generación con XLA, el compilador de álgebra lineal acelerada de TensorFlow. XLA aplica varias optimizaciones al grafo de cómputo del modelo y resulta en mejoras significativas en la velocidad y el uso de la memoria. Como se describe en el blog de Hugging Face, XLA funciona mejor cuando nuestras formas de entrada no varían demasiado. Para manejar esto, rellenaremos nuestras entradas a múltiplos de 128, y haremos un nuevo conjunto de datos con el agrupador de relleno, y luego aplicaremos el decorador @tf.function(jit_compile=True) a nuestra función de generación, que marca toda la función para su compilación con XLA.
from tqdm import tqdm


generation_data_collator = DataCollatorForSeq2Seq(
    tokenizer, model=model, return_tensors="tf", pad_to_multiple_of=320
)

tf_generate_dataset = model.prepare_tf_dataset(
    tokenized_datasets["validation"],
    collate_fn=generation_data_collator,
    shuffle=False,
    batch_size=8,
    drop_remainder=True,
)


@tf.function(jit_compile=True)
def generate_with_xla(batch):
    return model.generate(
        input_ids=batch["input_ids"],
        attention_mask=batch["attention_mask"],
        max_new_tokens=32,
    )


all_preds = []
all_labels = []
for batch, labels in tqdm(tf_generate_dataset):
    predictions = generate_with_xla(batch)
    decoded_preds = tokenizer.batch_decode(predictions, skip_special_tokens=True)
    labels = labels.numpy()
    labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
    decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)
    decoded_preds = ["\n".join(sent_tokenize(pred.strip())) for pred in decoded_preds]
    decoded_labels = ["\n".join(sent_tokenize(label.strip())) for label in decoded_labels]
    all_preds.extend(decoded_preds)
    all_labels.extend(decoded_labels)
Una vez que tenemos nuestras listas de cadenas de etiquetas y predicciones, calcular la puntuación ROUGE es fácil:
result = rouge_score.compute(
    predictions=decoded_preds, references=decoded_labels, use_stemmer=True
)
result = {key: value.mid.fmeasure * 100 for key, value in result.items()}
{k: round(v, 4) for k, v in result.items()}
{'rouge1': 31.4815, 'rouge2': 25.4386, 'rougeL': 31.4815, 'rougeLsum': 31.4815}
{/if}
{#if fw === 'pt'}
Ajuste fino de mT5 con 🤗 Accelerate[[fine-tuning-mt5-with-accelerate]]
El ajuste fino de nuestro modelo con 🤗 Accelerate es muy similar al ejemplo de clasificación de texto que encontramos en el Capítulo 3. Las principales diferencias serán la necesidad de generar explícitamente nuestros resúmenes durante el entrenamiento y definir cómo calculamos las puntuaciones ROUGE (recuerda que el Seq2SeqTrainer se encargó de la generación por nosotros). ¡Veamos cómo podemos implementar estos dos requisitos dentro de 🤗 Accelerate!
Preparando todo para el entrenamiento[[preparing-everything-for-training]]
Lo primero que debemos hacer es crear un DataLoader para cada una de nuestras divisiones. Dado que los cargadores de datos de PyTorch esperan lotes de tensores, necesitamos establecer el formato en "torch" en nuestros conjuntos de datos:
tokenized_datasets.set_format("torch")
Ahora que tenemos conjuntos de datos que consisten solo en tensores, lo siguiente que debemos hacer es instanciar el DataCollatorForSeq2Seq nuevamente. Para esto, necesitamos proporcionar una versión nueva del modelo, así que volvamos a cargarlo desde nuestra caché:
model = AutoModelForSeq2SeqLM.from_pretrained(model_checkpoint)
Luego podemos instanciar el agrupador de datos y usarlo para definir nuestros cargadores de datos:
from torch.utils.data import DataLoader

batch_size = 8
train_dataloader = DataLoader(
    tokenized_datasets["train"],
    shuffle=True,
    collate_fn=data_collator,
    batch_size=batch_size,
)
eval_dataloader = DataLoader(
    tokenized_datasets["validation"], collate_fn=data_collator, batch_size=batch_size
)
Lo siguiente que debemos hacer es definir el optimizador que queremos usar. Como en nuestros otros ejemplos, usaremos AdamW, que funciona bien para la mayoría de los problemas:
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=2e-5)
Finalmente, alimentamos nuestro modelo, optimizador y cargadores de datos al método accelerator.prepare():
from accelerate import Accelerator

accelerator = Accelerator()
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
[!TIP] 🚨 Si estás entrenando en una TPU, deberás mover todo el código anterior a una función de entrenamiento dedicada. Consulta el Capítulo 3 para obtener más detalles.
Ahora que hemos preparado nuestros objetos, quedan tres cosas por hacer:
- Definir el programa de tasa de aprendizaje.
- Implementar una función para posprocesar los resúmenes para la evaluación.
- Crear un repositorio en el Hub al que podamos enviar nuestro modelo.
Para el programa de tasa de aprendizaje, usaremos el estándar lineal de secciones anteriores:
from transformers import get_scheduler

num_train_epochs = 10
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
Para el posprocesamiento, necesitamos una función que divida los resúmenes generados en oraciones separadas por saltos de línea. Este es el formato que espera la métrica ROUGE, y podemos lograrlo con el siguiente fragmento de código:
def postprocess_text(preds, labels):
    preds = [pred.strip() for pred in preds]
    labels = [label.strip() for label in labels]

    # ROUGE expects a newline after each sentence
    preds = ["\n".join(nltk.sent_tokenize(pred)) for pred in preds]
    labels = ["\n".join(nltk.sent_tokenize(label)) for label in labels]

    return preds, labels
Esto debería resultarte familiar si recuerdas cómo definimos la función compute_metrics() del Seq2SeqTrainer.
Finalmente, necesitamos crear un repositorio de modelos en Hugging Face Hub. Para esto, podemos usar la biblioteca 🤗 Hub, apropiadamente titulada. Solo necesitamos definir un nombre para nuestro repositorio, y la biblioteca tiene una función de utilidad para combinar el ID del repositorio con el perfil de usuario:
from huggingface_hub import get_full_repo_name

model_name = "test-bert-finetuned-squad-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'lewtun/mt5-finetuned-amazon-en-es-accelerate'
Ahora podemos usar este nombre de repositorio para clonar una versión local en nuestro directorio de resultados que almacenará los artefactos de entrenamiento:
from huggingface_hub import Repository

output_dir = "results-mt5-finetuned-squad-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
¡Esto nos permitirá enviar los artefactos de vuelta al Hub llamando al método repo.push_to_hub() durante el entrenamiento! Ahora concluyamos nuestro análisis escribiendo el bucle de entrenamiento.
Bucle de entrenamiento[[training-loop]]
El bucle de entrenamiento para la creación de resúmenes es bastante similar a los otros ejemplos de 🤗 Accelerate que hemos encontrado y se divide aproximadamente en cuatro pasos principales:
- Entrenar el modelo iterando sobre todos los ejemplos en
train_dataloaderpara cada época. - Generar resúmenes del modelo al final de cada época, primero generando los tokens y luego decodificándolos (y los resúmenes de referencia) en texto.
- Calcular las puntuaciones ROUGE utilizando las mismas técnicas que vimos anteriormente.
- Guardar los puntos de control y enviar todo al Hub. Aquí confiamos en el ingenioso argumento
blocking=Falsedel objetoRepositorypara poder enviar los puntos de control por época asincrónicamente. ¡Esto nos permite continuar el entrenamiento sin tener que esperar la carga algo lenta asociada con un modelo de tamaño GB!
Estos pasos se pueden ver en el siguiente bloque de código:
from tqdm.auto import tqdm


progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # Training
    model.train()
    for step, batch in enumerate(train_dataloader):
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # Evaluation
    model.eval()
    for step, batch in enumerate(eval_dataloader):
        with torch.no_grad():
            generated_tokens = accelerator.unwrap_model(model).generate(
                batch["input_ids"],
                attention_mask=batch["attention_mask"],
            )

            generated_tokens = accelerator.pad_across_processes(
                generated_tokens, dim=1, pad_index=tokenizer.pad_token_id
            )
            labels = batch["labels"]

            # If we did not pad to max length, we need to pad the labels too
            labels = accelerator.pad_across_processes(
                batch["labels"], dim=1, pad_index=tokenizer.pad_token_id
            )

            generated_tokens = accelerator.gather(generated_tokens).cpu().numpy()
            labels = accelerator.gather(labels).cpu().numpy()

            # Replace -100 in the labels as we can't decode them
            labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
            if isinstance(generated_tokens, tuple):
                generated_tokens = generated_tokens[0]
            decoded_preds = tokenizer.batch_decode(
                generated_tokens, skip_special_tokens=True
            )
            decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

            decoded_preds, decoded_labels = postprocess_text(
                decoded_preds, decoded_labels
            )

            rouge_score.add_batch(predictions=decoded_preds, references=decoded_labels)

    # Compute metrics
    result = rouge_score.compute()
    # Extract the median ROUGE scores
    result = {key: value.mid.fmeasure * 100 for key, value in result.items()}
    result = {k: round(v, 4) for k, v in result.items()}
    print(f"Epoch {epoch}:", result)

    # Save and upload
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
Epoch 0: {'rouge1': 5.6351, 'rouge2': 1.1625, 'rougeL': 5.4866, 'rougeLsum': 5.5005}
Epoch 1: {'rouge1': 9.8646, 'rouge2': 3.4106, 'rougeL': 9.9439, 'rougeLsum': 9.9306}
Epoch 2: {'rouge1': 11.0872, 'rouge2': 3.3273, 'rougeL': 11.0508, 'rougeLsum': 10.9468}
Epoch 3: {'rouge1': 11.8587, 'rouge2': 4.8167, 'rougeL': 11.7986, 'rougeLsum': 11.7518}
Epoch 4: {'rouge1': 12.9842, 'rouge2': 5.5887, 'rougeL': 12.7546, 'rougeLsum': 12.7029}
Epoch 5: {'rouge1': 13.4628, 'rouge2': 6.4598, 'rougeL': 13.312, 'rougeLsum': 13.2913}
Epoch 6: {'rouge1': 12.9131, 'rouge2': 5.8914, 'rougeL': 12.6896, 'rougeLsum': 12.5701}
Epoch 7: {'rouge1': 13.3079, 'rouge2': 6.2994, 'rougeL': 13.1536, 'rougeLsum': 13.1194}
Epoch 8: {'rouge1': 13.96, 'rouge2': 6.5998, 'rougeL': 13.9123, 'rougeLsum': 13.7744}
Epoch 9: {'rouge1': 14.1192, 'rouge2': 7.0059, 'rougeL': 14.1172, 'rougeLsum': 13.9509}
¡Y eso es todo! Una vez que ejecutes esto, tendrás un modelo y resultados bastante similares a los que obtuvimos con el Trainer.
{/if}
Usando tu modelo ajustado[[using-your-fine-tuned-model]]
Una vez que hayas enviado el modelo al Hub, puedes jugar con él a través del widget de inferencia o con un objeto pipeline, de la siguiente manera:
from transformers import pipeline

hub_model_id = "huggingface-course/mt5-small-finetuned-amazon-en-es"
summarizer = pipeline("summarization", model=hub_model_id)
Podemos alimentar algunos ejemplos del conjunto de prueba (que el modelo no ha visto) a nuestra pipeline para tener una idea de la calidad de los resúmenes. Primero, implementemos una función simple para mostrar la reseña, el título y el resumen generado juntos:
def print_summary(idx):
    review = books_dataset["test"][idx]["review_body"]
    title = books_dataset["test"][idx]["review_title"]
    summary = summarizer(books_dataset["test"][idx]["review_body"])[0]["summary_text"]
    print(f"'>>> Review: {review}'")
    print(f"\n'>>> Title: {title}'")
    print(f"\n'>>> Summary: {summary}'")
Veamos uno de los ejemplos en inglés que obtenemos:
print_summary(100)
'>>> Review: Nothing special at all about this product... the book is too small and stiff and hard to write in. The huge sticker on the back doesn’t come off and looks super tacky. I would not purchase this again. I could have just bought a journal from the dollar store and it would be basically the same thing. It’s also really expensive for what it is.'

'>>> Title: Not impressed at all... buy something else'

'>>> Summary: Nothing special at all about this product'
¡Esto no está nada mal! Podemos ver que nuestro modelo ha sido capaz de realizar una creación de resúmenes abstractiva al aumentar partes de la reseña con nuevas palabras. Y quizás el aspecto más genial de nuestro modelo es que es bilingüe, por lo que también podemos generar resúmenes de reseñas en español:
print_summary(0)
'>>> Review: Es una trilogia que se hace muy facil de leer. Me ha gustado, no me esperaba el final para nada'

'>>> Title: Buena literatura para adolescentes'

'>>> Summary: Muy facil de leer'
El resumen se traduce como "Muy fácil de leer" en inglés, lo que podemos ver en este caso fue extraído directamente de la reseña. Sin embargo, esto muestra la versatilidad del modelo mT5 y te ha dado una idea de lo que es trabajar con un corpus multilingüe.
A continuación, centraremos nuestra atención en una tarea ligeramente más compleja: entrenar un modelo de lenguaje desde cero.