Respuesta a preguntas
{#if fw === 'pt'}
{:else}
{/if}
¡Es hora de ver la respuesta a preguntas! Esta tarea tiene muchas variantes, pero en esta sección nos enfocaremos en la respuesta a preguntas extractiva. Esto implica hacer preguntas sobre un documento e identificar las respuestas como fragmentos de texto en el propio documento.
Ajustaremos un modelo BERT en el conjunto de datos SQuAD, que consiste en preguntas hechas por colaboradores externos sobre un conjunto de artículos de Wikipedia. Esto nos dará un modelo capaz de calcular predicciones como esta:
Esto muestra el modelo que fue entrenado y subido al Hub usando el código que se muestra en esta sección. Puedes encontrarlo y verificar las predicciones aquí.
[!TIP] 💡 Los modelos solo con codificador como BERT suelen ser excelentes para extraer respuestas a preguntas de hechos como "¿Quién inventó la arquitectura Transformer?", pero tienen un rendimiento deficiente cuando se les hacen preguntas abiertas como "¿Por qué el cielo es azul?". En estos casos más desafiantes, los modelos codificador-decodificador como T5 y BART se usan típicamente para sintetizar la información de una manera bastante similar al resumen de texto. Si te interesa este tipo de respuesta a preguntas generativa, te recomendamos que consultes nuestra demostración basada en el conjunto de datos ELI5.
Preparando los datos[[preparing-the-data]]
El conjunto de datos más utilizado como referencia académica para la respuesta a preguntas extractiva es SQuAD, así que ese es el que usaremos aquí. También existe una referencia más difícil, SQuAD v2, que incluye preguntas que no tienen respuesta. Siempre que tu propio conjunto de datos contenga una columna para contextos, una columna para preguntas y una columna para respuestas, deberías poder adaptar los pasos a continuación.
El conjunto de datos SQuAD[[the-squad-dataset]]
Como de costumbre, podemos descargar y almacenar en caché el conjunto de datos en un solo paso gracias a load_dataset():
from datasets import load_dataset

raw_datasets = load_dataset("squad")
Luego podemos echar un vistazo a este objeto para obtener más información sobre el conjunto de datos SQuAD:
raw_datasets
DatasetDict({
    train: Dataset({
        features: ['id', 'title', 'context', 'question', 'answers'],
        num_rows: 87599
    })
    validation: Dataset({
        features: ['id', 'title', 'context', 'question', 'answers'],
        num_rows: 10570
    })
})
Parece que tenemos todo lo que necesitamos con los campos context, question y answers, así que imprimamos esos para el primer elemento de nuestro conjunto de entrenamiento:
print("Context: ", raw_datasets["train"][0]["context"])
print("Question: ", raw_datasets["train"][0]["question"])
print("Answer: ", raw_datasets["train"][0]["answers"])
Context: 'Architecturally, the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend "Venite Ad Me Omnes". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette Soubirous in 1858. At the end of the main drive (and in a direct line that connects through 3 statues and the Gold Dome), is a simple, modern stone statue of Mary.'
Question: 'To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France?'
Answer: {'text': ['Saint Bernadette Soubirous'], 'answer_start': [515]}
Los campos context y question son muy sencillos de usar. El campo answers es un poco más complicado ya que contiene un diccionario con dos campos que son listas. Este es el formato que esperará la métrica squad durante la evaluación; si estás usando tus propios datos, no necesariamente necesitas preocuparte por poner las respuestas en el mismo formato. El campo text es bastante obvio, y el campo answer_start contiene el índice del carácter inicial de cada respuesta en el contexto.
Durante el entrenamiento, solo hay una respuesta posible. Podemos verificar esto usando el método Dataset.filter():
raw_datasets["train"].filter(lambda x: len(x["answers"]["text"]) != 1)
Dataset({
    features: ['id', 'title', 'context', 'question', 'answers'],
    num_rows: 0
})
Para la evaluación, sin embargo, hay varias respuestas posibles para cada muestra, que pueden ser iguales o diferentes:
print(raw_datasets["validation"][0]["answers"])
print(raw_datasets["validation"][2]["answers"])
{'text': ['Denver Broncos', 'Denver Broncos', 'Denver Broncos'], 'answer_start': [177, 177, 177]}
{'text': ['Santa Clara, California', "Levi's Stadium", "Levi's Stadium in the San Francisco Bay Area at Santa Clara, California."], 'answer_start': [403, 355, 355]}
No profundizaremos en el script de evaluación, ya que todo estará envuelto por una métrica de 🤗 Datasets para nosotros, pero la versión corta es que algunas de las preguntas tienen varias respuestas posibles, y este script comparará una respuesta predicha con todas las respuestas aceptables y tomará la mejor puntuación. Si echamos un vistazo a la muestra en el índice 2, por ejemplo:
print(raw_datasets["validation"][2]["context"])
print(raw_datasets["validation"][2]["question"])
'Super Bowl 50 was an American football game to determine the champion of the National Football League (NFL) for the 2015 season. The American Football Conference (AFC) champion Denver Broncos defeated the National Football Conference (NFC) champion Carolina Panthers 24–10 to earn their third Super Bowl title. The game was played on February 7, 2016, at Levi\'s Stadium in the San Francisco Bay Area at Santa Clara, California. As this was the 50th Super Bowl, the league emphasized the "golden anniversary" with various gold-themed initiatives, as well as temporarily suspending the tradition of naming each Super Bowl game with Roman numerals (under which the game would have been known as "Super Bowl L"), so that the logo could prominently feature the Arabic numerals 50.'
'Where did Super Bowl 50 take place?'
podemos ver que la respuesta puede ser una de las tres posibilidades que vimos antes.
Procesando los datos de entrenamiento[[processing-the-training-data]]
Comencemos con el preprocesamiento de los datos de entrenamiento. La parte difícil será generar etiquetas para la respuesta de la pregunta, que serán las posiciones de inicio y fin de los tokens correspondientes a la respuesta dentro del contexto.
Pero no nos adelantemos. Primero, necesitamos convertir el texto de la entrada en IDs que el modelo pueda entender, usando un tokenizador:
from transformers import AutoTokenizer

model_checkpoint = "bert-base-cased"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
Como se mencionó anteriormente, ajustaremos un modelo BERT, pero puedes usar cualquier otro tipo de modelo siempre que tenga un tokenizador rápido implementado. Puedes ver todas las arquitecturas que vienen con una versión rápida en esta gran tabla, y para verificar que el objeto tokenizer que estás usando está realmente respaldado por 🤗 Tokenizers, puedes mirar su atributo is_fast:
tokenizer.is_fast
True
Podemos pasar a nuestro tokenizador la pregunta y el contexto juntos, y este insertará correctamente los tokens especiales para formar una oración como esta:
[CLS] question [SEP] context [SEP]
Verifiquemos:
context = raw_datasets["train"][0]["context"]
question = raw_datasets["train"][0]["question"]

inputs = tokenizer(question, context)
tokenizer.decode(inputs["input_ids"])
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] Architecturally, '
'the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin '
'Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms '
'upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred '
'Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a '
'replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette '
'Soubirous in 1858. At the end of the main drive ( and in a direct line that connects through 3 statues '
'and the Gold Dome ), is a simple, modern stone statue of Mary. [SEP]'
Las etiquetas serán entonces el índice de los tokens que inician y terminan la respuesta, y el modelo tendrá la tarea de predecir un logit de inicio y fin por token en la entrada, con las etiquetas teóricas siendo las siguientes:
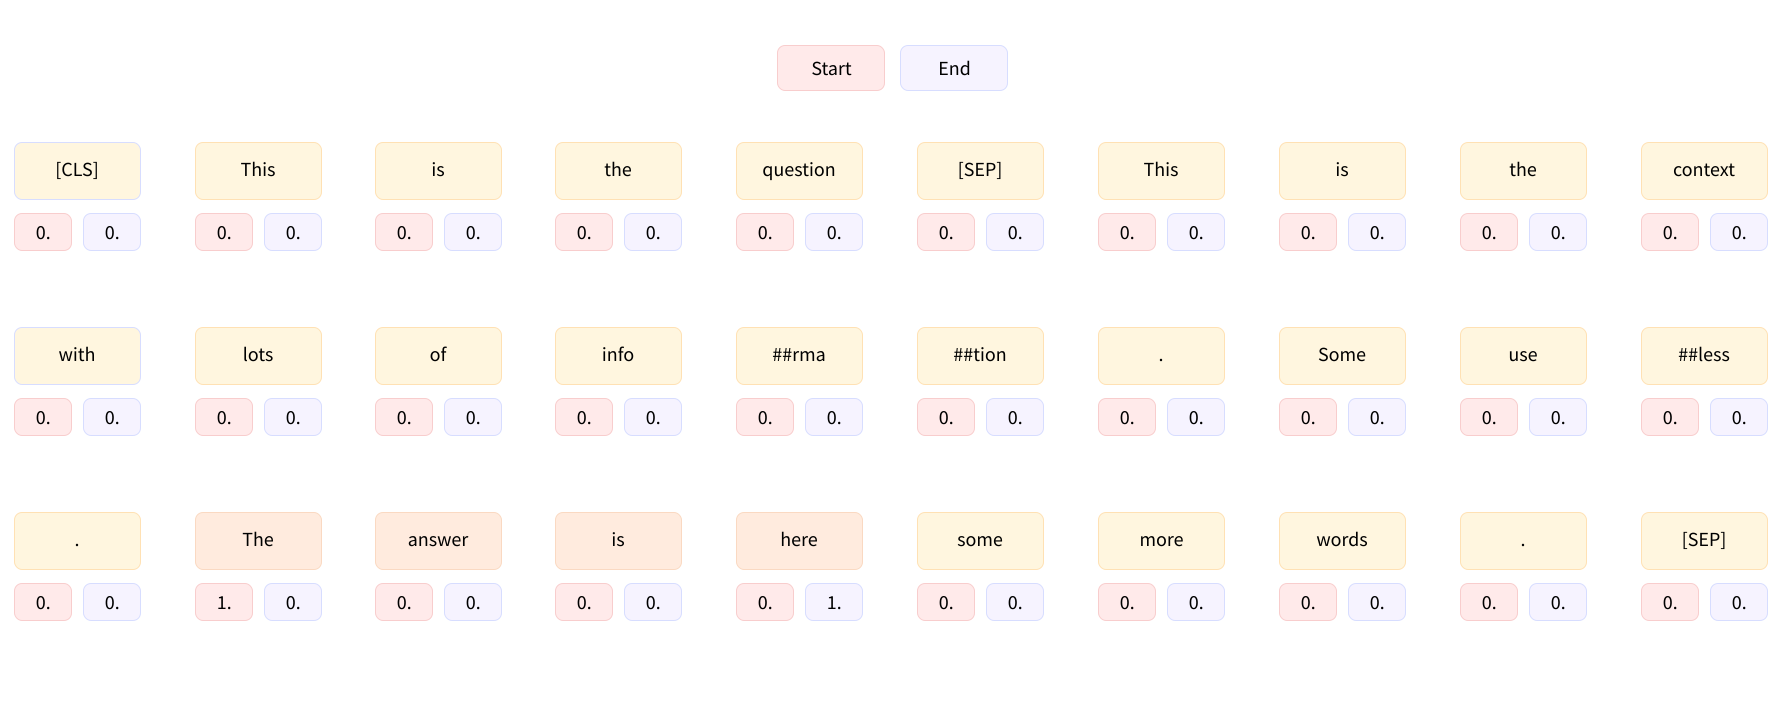
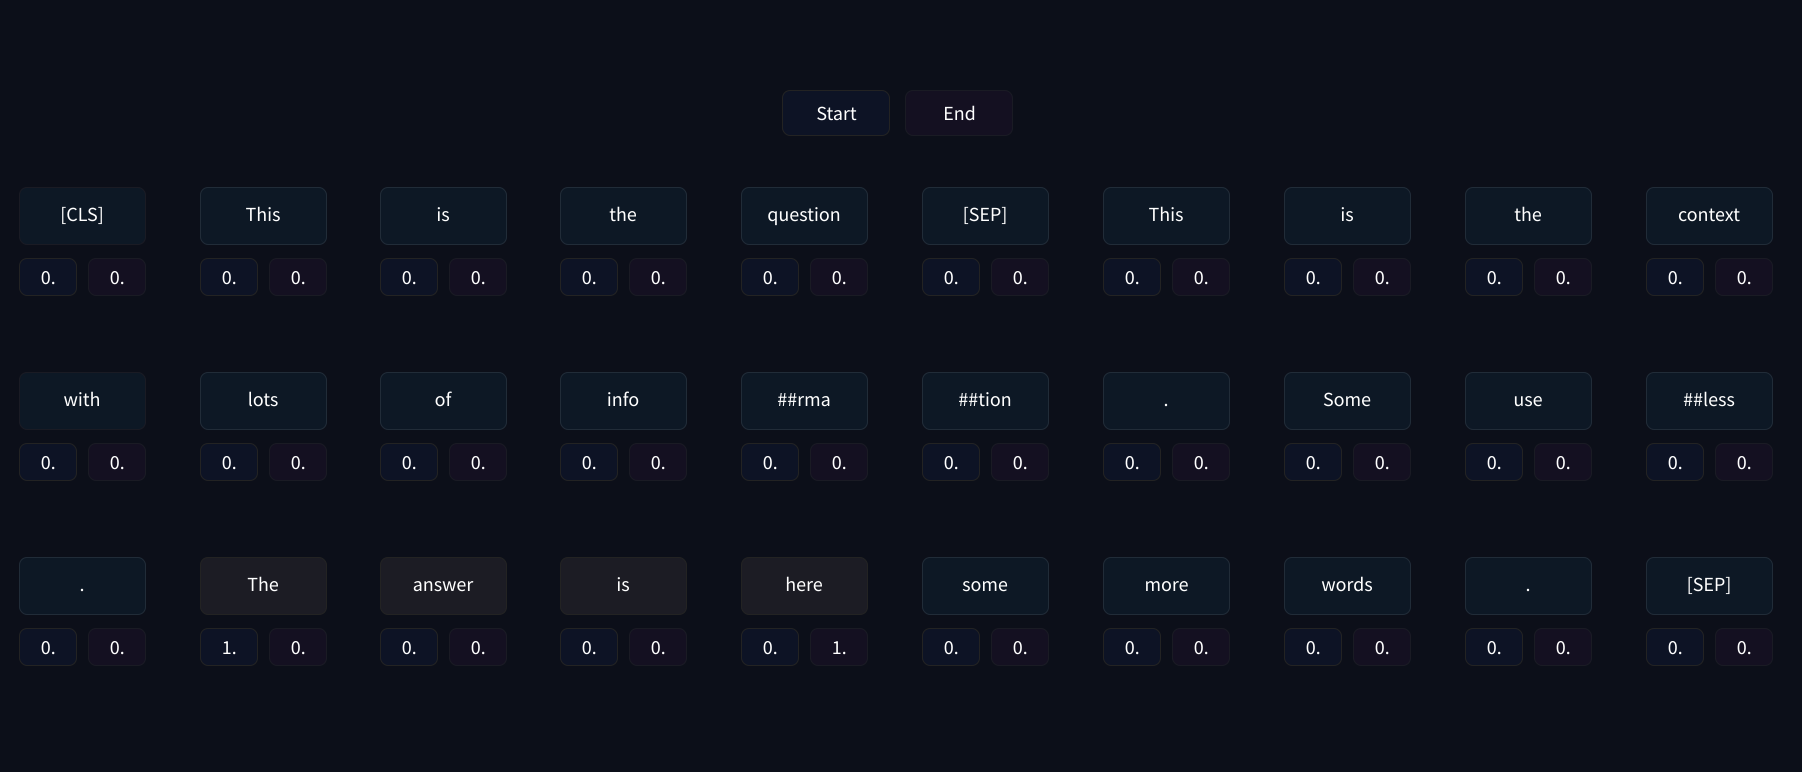
En este caso, el contexto no es demasiado largo, pero algunos de los ejemplos en el conjunto de datos tienen contextos muy largos que excederán la longitud máxima que establecimos (que es 384 en este caso). Como vimos en el Capítulo 6 cuando exploramos los detalles internos del pipeline question-answering, trataremos los contextos largos creando varias características de entrenamiento a partir de una muestra de nuestro conjunto de datos, con una ventana deslizante entre ellas.
Para ver cómo funciona esto usando el ejemplo actual, podemos limitar la longitud a 100 y usar una ventana deslizante de 50 tokens. Como recordatorio, usamos:
max_lengthpara establecer la longitud máxima (aquí 100)truncation="only_second"para truncar el contexto (que está en la segunda posición) cuando la pregunta con su contexto es demasiado largastridepara establecer el número de tokens superpuestos entre dos fragmentos sucesivos (aquí 50)return_overflowing_tokens=Truepara que el tokenizador sepa que queremos los tokens desbordantes
inputs = tokenizer(
    question,
    context,
    max_length=100,
    truncation="only_second",
    stride=50,
    return_overflowing_tokens=True,
)

for ids in inputs["input_ids"]:
    print(tokenizer.decode(ids))
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] Architecturally, the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basi [SEP]'
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a replica of the grotto at Lourdes, France where the Virgin [SEP]'
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP] Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grotto, a Marian place of prayer and reflection. It is a replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette Soubirous in 1858. At the end of the main drive ( and in a direct line that connects through 3 [SEP]'
'[CLS] To whom did the Virgin Mary allegedly appear in 1858 in Lourdes France? [SEP]. It is a replica of the grotto at Lourdes, France where the Virgin Mary reputedly appeared to Saint Bernadette Soubirous in 1858. At the end of the main drive ( and in a direct line that connects through 3 statues and the Gold Dome ), is a simple, modern stone statue of Mary. [SEP]'
Como podemos ver, nuestro ejemplo se ha dividido en cuatro entradas, cada una de ellas conteniendo la pregunta y una parte del contexto. Ten en cuenta que la respuesta a la pregunta ("Bernadette Soubirous") solo aparece en la tercera y última entrada, por lo que al tratar los contextos largos de esta manera crearemos algunos ejemplos de entrenamiento donde la respuesta no está incluida en el contexto. Para esos ejemplos, las etiquetas serán start_position = end_position = 0 (así que predecimos el token [CLS]). También estableceremos esas etiquetas en el desafortunado caso de que la respuesta haya sido truncada de modo que solo tengamos el inicio (o el final) de la misma. Para los ejemplos donde la respuesta está completamente en el contexto, las etiquetas serán el índice del token donde comienza la respuesta y el índice del token donde termina la respuesta.
El conjunto de datos nos proporciona el carácter inicial de la respuesta en el contexto, y al añadir la longitud de la respuesta, podemos encontrar el carácter final en el contexto. Para mapear estos a índices de tokens, necesitaremos usar los mapeos de desplazamiento que estudiamos en el Capítulo 6. Podemos hacer que nuestro tokenizador devuelva estos pasando return_offsets_mapping=True:
inputs = tokenizer(
    question,
    context,
    max_length=100,
    truncation="only_second",
    stride=50,
    return_overflowing_tokens=True,
    return_offsets_mapping=True,
)
inputs.keys()
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'offset_mapping', 'overflow_to_sample_mapping'])
Como podemos ver, obtenemos los IDs de entrada habituales, los IDs de tipo de token y la máscara de atención, así como el mapeo de desplazamiento que solicitamos y una clave adicional, overflow_to_sample_mapping. El valor correspondiente nos será útil cuando tokenicemos varios textos al mismo tiempo (lo cual deberíamos hacer para beneficiarnos del hecho de que nuestro tokenizador está respaldado por Rust). Dado que una muestra puede dar varias características, mapea cada característica al ejemplo del que se originó. Debido a que aquí solo tokenizamos un ejemplo, obtenemos una lista de 0:
inputs["overflow_to_sample_mapping"]
[0, 0, 0, 0]
Pero si tokenizamos más ejemplos, esto será más útil:
inputs = tokenizer(
    raw_datasets["train"][2:6]["question"],
    raw_datasets["train"][2:6]["context"],
    max_length=100,
    truncation="only_second",
    stride=50,
    return_overflowing_tokens=True,
    return_offsets_mapping=True,
)

print(f"The 4 examples gave {len(inputs['input_ids'])} features.")
print(f"Here is where each comes from: {inputs['overflow_to_sample_mapping']}.")
'The 4 examples gave 19 features.'
'Here is where each comes from: [0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 3, 3, 3].'
Como podemos ver, los tres primeros ejemplos (en los índices 2, 3 y 4 del conjunto de entrenamiento) dieron cada uno cuatro características y el último ejemplo (en el índice 5 del conjunto de entrenamiento) dio 7 características.
Esta información será útil para mapear cada característica que obtengamos a su etiqueta correspondiente. Como se mencionó anteriormente, esas etiquetas son:
(0, 0)si la respuesta no está en el tramo correspondiente del contexto(start_position, end_position)si la respuesta está en el tramo correspondiente del contexto, siendostart_positionel índice del token (en los IDs de entrada) al inicio de la respuesta yend_positionel índice del token (en los IDs de entrada) donde termina la respuesta
Para determinar cuál de estos es el caso y, si es relevante, las posiciones de los tokens, primero encontramos los índices que inician y terminan el contexto en los IDs de entrada. Podríamos usar los IDs de tipo de token para hacer esto, pero dado que estos no necesariamente existen para todos los modelos (DistilBERT no los requiere, por ejemplo), en su lugar usaremos el método sequence_ids() del BatchEncoding que devuelve nuestro tokenizador.
Una vez que tenemos esos índices de tokens, miramos los desplazamientos correspondientes, que son tuplas de dos enteros que representan el tramo de caracteres dentro del contexto original. Así podemos detectar si el fragmento del contexto en esta característica comienza después de la respuesta o termina antes de que comience la respuesta (en cuyo caso la etiqueta es (0, 0)). Si ese no es el caso, hacemos un bucle para encontrar el primer y último token de la respuesta:
answers = raw_datasets["train"][2:6]["answers"]
start_positions = []
end_positions = []

for i, offset in enumerate(inputs["offset_mapping"]):
    sample_idx = inputs["overflow_to_sample_mapping"][i]
    answer = answers[sample_idx]
    start_char = answer["answer_start"][0]
    end_char = answer["answer_start"][0] + len(answer["text"][0])
    sequence_ids = inputs.sequence_ids(i)

    # Find the start and end of the context
    idx = 0
    while sequence_ids[idx] != 1:
        idx += 1
    context_start = idx
    while sequence_ids[idx] == 1:
        idx += 1
    context_end = idx - 1

    # If the answer is not fully inside the context, label is (0, 0)
    if offset[context_start][0] > start_char or offset[context_end][1] < end_char:
        start_positions.append(0)
        end_positions.append(0)
    else:
        # Otherwise it's the start and end token positions
        idx = context_start
        while idx <= context_end and offset[idx][0] <= start_char:
            idx += 1
        start_positions.append(idx - 1)

        idx = context_end
        while idx >= context_start and offset[idx][1] >= end_char:
            idx -= 1
        end_positions.append(idx + 1)

start_positions, end_positions
([83, 51, 19, 0, 0, 64, 27, 0, 34, 0, 0, 0, 67, 34, 0, 0, 0, 0, 0],
 [85, 53, 21, 0, 0, 70, 33, 0, 40, 0, 0, 0, 68, 35, 0, 0, 0, 0, 0])
Echemos un vistazo a algunos resultados para verificar que nuestro enfoque es correcto. Para la primera característica encontramos (83, 85) como etiquetas, así que comparemos la respuesta teórica con el fragmento decodificado de tokens del 83 al 85 (inclusive):
idx = 0
sample_idx = inputs["overflow_to_sample_mapping"][idx]
answer = answers[sample_idx]["text"][0]

start = start_positions[idx]
end = end_positions[idx]
labeled_answer = tokenizer.decode(inputs["input_ids"][idx][start : end + 1])

print(f"Theoretical answer: {answer}, labels give: {labeled_answer}")
'Theoretical answer: the Main Building, labels give: the Main Building'
¡Así que coincide! Ahora verifiquemos el índice 4, donde establecimos las etiquetas en (0, 0), lo que significa que la respuesta no está en el fragmento de contexto de esa característica:
idx = 4
sample_idx = inputs["overflow_to_sample_mapping"][idx]
answer = answers[sample_idx]["text"][0]

decoded_example = tokenizer.decode(inputs["input_ids"][idx])
print(f"Theoretical answer: {answer}, decoded example: {decoded_example}")
'Theoretical answer: a Marian place of prayer and reflection, decoded example: [CLS] What is the Grotto at Notre Dame? [SEP] Architecturally, the school has a Catholic character. Atop the Main Building\'s gold dome is a golden statue of the Virgin Mary. Immediately in front of the Main Building and facing it, is a copper statue of Christ with arms upraised with the legend " Venite Ad Me Omnes ". Next to the Main Building is the Basilica of the Sacred Heart. Immediately behind the basilica is the Grot [SEP]'
De hecho, no vemos la respuesta dentro del contexto.
[!TIP] ✏️ ¡Tu turno! Al usar la arquitectura XLNet, el relleno se aplica a la izquierda y la pregunta y el contexto se intercambian. Adapta todo el código que acabamos de ver a la arquitectura XLNet (y añade
padding=True). Ten en cuenta que el token[CLS]puede no estar en la posición 0 con el relleno aplicado.
Ahora que hemos visto paso a paso cómo preprocesar nuestros datos de entrenamiento, podemos agruparlo en una función que aplicaremos a todo el conjunto de datos de entrenamiento. Rellenaremos cada característica a la longitud máxima que establecimos, ya que la mayoría de los contextos serán largos (y las muestras correspondientes se dividirán en varias características), por lo que no hay un beneficio real en aplicar relleno dinámico aquí:
max_length = 384
stride = 128


def preprocess_training_examples(examples):
    questions = [q.strip() for q in examples["question"]]
    inputs = tokenizer(
        questions,
        examples["context"],
        max_length=max_length,
        truncation="only_second",
        stride=stride,
        return_overflowing_tokens=True,
        return_offsets_mapping=True,
        padding="max_length",
    )

    offset_mapping = inputs.pop("offset_mapping")
    sample_map = inputs.pop("overflow_to_sample_mapping")
    answers = examples["answers"]
    start_positions = []
    end_positions = []

    for i, offset in enumerate(offset_mapping):
        sample_idx = sample_map[i]
        answer = answers[sample_idx]
        start_char = answer["answer_start"][0]
        end_char = answer["answer_start"][0] + len(answer["text"][0])
        sequence_ids = inputs.sequence_ids(i)

        # Find the start and end of the context
        idx = 0
        while sequence_ids[idx] != 1:
            idx += 1
        context_start = idx
        while sequence_ids[idx] == 1:
            idx += 1
        context_end = idx - 1

        # If the answer is not fully inside the context, label is (0, 0)
        if offset[context_start][0] > start_char or offset[context_end][1] < end_char:
            start_positions.append(0)
            end_positions.append(0)
        else:
            # Otherwise it's the start and end token positions
            idx = context_start
            while idx <= context_end and offset[idx][0] <= start_char:
                idx += 1
            start_positions.append(idx - 1)

            idx = context_end
            while idx >= context_start and offset[idx][1] >= end_char:
                idx -= 1
            end_positions.append(idx + 1)

    inputs["start_positions"] = start_positions
    inputs["end_positions"] = end_positions
    return inputs
Ten en cuenta que definimos dos constantes para determinar la longitud máxima utilizada, así como la longitud de la ventana deslizante, y que agregamos un pequeño ajuste antes de tokenizar: algunas de las preguntas en el conjunto de datos SQuAD tienen espacios adicionales al principio y al final que no añaden nada (y ocupan espacio al ser tokenizados si usas un modelo como RoBERTa), así que eliminamos esos espacios adicionales.
Para aplicar esta función a todo el conjunto de entrenamiento, usamos el método Dataset.map() con el indicador batched=True. Es necesario aquí ya que estamos cambiando la longitud del conjunto de datos (ya que un ejemplo puede dar varias características de entrenamiento):
train_dataset = raw_datasets["train"].map(
    preprocess_training_examples,
    batched=True,
    remove_columns=raw_datasets["train"].column_names,
)
len(raw_datasets["train"]), len(train_dataset)
(87599, 88729)
Como podemos ver, el preprocesamiento añadió aproximadamente 1,000 características. Nuestro conjunto de entrenamiento ya está listo para ser usado, ¡así que pasemos al preprocesamiento del conjunto de validación!
Procesando los datos de validación[[processing-the-validation-data]]
El preprocesamiento de los datos de validación será un poco más fácil, ya que no necesitamos generar etiquetas (a menos que queramos calcular una pérdida de validación, pero ese número no nos ayudará realmente a entender qué tan bueno es el modelo). La verdadera alegría será interpretar las predicciones del modelo en fragmentos del contexto original. Para esto, solo necesitaremos almacenar tanto los mapeos de desplazamiento como alguna forma de hacer coincidir cada característica creada con el ejemplo original del que proviene. Dado que hay una columna de ID en el conjunto de datos original, usaremos ese ID.
Lo único que añadiremos aquí es un pequeño ajuste en los mapeos de desplazamiento. Contendrán desplazamientos para la pregunta y el contexto, pero una vez que estemos en la etapa de postprocesamiento no tendremos forma de saber qué parte de los IDs de entrada correspondía al contexto y qué parte era la pregunta (el método sequence_ids() que usamos solo está disponible para la salida del tokenizador). Por lo tanto, estableceremos los desplazamientos correspondientes a la pregunta en None:
def preprocess_validation_examples(examples):
    questions = [q.strip() for q in examples["question"]]
    inputs = tokenizer(
        questions,
        examples["context"],
        max_length=max_length,
        truncation="only_second",
        stride=stride,
        return_overflowing_tokens=True,
        return_offsets_mapping=True,
        padding="max_length",
    )

    sample_map = inputs.pop("overflow_to_sample_mapping")
    example_ids = []

    for i in range(len(inputs["input_ids"])):
        sample_idx = sample_map[i]
        example_ids.append(examples["id"][sample_idx])

        sequence_ids = inputs.sequence_ids(i)
        offset = inputs["offset_mapping"][i]
        inputs["offset_mapping"][i] = [
            o if sequence_ids[k] == 1 else None for k, o in enumerate(offset)
        ]

    inputs["example_id"] = example_ids
    return inputs
Podemos aplicar esta función a todo el conjunto de datos de validación como antes:
validation_dataset = raw_datasets["validation"].map(
    preprocess_validation_examples,
    batched=True,
    remove_columns=raw_datasets["validation"].column_names,
)
len(raw_datasets["validation"]), len(validation_dataset)
(10570, 10822)
En este caso, solo hemos añadido un par de cientos de muestras, por lo que parece que los contextos en el conjunto de datos de validación son un poco más cortos.
Ahora que hemos preprocesado todos los datos, podemos pasar al entrenamiento.
{#if fw === 'pt'}
Ajuste fino del modelo con la API Trainer[[fine-tuning-the-model-with-the-trainer-api]]
El código de entrenamiento para este ejemplo se parecerá mucho al código de las secciones anteriores; lo más difícil será escribir la función compute_metrics(). Dado que rellenamos todas las muestras a la longitud máxima que establecimos, no hay un recopilador de datos que definir, por lo que el cálculo de esta métrica es realmente lo único de lo que tenemos que preocuparnos. La parte difícil será postprocesar las predicciones del modelo en fragmentos de texto en los ejemplos originales; una vez que hayamos hecho eso, la métrica de la biblioteca 🤗 Datasets hará la mayor parte del trabajo por nosotros.
{:else}
Ajuste fino del modelo con Keras[[fine-tuning-the-model-with-keras]]
El código de entrenamiento para este ejemplo se parecerá mucho al código de las secciones anteriores, pero el cálculo de las métricas será un desafío único. Dado que rellenamos todas las muestras a la longitud máxima que establecimos, no hay un recopilador de datos que definir, por lo que el cálculo de esta métrica es realmente lo único de lo que tenemos que preocuparnos. La parte difícil será postprocesar las predicciones del modelo en fragmentos de texto en los ejemplos originales; una vez que hayamos hecho eso, la métrica de la biblioteca 🤗 Datasets hará la mayor parte del trabajo por nosotros.
{/if}
Postprocesamiento[[post-processing]]
{#if fw === 'pt'}
{:else}
{/if}
El modelo generará logits para las posiciones de inicio y fin de la respuesta en los IDs de entrada, como vimos durante nuestra exploración del pipeline question-answering. El paso de postprocesamiento será similar a lo que hicimos allí, así que aquí tienes un breve recordatorio de las acciones que tomamos:
- Enmascaramos los logits de inicio y fin correspondientes a tokens fuera del contexto.
- Luego convertimos los logits de inicio y fin en probabilidades usando una softmax.
- Atribuimos una puntuación a cada par
(start_token, end_token)tomando el producto de las dos probabilidades correspondientes. - Buscamos el par con la puntuación máxima que produjera una respuesta válida (por ejemplo, un
start_tokenmenor queend_token).
Aquí cambiaremos ligeramente este proceso porque no necesitamos calcular puntuaciones reales (solo la respuesta predicha). Esto significa que podemos omitir el paso de softmax. Para ir más rápido, tampoco puntuaremos todos los pares (start_token, end_token) posibles, sino solo los que corresponden a los logits n_best más altos (con n_best=20). Dado que omitiremos la softmax, esas puntuaciones serán puntuaciones de logit, y se obtendrán tomando la suma de los logits de inicio y fin (en lugar del producto, debido a la regla \(\log(ab) = \log(a) + \log(b)\)).
Para demostrar todo esto, necesitaremos algún tipo de predicciones. Como aún no hemos entrenado nuestro modelo, vamos a usar el modelo predeterminado para el pipeline de QA para generar algunas predicciones en una pequeña parte del conjunto de validación. Podemos usar la misma función de procesamiento que antes; como se basa en la constante global tokenizer, solo tenemos que cambiar ese objeto al tokenizador del modelo que queremos usar temporalmente:
small_eval_set = raw_datasets["validation"].select(range(100))
trained_checkpoint = "distilbert-base-cased-distilled-squad"

tokenizer = AutoTokenizer.from_pretrained(trained_checkpoint)
eval_set = small_eval_set.map(
    preprocess_validation_examples,
    batched=True,
    remove_columns=raw_datasets["validation"].column_names,
)
Ahora que el preprocesamiento está hecho, volvemos a cambiar el tokenizador al que elegimos originalmente:
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
Luego eliminamos las columnas de nuestro eval_set que no son esperadas por el modelo, construimos un lote con todo ese pequeño conjunto de validación y lo pasamos por el modelo. Si hay una GPU disponible, la usamos para ir más rápido:
{#if fw === 'pt'}
from transformers import AutoModelForQuestionAnswering

eval_set_for_model = eval_set.remove_columns(["example_id", "offset_mapping"])
eval_set_for_model.set_format("torch")

device = torch.device("cuda") if torch.cuda.is_available() else torch.device("cpu")
batch = {k: eval_set_for_model[k].to(device) for k in eval_set_for_model.column_names}
trained_model = AutoModelForQuestionAnswering.from_pretrained(trained_checkpoint).to(
    device
)

with torch.no_grad():
    outputs = trained_model(**batch)
Dado que el Trainer nos dará predicciones como arreglos NumPy, tomamos los logits de inicio y fin y los convertimos a ese formato:
start_logits = outputs.start_logits.cpu().numpy()
end_logits = outputs.end_logits.cpu().numpy()
{:else}
from transformers import TFAutoModelForQuestionAnswering

eval_set_for_model = eval_set.remove_columns(["example_id", "offset_mapping"])
eval_set_for_model.set_format("numpy")

batch = {k: eval_set_for_model[k] for k in eval_set_for_model.column_names}
trained_model = TFAutoModelForQuestionAnswering.from_pretrained(trained_checkpoint)

outputs = trained_model(**batch)
Para facilitar la experimentación, convirtamos estas salidas a arreglos NumPy:
start_logits = outputs.start_logits.numpy()
end_logits = outputs.end_logits.numpy()
{/if}
Ahora, necesitamos encontrar la respuesta predicha para cada ejemplo en nuestro small_eval_set. Un ejemplo puede haberse dividido en varias características en eval_set, por lo que el primer paso es mapear cada ejemplo en small_eval_set a las características correspondientes en eval_set:
example_to_features = collections.defaultdict(list)
for idx, feature in enumerate(eval_set):
    example_to_features[feature["example_id"]].append(idx)
Con esto en mano, podemos ponernos manos a la obra recorriendo todos los ejemplos y, para cada ejemplo, todas las características asociadas. Como dijimos antes, analizaremos las puntuaciones de logit para los logits de inicio n_best y los logits de fin, excluyendo las posiciones que dan:
- Una respuesta que no estaría dentro del contexto
- Una respuesta con longitud negativa
- Una respuesta demasiado larga (limitamos las posibilidades a
max_answer_length=30)
Una vez que tenemos todas las posibles respuestas puntuadas para un ejemplo, simplemente elegimos la que tiene la mejor puntuación de logit:
n_best = 20
max_answer_length = 30
predicted_answers = []

for example in small_eval_set:
    example_id = example["id"]
    context = example["context"]
    answers = []

    for feature_index in example_to_features[example_id]:
        start_logit = start_logits[feature_index]
        end_logit = end_logits[feature_index]
        offsets = eval_set["offset_mapping"][feature_index]

        start_indexes = np.argsort(start_logit)[-1 : -n_best - 1 : -1].tolist()
        end_indexes = np.argsort(end_logit)[-1 : -n_best - 1 : -1].tolist()
        for start_index in start_indexes:
            for end_index in end_indexes:
                # Skip answers that are not fully in the context
                if offsets[start_index] is None or offsets[end_index] is None:
                    continue
                # Skip answers with a length that is either < 0 or > max_answer_length.
                if (
                    end_index < start_index
                    or end_index - start_index + 1 > max_answer_length
                ):
                    continue

                answers.append(
                    {
                        "text": context[offsets[start_index][0] : offsets[end_index][1]],
                        "logit_score": start_logit[start_index] + end_logit[end_index],
                    }
                )

    best_answer = max(answers, key=lambda x: x["logit_score"])
    predicted_answers.append({"id": example_id, "prediction_text": best_answer["text"]})
El formato final de las respuestas predichas es el que esperará la métrica que usaremos. Como de costumbre, podemos cargarla con la ayuda de la biblioteca 🤗 Evaluate:
metric = evaluate.load("squad")
Esta métrica espera las respuestas predichas en el formato que vimos anteriormente (una lista de diccionarios con una clave para el ID del ejemplo y una clave para el texto predicho) y las respuestas teóricas en el formato siguiente (una lista de diccionarios con una clave para el ID del ejemplo y una clave para las posibles respuestas):
theoretical_answers = [
    {"id": ex["id"], "answers": ex["answers"]} for ex in small_eval_set
]
Ahora podemos verificar que obtenemos resultados sensatos mirando el primer elemento de ambas listas:
print(predicted_answers[0])
print(theoretical_answers[0])
{'id': '56be4db0acb8001400a502ec', 'prediction_text': 'Denver Broncos'}
{'id': '56be4db0acb8001400a502ec', 'answers': {'text': ['Denver Broncos', 'Denver Broncos', 'Denver Broncos'], 'answer_start': [177, 177, 177]}}
¡No está mal! Ahora echemos un vistazo a la puntuación que nos da la métrica:
metric.compute(predictions=predicted_answers, references=theoretical_answers)
{'exact_match': 83.0, 'f1': 88.25}
De nuevo, eso es bastante bueno considerando que, según su artículo, DistilBERT ajustado en SQuAD obtiene 79.1 y 86.9 para esas puntuaciones en todo el conjunto de datos.
{#if fw === 'pt'}
Ahora pongamos todo lo que acabamos de hacer en una función compute_metrics() que usaremos en el Trainer. Normalmente, esa función compute_metrics() solo recibe una tupla eval_preds con logits y etiquetas. Aquí necesitaremos un poco más, ya que tenemos que buscar en el conjunto de datos de características el desplazamiento y en el conjunto de datos de ejemplos los contextos originales, por lo que no podremos usar esta función para obtener resultados de evaluación regulares durante el entrenamiento. Solo la usaremos al final del entrenamiento para verificar los resultados.
La función compute_metrics() agrupa los mismos pasos que antes; solo agregamos una pequeña verificación en caso de que no encontremos ninguna respuesta válida (en cuyo caso predecimos una cadena vacía).
{:else}
Ahora pongamos todo lo que acabamos de hacer en una función compute_metrics() que usaremos después de entrenar nuestro modelo. Necesitaremos pasar un poco más que solo los logits de salida, ya que tenemos que buscar en el conjunto de datos de características el desplazamiento y en el conjunto de datos de ejemplos los contextos originales:
{/if}
from tqdm.auto import tqdm


def compute_metrics(start_logits, end_logits, features, examples):
    example_to_features = collections.defaultdict(list)
    for idx, feature in enumerate(features):
        example_to_features[feature["example_id"]].append(idx)

    predicted_answers = []
    for example in tqdm(examples):
        example_id = example["id"]
        context = example["context"]
        answers = []

        # Loop through all features associated with that example
        for feature_index in example_to_features[example_id]:
            start_logit = start_logits[feature_index]
            end_logit = end_logits[feature_index]
            offsets = features[feature_index]["offset_mapping"]

            start_indexes = np.argsort(start_logit)[-1 : -n_best - 1 : -1].tolist()
            end_indexes = np.argsort(end_logit)[-1 : -n_best - 1 : -1].tolist()
            for start_index in start_indexes:
                for end_index in end_indexes:
                    # Skip answers that are not fully in the context
                    if offsets[start_index] is None or offsets[end_index] is None:
                        continue
                    # Skip answers with a length that is either < 0 or > max_answer_length
                    if (
                        end_index < start_index
                        or end_index - start_index + 1 > max_answer_length
                    ):
                        continue

                    answer = {
                        "text": context[offsets[start_index][0] : offsets[end_index][1]],
                        "logit_score": start_logit[start_index] + end_logit[end_index],
                    }
                    answers.append(answer)

        # Select the answer with the best score
        if len(answers) > 0:
            best_answer = max(answers, key=lambda x: x["logit_score"])
            predicted_answers.append(
                {"id": example_id, "prediction_text": best_answer["text"]}
            )
        else:
            predicted_answers.append({"id": example_id, "prediction_text": ""})

    theoretical_answers = [{"id": ex["id"], "answers": ex["answers"]} for ex in examples]
    return metric.compute(predictions=predicted_answers, references=theoretical_answers)
Podemos verificar que funciona con nuestras predicciones:
compute_metrics(start_logits, end_logits, eval_set, small_eval_set)
{'exact_match': 83.0, 'f1': 88.25}
¡Se ve bien! Ahora usemos esto para ajustar nuestro modelo.
Ajustar el modelo (fine-tuning)[[fine-tuning-the-model]]
{#if fw === 'pt'}
Ahora estamos listos para entrenar nuestro modelo. Primero, vamos a crearlo, usando la clase AutoModelForQuestionAnswering como antes:
model = AutoModelForQuestionAnswering.from_pretrained(model_checkpoint)
{:else}
Ahora estamos listos para entrenar nuestro modelo. Primero, vamos a crearlo, usando la clase TFAutoModelForQuestionAnswering como antes:
model = TFAutoModelForQuestionAnswering.from_pretrained(model_checkpoint)
{/if}
Como de costumbre, recibimos una advertencia de que algunos pesos no se usan (los de la cabeza de preentrenamiento) y otros se inicializan aleatoriamente (los de la cabeza de respuesta a preguntas). Ya deberías estar acostumbrado a esto, pero significa que este modelo no está listo para usarse todavía y necesita un ajuste fino (fine-tuning). ¡Qué bueno que estamos a punto de hacerlo!
Para poder subir nuestro modelo al Hub, tendremos que iniciar sesión en Hugging Face. Si estás ejecutando este código en un notebook, puedes hacerlo con la siguiente función de utilidad, que muestra un widget donde puedes ingresar tus credenciales de inicio de sesión:
from huggingface_hub import notebook_login

notebook_login()
Si no estás trabajando en un notebook, simplemente escribe la siguiente línea en tu terminal:
huggingface-cli login
{#if fw === 'pt'}
Una vez hecho esto, podemos definir nuestro TrainingArguments. Como dijimos cuando definimos nuestra función para calcular la métrica, no podremos tener un ciclo de evaluación regular debido a la firma de la función compute_metrics(). Podríamos escribir nuestra propia subclase de Trainer para hacer esto (un enfoque que puedes encontrar en el script de ejemplo de respuesta a preguntas), pero eso es un poco largo para esta sección. En su lugar, solo evaluaremos el modelo al final del entrenamiento aquí y te mostraremos cómo hacer una evaluación regular en "Un ciclo de entrenamiento personalizado" a continuación.
Aquí es realmente donde la API Trainer muestra sus límites y la biblioteca 🤗 Accelerate brilla: personalizar la clase para un caso de uso específico puede ser doloroso, pero ajustar un ciclo de entrenamiento completamente expuesto es fácil.
Veamos nuestro TrainingArguments:
from transformers import TrainingArguments

args = TrainingArguments(
    "bert-finetuned-squad",
    evaluation_strategy="no",
    save_strategy="epoch",
    learning_rate=2e-5,
    num_train_epochs=3,
    weight_decay=0.01,
    fp16=True,
    push_to_hub=True,
)
Ya hemos visto la mayoría de estos antes: configuramos algunos hiperparámetros (como la tasa de aprendizaje, el número de épocas que entrenamos y algo de decaimiento de peso) e indicamos que queremos guardar el modelo al final de cada época, omitir la evaluación y subir nuestros resultados al Model Hub. También habilitamos el entrenamiento de precisión mixta con fp16=True, ya que puede acelerar el entrenamiento de manera agradable en una GPU reciente.
{:else}
Una vez hecho esto, podemos crear nuestros TF Datasets. Esta vez podemos usar el simple recopilador de datos predeterminado:
from transformers import DefaultDataCollator

data_collator = DefaultDataCollator(return_tensors="tf")
Y ahora creamos los conjuntos de datos como de costumbre.
tf_train_dataset = model.prepare_tf_dataset(
    train_dataset,
    collate_fn=data_collator,
    shuffle=True,
    batch_size=16,
)
tf_eval_dataset = model.prepare_tf_dataset(
    validation_dataset,
    collate_fn=data_collator,
    shuffle=False,
    batch_size=16,
)
A continuación, configuramos nuestros hiperparámetros de entrenamiento y compilamos nuestro modelo:
from transformers import create_optimizer
from transformers.keras_callbacks import PushToHubCallback


# The number of training steps is the number of samples in the dataset, divided by the batch size then multiplied
# by the total number of epochs. Note that the tf_train_dataset here is a batched tf.data.Dataset,
# not the original Hugging Face Dataset, so its len() is already num_samples // batch_size.
num_train_epochs = 3
num_train_steps = len(tf_train_dataset) * num_train_epochs
optimizer, schedule = create_optimizer(
    init_lr=2e-5,
    num_warmup_steps=0,
    num_train_steps=num_train_steps,
    weight_decay_rate=0.01,
)
model.compile(optimizer=optimizer)

# Train in mixed-precision float16
tf.keras.mixed_precision.set_global_policy("mixed_float16")
Finalmente, estamos listos para entrenar con model.fit(). Usamos un PushToHubCallback para subir el modelo al Hub después de cada época.
{/if}
Por defecto, el repositorio utilizado estará en tu espacio de nombres y se nombrará según el directorio de salida que configuraste, así que en nuestro caso estará en "sgugger/bert-finetuned-squad". Podemos anular esto pasando un hub_model_id; por ejemplo, para subir el modelo a la organización huggingface_course usamos hub_model_id="huggingface_course/bert-finetuned-squad" (que es el modelo al que enlazamos al principio de esta sección).
{#if fw === 'pt'}
[!TIP] 💡 Si el directorio de salida que estás usando existe, debe ser un clon local del repositorio al que quieres subir (así que establece un nuevo nombre si obtienes un error al definir tu
Trainer).
Finalmente, simplemente pasamos todo a la clase Trainer y lanzamos el entrenamiento:
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=train_dataset,
    eval_dataset=validation_dataset,
    tokenizer=tokenizer,
)
trainer.train()
{:else}
from transformers.keras_callbacks import PushToHubCallback

callback = PushToHubCallback(output_dir="bert-finetuned-squad", tokenizer=tokenizer)

# We're going to do validation afterwards, so no validation mid-training
model.fit(tf_train_dataset, callbacks=[callback], epochs=num_train_epochs)
{/if}
Ten en cuenta que mientras ocurre el entrenamiento, cada vez que se guarda el modelo (aquí, cada época) se sube al Hub en segundo plano. De esta manera, podrás reanudar tu entrenamiento en otra máquina si es necesario. Todo el entrenamiento lleva un tiempo (un poco más de una hora en una Titan RTX), así que puedes tomar un café o releer algunas de las partes del curso que te han parecido más desafiantes mientras avanza. También ten en cuenta que tan pronto como finalice la primera época, verás algunos pesos subidos al Hub y podrás empezar a jugar con tu modelo en su página.
{#if fw === 'pt'}
Una vez que el entrenamiento está completo, finalmente podemos evaluar nuestro modelo (y rezar para no haber gastado todo ese tiempo de cómputo en vano). El método predict() del Trainer devolverá una tupla donde los primeros elementos serán las predicciones del modelo (aquí un par con los logits de inicio y fin). Enviamos esto a nuestra función compute_metrics():
predictions, _, _ = trainer.predict(validation_dataset)
start_logits, end_logits = predictions
compute_metrics(start_logits, end_logits, validation_dataset, raw_datasets["validation"])
{:else}
Una vez que el entrenamiento está completo, finalmente podemos evaluar nuestro modelo (y rezar para no haber gastado todo ese tiempo de cómputo en vano). El método predict() de nuestro model se encargará de obtener las predicciones, y como hicimos todo el trabajo duro de definir una función compute_metrics() antes, podemos obtener nuestros resultados en una sola línea:
predictions = model.predict(tf_eval_dataset)
compute_metrics(
    predictions["start_logits"],
    predictions["end_logits"],
    validation_dataset,
    raw_datasets["validation"],
)
{/if}
{'exact_match': 81.18259224219489, 'f1': 88.67381321905516}
¡Genial! Como comparación, las puntuaciones de referencia reportadas en el artículo de BERT para este modelo son 80.8 y 88.5, así que estamos justo donde deberíamos estar.
{#if fw === 'pt'}
Finalmente, usamos el método push_to_hub() para asegurarnos de subir la última versión del modelo:
trainer.push_to_hub(commit_message="Training complete")
Esto devuelve la URL del commit que acaba de hacer, si quieres inspeccionarlo:
'https://huggingface.co/sgugger/bert-finetuned-squad/commit/9dcee1fbc25946a6ed4bb32efb1bd71d5fa90b68'
El Trainer también redacta una tarjeta de modelo con todos los resultados de la evaluación y la sube.
{/if}
En esta etapa, puedes usar el widget de inferencia en el Model Hub para probar el modelo y compartirlo con tus amigos, familiares y mascotas favoritas. Has ajustado con éxito un modelo en una tarea de respuesta a preguntas. ¡Felicidades!
[!TIP] ✏️ ¡Tu turno! ¡Prueba otra arquitectura de modelo para ver si funciona mejor en esta tarea!
{#if fw === 'pt'}
Si quieres profundizar un poco más en el ciclo de entrenamiento, ahora te mostraremos cómo hacer lo mismo usando 🤗 Accelerate.
Un ciclo de entrenamiento personalizado[[a-custom-training-loop]]
Ahora veamos el ciclo de entrenamiento completo, para que puedas personalizar fácilmente las partes que necesites. Se parecerá mucho al ciclo de entrenamiento del Capítulo 3, con la excepción del ciclo de evaluación. Podremos evaluar el modelo regularmente ya que ya no estamos limitados por la clase Trainer.
Preparando todo para el entrenamiento[[preparing-everything-for-training]]
Primero necesitamos construir los DataLoader a partir de nuestros conjuntos de datos. Establecemos el formato de esos conjuntos de datos en "torch", y eliminamos las columnas en el conjunto de validación que no son utilizadas por el modelo. Luego, podemos usar el default_data_collator proporcionado por Transformers como un collate_fn y barajar el conjunto de entrenamiento, pero no el conjunto de validación:
from torch.utils.data import DataLoader
from transformers import default_data_collator

train_dataset.set_format("torch")
validation_set = validation_dataset.remove_columns(["example_id", "offset_mapping"])
validation_set.set_format("torch")

train_dataloader = DataLoader(
    train_dataset,
    shuffle=True,
    collate_fn=default_data_collator,
    batch_size=8,
)
eval_dataloader = DataLoader(
    validation_set, collate_fn=default_data_collator, batch_size=8
)
A continuación, volvemos a instanciar nuestro modelo, para asegurarnos de que no estamos continuando el ajuste fino de antes, sino comenzando de nuevo desde el modelo preentrenado de BERT:
model = AutoModelForQuestionAnswering.from_pretrained(model_checkpoint)
Luego necesitaremos un optimizador. Como de costumbre, usamos el clásico AdamW, que es como Adam, pero con una corrección en la forma en que se aplica el decaimiento de peso:
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=2e-5)
Una vez que tenemos todos esos objetos, podemos enviarlos al método accelerator.prepare(). Recuerda que si quieres entrenar en TPUs en un notebook de Colab, tendrás que mover todo este código a una función de entrenamiento, y eso no debería ejecutar ninguna celda que instancie un Accelerator. Podemos forzar el entrenamiento de precisión mixta pasando fp16=True al Accelerator (o, si estás ejecutando el código como un script, solo asegúrate de completar el config de 🤗 Accelerate apropiadamente).
from accelerate import Accelerator

accelerator = Accelerator(fp16=True)
model, optimizer, train_dataloader, eval_dataloader = accelerator.prepare(
    model, optimizer, train_dataloader, eval_dataloader
)
Como ya deberías saber de las secciones anteriores, solo podemos usar la longitud train_dataloader para calcular el número de pasos de entrenamiento después de que haya pasado por el método accelerator.prepare(). Usamos el mismo programa lineal que en las secciones anteriores:
from transformers import get_scheduler

num_train_epochs = 3
num_update_steps_per_epoch = len(train_dataloader)
num_training_steps = num_train_epochs * num_update_steps_per_epoch

lr_scheduler = get_scheduler(
    "linear",
    optimizer=optimizer,
    num_warmup_steps=0,
    num_training_steps=num_training_steps,
)
Para subir nuestro modelo al Hub, necesitaremos crear un objeto Repository en una carpeta de trabajo. Primero inicia sesión en Hugging Face Hub, si aún no lo has hecho. Determinaremos el nombre del repositorio a partir del ID del modelo que queremos darle a nuestro modelo (siéntete libre de reemplazar el repo_name con tu propia elección; solo necesita contener tu nombre de usuario, que es lo que hace la función get_full_repo_name()):
from huggingface_hub import Repository, get_full_repo_name

model_name = "bert-finetuned-squad-accelerate"
repo_name = get_full_repo_name(model_name)
repo_name
'sgugger/bert-finetuned-squad-accelerate'
Luego podemos clonar ese repositorio en una carpeta local. Si ya existe, esta carpeta local debe ser un clon del repositorio con el que estamos trabajando:
output_dir = "bert-finetuned-squad-accelerate"
repo = Repository(output_dir, clone_from=repo_name)
Ahora podemos subir cualquier cosa que guardemos en output_dir llamando al método repo.push_to_hub(). Esto nos ayudará a subir los modelos intermedios al final de cada época.
Ciclo de entrenamiento[[training-loop]]
Ahora estamos listos para escribir el ciclo de entrenamiento completo. Después de definir una barra de progreso para seguir cómo va el entrenamiento, el ciclo tiene tres partes:
- El entrenamiento en sí, que es la iteración clásica sobre el
train_dataloader, el paso hacia adelante a través del modelo, luego el paso hacia atrás y el paso del optimizador. - La evaluación, en la que recopilamos todos los valores para
start_logitsyend_logitsantes de convertirlos en arreglos NumPy. Una vez que finaliza el ciclo de evaluación, concatenamos todos los resultados. Ten en cuenta que necesitamos truncar porque elAcceleratorpuede haber agregado algunas muestras al final para asegurar que tengamos el mismo número de ejemplos en cada proceso. - Guardar y subir, donde primero guardamos el modelo y el tokenizador, luego llamamos a
repo.push_to_hub(). Como hicimos antes, usamos el argumentoblocking=Falsepara indicarle a la biblioteca 🤗 Hub que suba en un proceso asíncrono. De esta manera, el entrenamiento continúa normalmente y esta instrucción (larga) se ejecuta en segundo plano.
Aquí está el código completo para el ciclo de entrenamiento:
from tqdm.auto import tqdm


progress_bar = tqdm(range(num_training_steps))

for epoch in range(num_train_epochs):
    # Training
    model.train()
    for step, batch in enumerate(train_dataloader):
        outputs = model(**batch)
        loss = outputs.loss
        accelerator.backward(loss)

        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()
        progress_bar.update(1)

    # Evaluation
    model.eval()
    start_logits = []
    end_logits = []
    accelerator.print("Evaluation!")
    for batch in tqdm(eval_dataloader):
        with torch.no_grad():
            outputs = model(**batch)

        start_logits.append(accelerator.gather(outputs.start_logits).cpu().numpy())
        end_logits.append(accelerator.gather(outputs.end_logits).cpu().numpy())

    start_logits = np.concatenate(start_logits)
    end_logits = np.concatenate(end_logits)
    start_logits = start_logits[: len(validation_dataset)]
    end_logits = end_logits[: len(validation_dataset)]

    metrics = compute_metrics(
        start_logits, end_logits, validation_dataset, raw_datasets["validation"]
    )
    print(f"epoch {epoch}:", metrics)

    # Save and upload
    accelerator.wait_for_everyone()
    unwrapped_model = accelerator.unwrap_model(model)
    unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
    if accelerator.is_main_process:
        tokenizer.save_pretrained(output_dir)
        repo.push_to_hub(
            commit_message=f"Training in progress epoch {epoch}", blocking=False
        )
En caso de que sea la primera vez que ves un modelo guardado con 🤗 Accelerate, tomemos un momento para inspeccionar las tres líneas de código que lo acompañan:
accelerator.wait_for_everyone()
unwrapped_model = accelerator.unwrap_model(model)
unwrapped_model.save_pretrained(output_dir, save_function=accelerator.save)
La primera línea se explica por sí misma: les dice a todos los procesos que esperen hasta que todos estén en esa etapa antes de continuar. Esto es para asegurarnos de tener el mismo modelo en cada proceso antes de guardar. Luego tomamos el unwrapped_model, que es el modelo base que definimos. El método accelerator.prepare() cambia el modelo para que funcione en entrenamiento distribuido, por lo que ya no tendrá el método save_pretrained(); el método accelerator.unwrap_model() deshace ese paso. Por último, llamamos a save_pretrained() pero le decimos a ese método que use accelerator.save() en lugar de torch.save().
Una vez hecho esto, deberías tener un modelo que produzca resultados bastante similares al entrenado con el Trainer. Puedes verificar el modelo que entrenamos usando este código en huggingface-course/bert-finetuned-squad-accelerate. Y si quieres probar cualquier ajuste al ciclo de entrenamiento, ¡puedes implementarlos directamente editando el código que se muestra arriba!
{/if}
Usando el modelo ajustado (fine-tuned)[[using-the-fine-tuned-model]]
Ya te hemos mostrado cómo puedes usar el modelo que ajustamos en el Model Hub con el widget de inferencia. Para usarlo localmente en un pipeline, solo tienes que especificar el identificador del modelo:
from transformers import pipeline

# Replace this with your own checkpoint
model_checkpoint = "huggingface-course/bert-finetuned-squad"
question_answerer = pipeline("question-answering", model=model_checkpoint)

context = """
🤗 Transformers is backed by the three most popular deep learning libraries — Jax, PyTorch and TensorFlow — with a seamless integration
between them. It's straightforward to train your models with one before loading them for inference with the other.
"""
question = "Which deep learning libraries back 🤗 Transformers?"
question_answerer(question=question, context=context)
{'score': 0.9979003071784973,
 'start': 78,
 'end': 105,
 'answer': 'Jax, PyTorch and TensorFlow'}
¡Genial! ¡Nuestro modelo funciona tan bien como el predeterminado para este pipeline!