Ajuste fino de LLM
Ajuste fino de LLM
Aquí discutimos el ajuste fino de Meta Llama con un par de recetas diferentes. Cubriremos dos escenarios aquí:
1. Ajuste fino de modelos con parámetros eficientes
Esto ayuda a que el proceso de ajuste fino sea más asequible, incluso en una GPU de consumo. Estos métodos nos permiten mantener todo el modelo congelado y solo agregar pequeños parámetros/capas entrenables al modelo. De esta manera, solo entrenamos una porción muy pequeña de los parámetros. Los métodos más famosos en esta categoría son LORA, Llama Adapter y Prefix-tuning.
Estos métodos abordarán tres aspectos:
Costo del ajuste fino completo – estos métodos solo entrenan un pequeño conjunto de parámetros adicionales en lugar del modelo completo, lo que hace posible ejecutarlos en GPUs de consumo.
Costo de implementación – para cada modelo downstream ajustado, necesitamos implementar un modelo separado; sin embargo, al usar estos métodos, solo un pequeño conjunto de parámetros (pocos MB en lugar de varios GB) del modelo preentrenado puede hacer el trabajo. En este caso, para cada tarea, solo agregamos estos parámetros adicionales sobre el modelo preentrenado, por lo que los modelos preentrenados pueden considerarse como la base y estos parámetros como las "cabezas" para el modelo en diferentes tareas.
Olvido catastrófico — estos métodos también ayudan a evitar el olvido de la primera tarea que puede ocurrir en el ajuste fino.
La biblioteca PEFT de HF proporciona una manera fácil de usar estos métodos, que utilizaremos aquí. Por favor, lee más aquí.
2. Ajuste fino de parámetros completos/parciales
El ajuste fino de parámetros completos tiene sus propias ventajas; en este método, hay múltiples estrategias que pueden ayudar:
Mantener el modelo preentrenado congelado y solo ajustar la "cabeza" de la tarea, por ejemplo, el modelo clasificador.
Mantener el modelo preentrenado congelado y agregar unas pocas capas completamente conectadas en la parte superior.
Ajuste fino en todas las capas.
También puedes mantener la mayoría de las capas congeladas y solo ajustar unas pocas capas. Hay muchas técnicas diferentes para elegir para congelar/descongelar capas basadas en diferentes criterios.
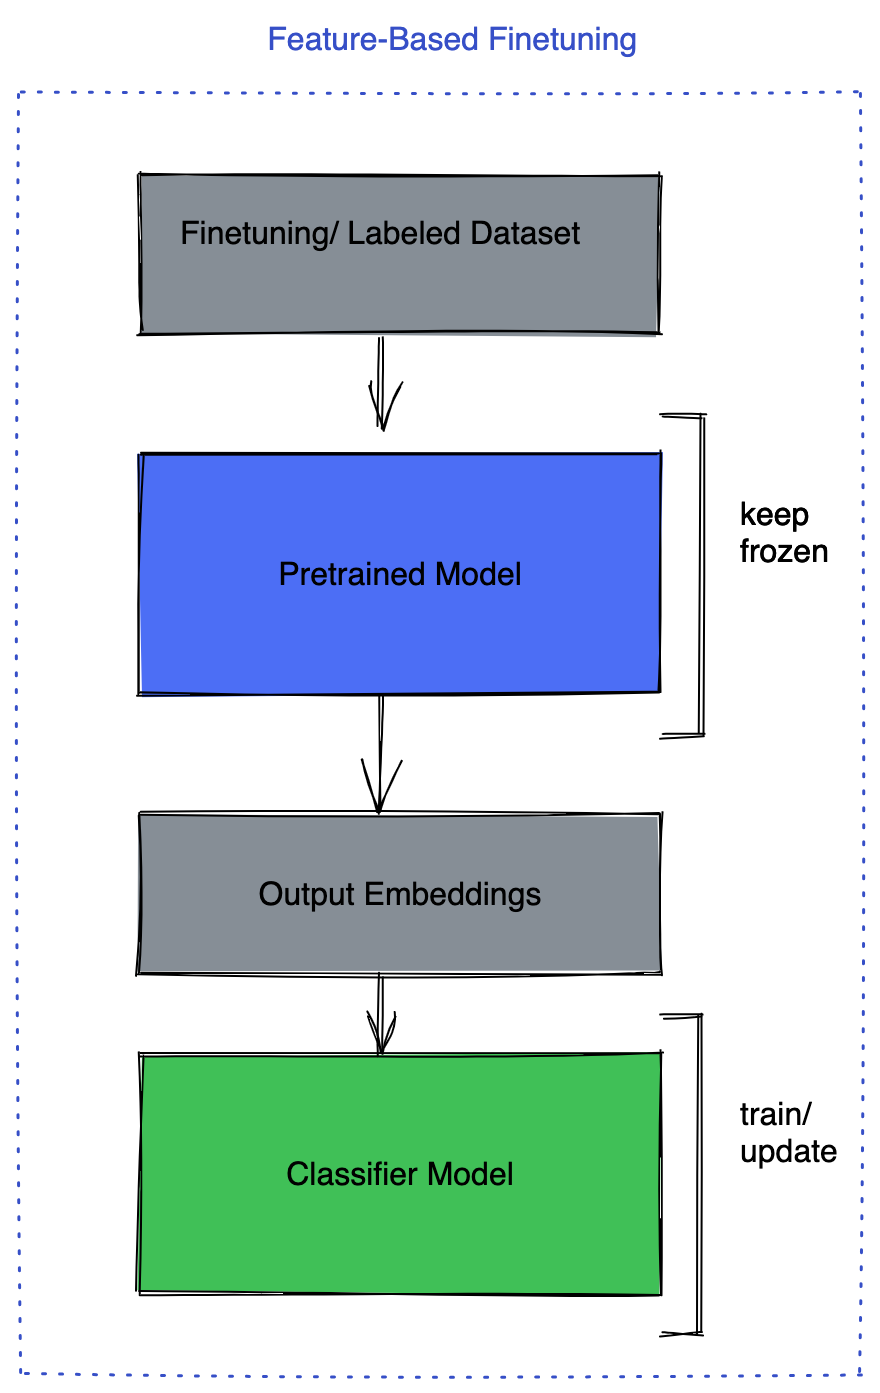
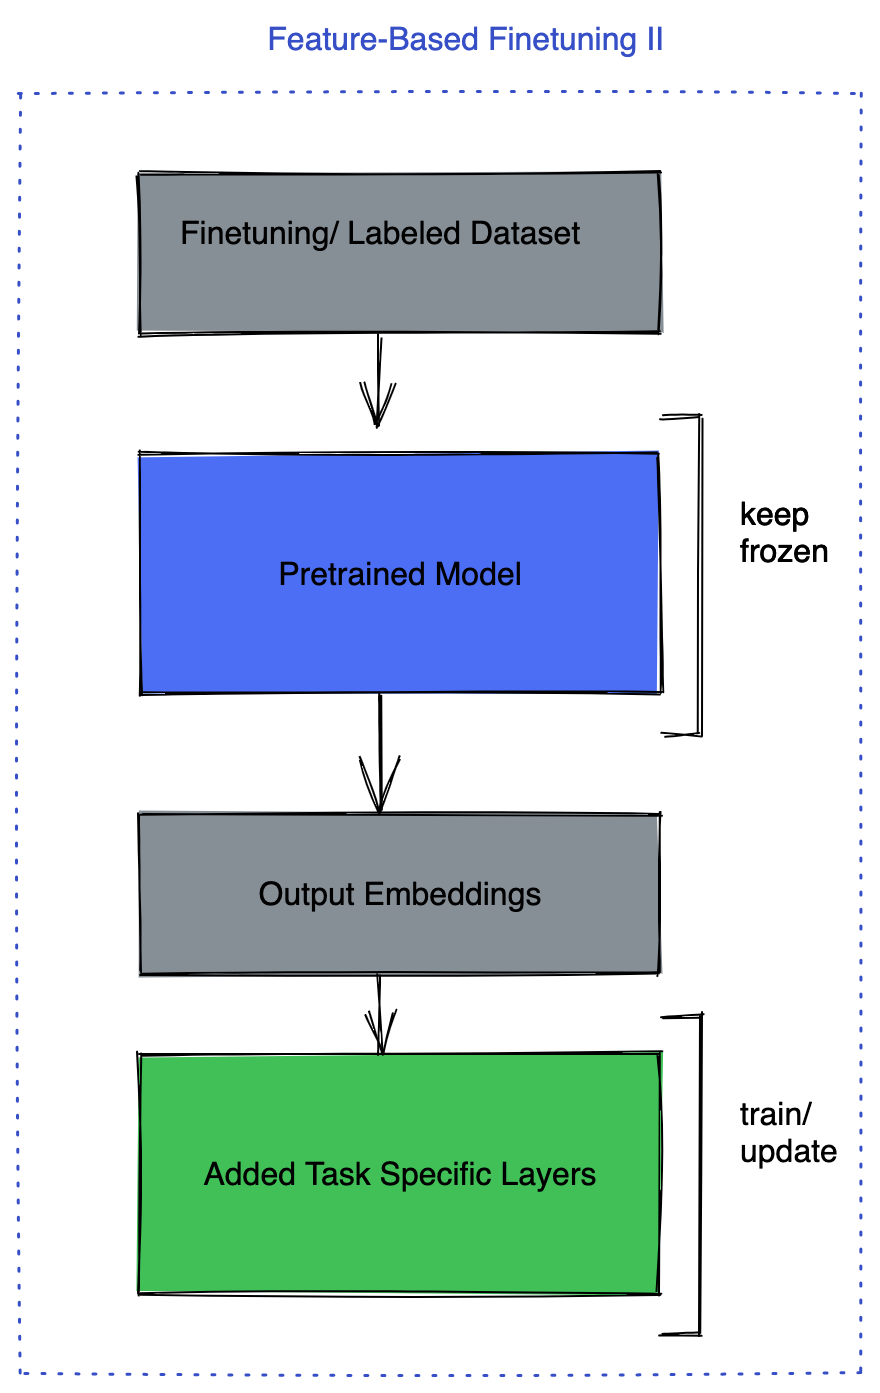
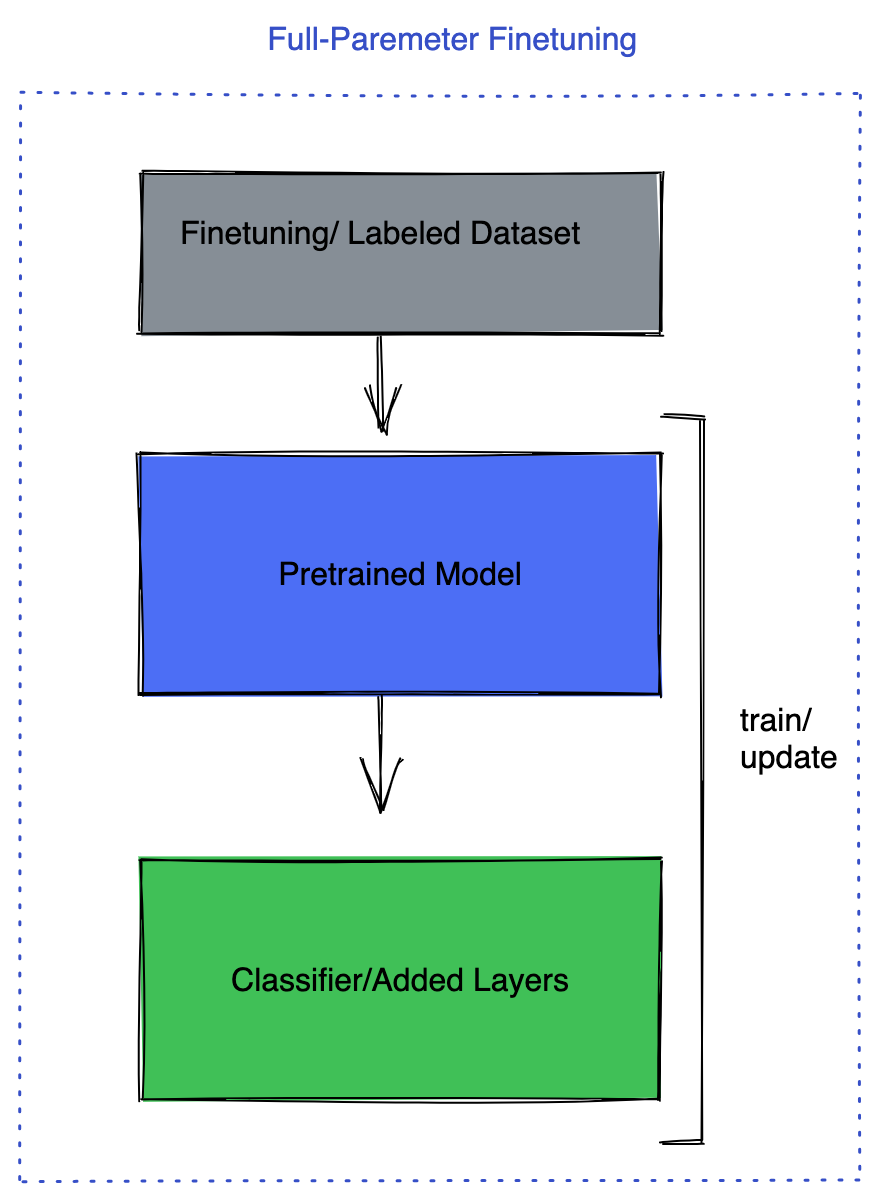
En este escenario, dependiendo del tamaño del modelo, podrías necesitar ir más allá de una GPU, especialmente si tu modelo no cabe en una GPU para el entrenamiento. En este caso, el modelo Meta Llama 3 de 8B parámetros no cabrá en una GPU. La forma en que debes pensarlo es que necesitarías suficiente memoria de GPU para mantener los parámetros del modelo, los gradientes y los estados del optimizador. Donde cada uno de estos, dependiendo de la precisión con la que estés entrenando, puede ocupar varias veces el número de tus parámetros x precisión (dependiendo de si es fp32/4 bytes, fp16/2 bytes/bf16/2 bytes). Por ejemplo, el optimizador AdamW mantiene 2 parámetros por cada uno de tus parámetros y, en muchos casos, estos se mantienen en fp32. Esto implica que, dependiendo de cuántas capas estés entrenando/descongelando, la memoria de tu GPU puede crecer más allá de una GPU.
FSDP (Fully Sharded Data Parallel)
Pytorch tiene el paquete FSDP para entrenar modelos que no caben en una GPU. FSDP te permite entrenar un modelo mucho más grande con la misma cantidad de recursos. Antes de FSDP estaba DDP (Distributed Data Parallel), donde cada GPU contenía una réplica completa del modelo y solo fragmentaba los datos. Al final del paso de retropropagación, sincronizaba los gradientes.
FSDP extiende esta idea, no solo fragmentando los datos, sino también los parámetros del modelo, los gradientes y los estados del optimizador. Esto significa que cada GPU solo mantendrá un fragmento del modelo. Esto resultará en enormes ahorros de memoria que nos permitirán ajustar un modelo mucho más grande en el mismo número de GPUs. Como ejemplo, en DDP, lo máximo que podrías ajustar en una GPU con 16 GB de memoria es un modelo de alrededor de 700M parámetros. Entonces, supongamos que tenías 4 GPUs, en este caso, aunque accedas a 4 GPUs, aún no puedes escalar más allá del tamaño del modelo que puede caber en una GPU. Sin embargo, con FSDP puedes ajustar un modelo de 3B en 4 GPUs, un modelo > 4 veces más grande.
Por favor, lee más sobre FSDP aquí y comienza con FSDP aquí.
Para impulsar el rendimiento del ajuste fino con FSDP, podemos utilizar una serie de características como:
Precisión Mixta que en FSDP es mucho más flexible en comparación con Autocast. Le da al usuario control sobre la configuración de la precisión para los parámetros del modelo, los búferes y los gradientes.
Puntos de Control de Activación que es una técnica para ahorrar memoria descartando la activación intermedia en el paso hacia adelante en lugar de mantenerla en la memoria, con el costo de volver a calcularla en el paso hacia atrás. El punto de control de activación de FSDP es consciente de los fragmentos, lo que significa que debemos aplicarlo después de envolver el modelo con FSDP. En nuestro script, estamos haciendo uso de eso.
auto_wrap_policy Que es la forma de especificar cómo FSDP particionaría el modelo; hay soporte predeterminado para la política de envoltura de transformadores. Esto permite que FSDP forme cada unidad FSDP (partición del modelo) basándose en la clase de transformador en el modelo. Para identificar esta capa en el modelo, debes buscar la capa que envuelve tanto la capa de atención como la MLP. Esto ayuda a FSDP a tener unidades más granulares para la comunicación que ayudan a optimizar el costo de comunicación.