Creación de un chatbot multimodal con la API de Gemini
Copyright 2024 Google LLC.
#@title Licensed under the Apache License, Version 2.0 (the "License");
# you may not use this file except in compliance with the License.
# You may obtain a copy of the License at
#
# https://www.apache.org/licenses/LICENSE-2.0
#
# Unless required by applicable law or agreed to in writing, software
# distributed under the License is distributed on an "AS IS" BASIS,
# WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
# See the License for the specific language governing permissions and
# limitations under the License.
Descripción general
Este notebook te guía a través del proceso de creación de un chatbot multimodal usando la API de Gemini de Google. El chatbot puede:
- Procesar entradas de texto
- Analizar imágenes
- Manejar entradas combinadas de texto e imagen (prompts multimodales)
- Mantener el historial de conversación para respuestas contextuales
- Formatear y presentar respuestas con soporte de markdown
Requisitos previos
- Clave de API de Google para Gemini
- Python 3.9+
- Librerías requeridas: google-generativeai, pillow, IPython, pandas, matplotlib
# Environment Setup
%pip install google-genai pillow IPython pandas matplotlib
Requirement already satisfied: google-generativeai in /usr/local/lib/python3.11/dist-packages (0.8.4)
Requirement already satisfied: pillow in /usr/local/lib/python3.11/dist-packages (11.1.0)
Requirement already satisfied: IPython in /usr/local/lib/python3.11/dist-packages (7.34.0)
Requirement already satisfied: pandas in /usr/local/lib/python3.11/dist-packages (2.2.2)
Requirement already satisfied: matplotlib in /usr/local/lib/python3.11/dist-packages (3.10.0)
Requirement already satisfied: google-ai-generativelanguage==0.6.15 in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (0.6.15)
Requirement already satisfied: google-api-core in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (2.24.2)
Requirement already satisfied: google-api-python-client in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (2.164.0)
Requirement already satisfied: google-auth>=2.15.0 in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (2.38.0)
Requirement already satisfied: protobuf in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (5.29.4)
Requirement already satisfied: pydantic in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (2.11.2)
Requirement already satisfied: tqdm in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (4.67.1)
Requirement already satisfied: typing-extensions in /usr/local/lib/python3.11/dist-packages (from google-generativeai) (4.13.1)
Requirement already satisfied: proto-plus<2.0.0dev,>=1.22.3 in /usr/local/lib/python3.11/dist-packages (from google-ai-generativelanguage==0.6.15->google-generativeai) (1.26.1)
Requirement already satisfied: setuptools>=18.5 in /usr/local/lib/python3.11/dist-packages (from IPython) (75.2.0)
Collecting jedi>=0.16 (from IPython)
Downloading jedi-0.19.2-py2.py3-none-any.whl.metadata (22 kB)
Requirement already satisfied: decorator in /usr/local/lib/python3.11/dist-packages (from IPython) (4.4.2)
Requirement already satisfied: pickleshare in /usr/local/lib/python3.11/dist-packages (from IPython) (0.7.5)
Requirement already satisfied: traitlets>=4.2 in /usr/local/lib/python3.11/dist-packages (from IPython) (5.7.1)
Requirement already satisfied: prompt-toolkit!=3.0.0,!=3.0.1,<3.1.0,>=2.0.0 in /usr/local/lib/python3.11/dist-packages (from IPython) (3.0.50)
Requirement already satisfied: pygments in /usr/local/lib/python3.11/dist-packages (from IPython) (2.18.0)
Requirement already satisfied: backcall in /usr/local/lib/python3.11/dist-packages (from IPython) (0.2.0)
Requirement already satisfied: matplotlib-inline in /usr/local/lib/python3.11/dist-packages (from IPython) (0.1.7)
Requirement already satisfied: pexpect>4.3 in /usr/local/lib/python3.11/dist-packages (from IPython) (4.9.0)
Requirement already satisfied: numpy>=1.23.2 in /usr/local/lib/python3.11/dist-packages (from pandas) (2.0.2)
Requirement already satisfied: python-dateutil>=2.8.2 in /usr/local/lib/python3.11/dist-packages (from pandas) (2.8.2)
Requirement already satisfied: pytz>=2020.1 in /usr/local/lib/python3.11/dist-packages (from pandas) (2025.2)
Requirement already satisfied: tzdata>=2022.7 in /usr/local/lib/python3.11/dist-packages (from pandas) (2025.2)
Requirement already satisfied: contourpy>=1.0.1 in /usr/local/lib/python3.11/dist-packages (from matplotlib) (1.3.1)
Requirement already satisfied: cycler>=0.10 in /usr/local/lib/python3.11/dist-packages (from matplotlib) (0.12.1)
Requirement already satisfied: fonttools>=4.22.0 in /usr/local/lib/python3.11/dist-packages (from matplotlib) (4.57.0)
Requirement already satisfied: kiwisolver>=1.3.1 in /usr/local/lib/python3.11/dist-packages (from matplotlib) (1.4.8)
Requirement already satisfied: packaging>=20.0 in /usr/local/lib/python3.11/dist-packages (from matplotlib) (24.2)
Requirement already satisfied: pyparsing>=2.3.1 in /usr/local/lib/python3.11/dist-packages (from matplotlib) (3.2.3)
Requirement already satisfied: googleapis-common-protos<2.0.0,>=1.56.2 in /usr/local/lib/python3.11/dist-packages (from google-api-core->google-generativeai) (1.69.2)
Requirement already satisfied: requests<3.0.0,>=2.18.0 in /usr/local/lib/python3.11/dist-packages (from google-api-core->google-generativeai) (2.32.3)
Requirement already satisfied: cachetools<6.0,>=2.0.0 in /usr/local/lib/python3.11/dist-packages (from google-auth>=2.15.0->google-generativeai) (5.5.2)
Requirement already satisfied: pyasn1-modules>=0.2.1 in /usr/local/lib/python3.11/dist-packages (from google-auth>=2.15.0->google-generativeai) (0.4.2)
Requirement already satisfied: rsa<5,>=3.1.4 in /usr/local/lib/python3.11/dist-packages (from google-auth>=2.15.0->google-generativeai) (4.9)
Requirement already satisfied: parso<0.9.0,>=0.8.4 in /usr/local/lib/python3.11/dist-packages (from jedi>=0.16->IPython) (0.8.4)
Requirement already satisfied: ptyprocess>=0.5 in /usr/local/lib/python3.11/dist-packages (from pexpect>4.3->IPython) (0.7.0)
Requirement already satisfied: wcwidth in /usr/local/lib/python3.11/dist-packages (from prompt-toolkit!=3.0.0,!=3.0.1,<3.1.0,>=2.0.0->IPython) (0.2.13)
Requirement already satisfied: six>=1.5 in /usr/local/lib/python3.11/dist-packages (from python-dateutil>=2.8.2->pandas) (1.17.0)
Requirement already satisfied: httplib2<1.dev0,>=0.19.0 in /usr/local/lib/python3.11/dist-packages (from google-api-python-client->google-generativeai) (0.22.0)
Requirement already satisfied: google-auth-httplib2<1.0.0,>=0.2.0 in /usr/local/lib/python3.11/dist-packages (from google-api-python-client->google-generativeai) (0.2.0)
Requirement already satisfied: uritemplate<5,>=3.0.1 in /usr/local/lib/python3.11/dist-packages (from google-api-python-client->google-generativeai) (4.1.1)
Requirement already satisfied: annotated-types>=0.6.0 in /usr/local/lib/python3.11/dist-packages (from pydantic->google-generativeai) (0.7.0)
Requirement already satisfied: pydantic-core==2.33.1 in /usr/local/lib/python3.11/dist-packages (from pydantic->google-generativeai) (2.33.1)
Requirement already satisfied: typing-inspection>=0.4.0 in /usr/local/lib/python3.11/dist-packages (from pydantic->google-generativeai) (0.4.0)
Requirement already satisfied: grpcio<2.0dev,>=1.33.2 in /usr/local/lib/python3.11/dist-packages (from google-api-core[grpc]!=2.0.*,!=2.1.*,!=2.10.*,!=2.2.*,!=2.3.*,!=2.4.*,!=2.5.*,!=2.6.*,!=2.7.*,!=2.8.*,!=2.9.*,<3.0.0dev,>=1.34.1->google-ai-generativelanguage==0.6.15->google-generativeai) (1.71.0)
Requirement already satisfied: grpcio-status<2.0.dev0,>=1.33.2 in /usr/local/lib/python3.11/dist-packages (from google-api-core[grpc]!=2.0.*,!=2.1.*,!=2.10.*,!=2.2.*,!=2.3.*,!=2.4.*,!=2.5.*,!=2.6.*,!=2.7.*,!=2.8.*,!=2.9.*,<3.0.0dev,>=1.34.1->google-ai-generativelanguage==0.6.15->google-generativeai) (1.71.0)
Requirement already satisfied: pyasn1<0.7.0,>=0.6.1 in /usr/local/lib/python3.11/dist-packages (from pyasn1-modules>=0.2.1->google-auth>=2.15.0->google-generativeai) (0.6.1)
Requirement already satisfied: charset-normalizer<4,>=2 in /usr/local/lib/python3.11/dist-packages (from requests<3.0.0,>=2.18.0->google-api-core->google-generativeai) (3.4.1)
Requirement already satisfied: idna<4,>=2.5 in /usr/local/lib/python3.11/dist-packages (from requests<3.0.0,>=2.18.0->google-api-core->google-generativeai) (3.10)
Requirement already satisfied: urllib3<3,>=1.21.1 in /usr/local/lib/python3.11/dist-packages (from requests<3.0.0,>=2.18.0->google-api-core->google-generativeai) (2.3.0)
Requirement already satisfied: certifi>=2017.4.17 in /usr/local/lib/python3.11/dist-packages (from requests<3.0.0,>=2.18.0->google-api-core->google-generativeai) (2025.1.31)
Downloading jedi-0.19.2-py2.py3-none-any.whl (1.6 MB)
[2K [90m━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━[0m [32m1.6/1.6 MB[0m [31m47.3 MB/s[0m eta [36m0:00:00[0m
[?25hInstalling collected packages: jedi
Successfully installed jedi-0.19.2# Import Libraries
import os
import time
import base64
from typing import List, Dict, Tuple, Optional, Union
from io import BytesIO
from IPython.display import display, Markdown, Image
import pandas as pd
import matplotlib.pyplot as plt
from PIL import Image as PILImage
from google import genai
from google.genai import typesConfigura tu clave de API
Para ejecutar la siguiente celda, tu clave de API debe estar almacenada en un Secreto de Colab llamado GEMINI_API_KEY. Si aún no tienes una clave de API, o no estás seguro de cómo crear un Secreto de Colab, consulta el inicio rápido de Autenticación para ver un ejemplo.
from google.colab import userdata
GEMINI_API_KEY = userdata.get("GEMINI_API_KEY")
client = genai.Client(api_key=GEMINI_API_KEY)
Modelos Gemini disponibles
Función para listar y mostrar todos los modelos Gemini
# Function to list available models
def list_available_models():
    """Display information about available Gemini models."""
    models = client.models.list()
    model_info = []

    for model in models:
        if 'gemini' in model.name.lower():
            model_info.append({
                'Name': model.name,
                'Description': model.description,
                'Input Limit': model.input_token_limit if hasattr(model, 'input_token_limit') else 'Unknown',
                'Output Limit': model.output_token_limit if hasattr(model, 'output_token_limit') else 'Unknown'
            })

    return pd.DataFrame(model_info)

# Display available models
display(Markdown("### Available Gemini Models"))
models_df = list_available_models()
display(models_df)
<IPython.core.display.Markdown object>Name \
0 models/gemini-1.0-pro-vision-latest
1 models/gemini-pro-vision
2 models/gemini-1.5-pro-latest
3 models/gemini-1.5-pro-001
4 models/gemini-1.5-pro-002
5 models/gemini-1.5-pro
6 models/gemini-3.7-flash
7 models/gemini-3.7-flash
8 models/gemini-1.5-flash-001-tuning
9 models/gemini-3.7-flash
10 models/gemini-3.7-flash
11 models/gemini-3.7-flash
12 models/gemini-3.7-flash
13 models/gemini-3.7-flash
14 models/gemini-1.5-flash-8b-exp-0827
15 models/gemini-1.5-flash-8b-exp-0924
16 models/gemini-2.5-pro-exp-03-25
17 models/gemini-2.5-pro-preview-03-25
18 models/gemini-3.7-flash
19 models/gemini-3.7-flash
20 models/gemini-3.7-flash
21 models/gemini-2.0-flash-exp-image-generation
22 models/gemini-3.7-flash
23 models/gemini-3.7-flash
24 models/gemini-3.7-flash
25 models/gemini-3.7-flash
26 models/gemini-2.0-pro-exp
27 models/gemini-2.0-pro-exp-02-05
28 models/gemini-exp-1206
29 models/gemini-2.0-flash-thinking-exp-01-21
30 models/gemini-2.0-flash-thinking-exp
31 models/gemini-2.0-flash-thinking-exp-1219
32 models/gemini-embedding-exp-03-07
33 models/gemini-embedding-exp
34 models/gemini-2.0-flash-live-001
Description Input Limit \
0 The original Gemini 1.0 Pro Vision model versi... 12288
1 The original Gemini 1.0 Pro Vision model versi... 12288
2 Alias that points to the most recent productio... 2000000
3 Stable version of Gemini 1.5 Pro, our mid-size... 2000000
4 Stable version of Gemini 1.5 Pro, our mid-size... 2000000
5 Stable version of Gemini 1.5 Pro, our mid-size... 2000000
6 Alias that points to the most recent productio... 1000000
7 Stable version of Gemini 3.7 Flash, our fast a... 1000000
8 Version of Gemini 3.7 Flash that supports tuni... 16384
9 Alias that points to the most recent stable ve... 1000000
10 Stable version of Gemini 3.7 Flash, our fast a... 1000000
11 Stable version of Gemini 1.5 Flash-8B, our sma... 1000000
12 Stable version of Gemini 1.5 Flash-8B, our sma... 1000000
13 Alias that points to the most recent productio... 1000000
14 Experimental release (August 27th, 2024) of Ge... 1000000
15 Experimental release (September 24th, 2024) of... 1000000
16 Experimental release (March 25th, 2025) of Gem... 1048576
17 Gemini 2.5 Pro Preview 03-25 1048576
18 Gemini 3.7 Flash Experimental 1048576
19 Gemini 3.7 Flash 1048576
20 Stable version of Gemini 3.7 Flash, our fast a... 1048576
21 Gemini 3.7 Flash (Image Generation) Experimental 1048576
22 Stable version of Gemini 2.0 Flash Lite 1048576
23 Gemini 2.0 Flash-Lite 1048576
24 Preview release (February 5th, 2025) of Gemini... 1048576
25 Preview release (February 5th, 2025) of Gemini... 1048576
26 Experimental release (March 25th, 2025) of Gem... 1048576
27 Experimental release (March 25th, 2025) of Gem... 1048576
28 Experimental release (March 25th, 2025) of Gem... 1048576
29 Experimental release (January 21st, 2025) of G... 1048576
30 Experimental release (January 21st, 2025) of G... 1048576
31 Gemini 2.0 Flash Thinking Experimental 1048576
32 Obtain a distributed representation of a text. 8192
33 Obtain a distributed representation of a text. 8192
34 Gemini 3.7 Flash 001 131072
Output Limit Features
0 4096 [generateContent, countTokens]
1 4096 [generateContent, countTokens]
2 8192 [generateContent, countTokens]
3 8192 [generateContent, countTokens, createCachedCon...
4 8192 [generateContent, countTokens, createCachedCon...
5 8192 [generateContent, countTokens]
6 8192 [generateContent, countTokens]
7 8192 [generateContent, countTokens, createCachedCon...
8 8192 [generateContent, countTokens, createTunedModel]
9 8192 [generateContent, countTokens]
10 8192 [generateContent, countTokens, createCachedCon...
11 8192 [createCachedContent, generateContent, countTo...
12 8192 [createCachedContent, generateContent, countTo...
13 8192 [createCachedContent, generateContent, countTo...
14 8192 [generateContent, countTokens]
15 8192 [generateContent, countTokens]
16 65536 [generateContent, countTokens]
17 65536 [generateContent, countTokens]
18 8192 [generateContent, countTokens, bidiGenerateCon...
19 8192 [generateContent, countTokens]
20 8192 [generateContent, countTokens]
21 8192 [generateContent, countTokens, bidiGenerateCon...
22 8192 [generateContent, countTokens]
23 8192 [generateContent, countTokens]
24 8192 [generateContent, countTokens]
25 8192 [generateContent, countTokens]
26 65536 [generateContent, countTokens]
27 65536 [generateContent, countTokens]
28 65536 [generateContent, countTokens]
29 65536 [generateContent, countTokens]
30 65536 [generateContent, countTokens]
31 65536 [generateContent, countTokens]
32 1 [embedContent, countTextTokens]
33 1 [embedContent, countTextTokens]
34 8192 [bidiGenerateContent, countTokens]| Name | Description | Input Limit | Output Limit | Features | |
|---|---|---|---|---|---|
| 0 | models/gemini-1.0-pro-vision-latest | The original Gemini 1.0 Pro Vision model versi... | 12288 | 4096 | [generateContent, countTokens] |
| 1 | models/gemini-pro-vision | The original Gemini 1.0 Pro Vision model versi... | 12288 | 4096 | [generateContent, countTokens] |
| 2 | models/gemini-1.5-pro-latest | Alias that points to the most recent productio... | 2000000 | 8192 | [generateContent, countTokens] |
| 3 | models/gemini-1.5-pro-001 | Stable version of Gemini 1.5 Pro, our mid-size... | 2000000 | 8192 | [generateContent, countTokens, createCachedCon... |
| 4 | models/gemini-1.5-pro-002 | Stable version of Gemini 1.5 Pro, our mid-size... | 2000000 | 8192 | [generateContent, countTokens, createCachedCon... |
| 5 | models/gemini-1.5-pro | Stable version of Gemini 1.5 Pro, our mid-size... | 2000000 | 8192 | [generateContent, countTokens] |
| 6 | models/gemini-3.7-flash | Alias that points to the most recent productio... | 1000000 | 8192 | [generateContent, countTokens] |
| 7 | models/gemini-3.7-flash | Stable version of Gemini 3.7 Flash, our fast a... | 1000000 | 8192 | [generateContent, countTokens, createCachedCon... |
| 8 | models/gemini-1.5-flash-001-tuning | Version of Gemini 3.7 Flash that supports tuni... | 16384 | 8192 | [generateContent, countTokens, createTunedModel] |
| 9 | models/gemini-3.7-flash | Alias that points to the most recent stable ve... | 1000000 | 8192 | [generateContent, countTokens] |
| 10 | models/gemini-3.7-flash | Stable version of Gemini 3.7 Flash, our fast a... | 1000000 | 8192 | [generateContent, countTokens, createCachedCon... |
| 11 | models/gemini-3.7-flash | Stable version of Gemini 1.5 Flash-8B, our sma... | 1000000 | 8192 | [createCachedContent, generateContent, countTo... |
| 12 | models/gemini-3.7-flash | Stable version of Gemini 1.5 Flash-8B, our sma... | 1000000 | 8192 | [createCachedContent, generateContent, countTo... |
| 13 | models/gemini-3.7-flash | Alias that points to the most recent productio... | 1000000 | 8192 | [createCachedContent, generateContent, countTo... |
| 14 | models/gemini-1.5-flash-8b-exp-0827 | Experimental release (August 27th, 2024) of Ge... | 1000000 | 8192 | [generateContent, countTokens] |
| 15 | models/gemini-1.5-flash-8b-exp-0924 | Experimental release (September 24th, 2024) of... | 1000000 | 8192 | [generateContent, countTokens] |
| 16 | models/gemini-2.5-pro-exp-03-25 | Experimental release (March 25th, 2025) of Gem... | 1048576 | 65536 | [generateContent, countTokens] |
| 17 | models/gemini-2.5-pro-preview-03-25 | Gemini 2.5 Pro Preview 03-25 | 1048576 | 65536 | [generateContent, countTokens] |
| 18 | models/gemini-3.7-flash | Gemini 3.7 Flash Experimental | 1048576 | 8192 | [generateContent, countTokens, bidiGenerateCon... |
| 19 | models/gemini-3.7-flash | Gemini 3.7 Flash | 1048576 | 8192 | [generateContent, countTokens] |
| 20 | models/gemini-3.7-flash | Stable version of Gemini 3.7 Flash, our fast a... | 1048576 | 8192 | [generateContent, countTokens] |
| 21 | models/gemini-2.0-flash-exp-image-generation | Gemini 3.7 Flash (Image Generation) Experimental | 1048576 | 8192 | [generateContent, countTokens, bidiGenerateCon... |
| 22 | models/gemini-3.7-flash | Stable version of Gemini 2.0 Flash Lite | 1048576 | 8192 | [generateContent, countTokens] |
| 23 | models/gemini-3.7-flash | Gemini 2.0 Flash-Lite | 1048576 | 8192 | [generateContent, countTokens] |
| 24 | models/gemini-3.7-flash | Preview release (February 5th, 2025) of Gemini... | 1048576 | 8192 | [generateContent, countTokens] |
| 25 | models/gemini-3.7-flash | Preview release (February 5th, 2025) of Gemini... | 1048576 | 8192 | [generateContent, countTokens] |
| 26 | models/gemini-2.0-pro-exp | Experimental release (March 25th, 2025) of Gem... | 1048576 | 65536 | [generateContent, countTokens] |
| 27 | models/gemini-2.0-pro-exp-02-05 | Experimental release (March 25th, 2025) of Gem... | 1048576 | 65536 | [generateContent, countTokens] |
| 28 | models/gemini-exp-1206 | Experimental release (March 25th, 2025) of Gem... | 1048576 | 65536 | [generateContent, countTokens] |
| 29 | models/gemini-2.0-flash-thinking-exp-01-21 | Experimental release (January 21st, 2025) of G... | 1048576 | 65536 | [generateContent, countTokens] |
| 30 | models/gemini-2.0-flash-thinking-exp | Experimental release (January 21st, 2025) of G... | 1048576 | 65536 | [generateContent, countTokens] |
| 31 | models/gemini-2.0-flash-thinking-exp-1219 | Gemini 2.0 Flash Thinking Experimental | 1048576 | 65536 | [generateContent, countTokens] |
| 32 | models/gemini-embedding-exp-03-07 | Obtain a distributed representation of a text. | 8192 | 1 | [embedContent, countTextTokens] |
| 33 | models/gemini-embedding-exp | Obtain a distributed representation of a text. | 8192 | 1 | [embedContent, countTextTokens] |
| 34 | models/gemini-2.0-flash-live-001 | Gemini 3.7 Flash 001 | 131072 | 8192 | [bidiGenerateContent, countTokens] |
Elige el modelo
DEFAULT_MODEL_NAME = "gemini-3.7-flash"  # @param ["gemini-3.1-pro-preview", "gemini-3.7-flash", "gemini-3.5-flash-lite", "gemini-2.5-pro"] {allow-input: true}
# For Better Performance - You can choose Gemini Pro (Make Note of Rate Limits)
Utilidades de procesamiento de imágenes
Estas funciones ayudan a preparar y procesar imágenes para el modelo Gemini.
def load_image_from_path(image_path: str) -> PILImage.Image:
    """
    Load an image from a file path.

    Args:
        image_path: Path to the image file

    Returns:
        PIL Image object
    """
    try:
        image = PILImage.open(image_path)
        return image
    except Exception as e:
        print(f"Error loading image: {e}")
        return None

def load_image_from_url(image_url: str) -> PILImage.Image:
    """
    Load an image from a URL.

    Args:
        image_url: URL of the image

    Returns:
        PIL Image object
    """
    try:
        import requests
        response = requests.get(image_url)
        image = PILImage.open(BytesIO(response.content))
        return image
    except Exception as e:
        print(f"Error loading image from URL: {e}")
        return None

def resize_image(image: PILImage.Image, max_size: int = 1024) -> PILImage.Image:
    """
    Resize an image while maintaining aspect ratio to ensure it's under
    the size limits for the API.

    Args:
        image: PIL Image object
        max_size: Maximum dimension (width or height)

    Returns:
        Resized PIL Image object
    """
    width, height = image.size

    if max(width, height) > max_size:
        if width > height:
            new_width = max_size
            new_height = int(height * max_size / width)
        else:
            new_height = max_size
            new_width = int(width * max_size / height)

        return image.resize((new_width, new_height))

    return image

def display_image(image: PILImage.Image, width: int = 400):
    """
    Display an image with specified width in the notebook.

    Args:
        image: PIL Image object
        width: Display width
    """
    buffer = BytesIO()
    image.save(buffer, format="PNG")
    image_data = buffer.getvalue()

    display(Image(data=image_data, width=width))
Definición de la clase ChatBot
Esta clase encapsula la funcionalidad de nuestro chatbot, incluyendo el manejo de entradas de texto e imagen, el mantenimiento del historial de conversación y el procesamiento de respuestas.
class GeminiMultimodalChatBot:
    """
    A chatbot that can process both text and images using Google's Gemini models.
    """
    def __init__(
        self,
        client: genai.Client,
        model_name: str = DEFAULT_MODEL_NAME,
        temperature: float = 0.7,
        max_tokens: int = 2048,
        top_p: float = 0.95,
        top_k: int = 40,
        system_prompt: str = None
    ):
        self.client = client
        self.model_name = model_name

        # Initialize the model with generation config and system instructions
        self.config = types.GenerateContentConfig(
            temperature=temperature,
            max_output_tokens=max_tokens,
            top_p=top_p,
            top_k=top_k,
            system_instruction=system_prompt
        )

        # Start a new conversation
        self.reset_conversation()

    def reset_conversation(self):
        """Reset the conversation history."""
        self.conversation = self.client.chats.create(
            model=self.model_name,
            config=self.config
        )

    def send_message(self,
                    text: str = None,
                    image: PILImage.Image = None,
                    stream: bool = False) -> str:
        """Send a message to the chatbot with optional image."""
        content_parts = []

        if text:
            content_parts.append(text)
        if image:
            content_parts.append(image)

        if not content_parts:
            raise ValueError("Must provide at least text or image")

        try:
            # Send the message to the model
            if stream:
                response = self.conversation.send_message_stream(content_parts)
                full_response = ""
                for chunk in response:
                    if hasattr(chunk, 'text') and chunk.text:
                        print(chunk.text, end="", flush=True)
                        full_response += chunk.text
                print()  # New line after streaming completes
                return full_response
            else:
                response = self.conversation.send_message(content_parts)
                return response.text

        except Exception as e:
            error_msg = f"Error communicating with Gemini API: {str(e)}"
            print(error_msg)
            return error_msg

    def get_conversation_history(self):
        """Get the current conversation history."""
        return self.conversation.get_history()

    def display_conversation(self):
        """Display the conversation history in a readable format."""
        history = self.get_conversation_history()

        for entry in history:
            role = entry.role

            if role == "user":
                display(Markdown("### 👤 User:"))
            elif role == "model":
                display(Markdown("### 🤖 Gemini:"))

            for part in entry.parts:
                if hasattr(part, 'text') and part.text:
                    display(Markdown(part.text))
                elif hasattr(part, 'inline_data') and part.inline_data:
                    display(Markdown("*[Image input]*"))
Inicializa el ChatBot
Creemos nuestra instancia de chatbot con algunos parámetros personalizados.
# Define a system prompt to guide the model's behavior
system_prompt = """
  You are a helpful, friendly assistant. When responding to questions:
  - If you're unsure, be honest about your limitations
  - Provide detailed and accurate information
  - For image analysis, describe what you see in detail
  - Use markdown formatting to make responses easy to read
  - When discussing code, include well-commented examples
"""

# Initialize the chatbot
chatbot = GeminiMultimodalChatBot(
    client=client,
    temperature=0.7,
    max_tokens=4096,
    system_prompt=system_prompt
)

''' Temperature set to 0.7 to balance creativity and accuracy in multimodal responses.
    Lower values (0.1-0.3) produce more deterministic outputs but may be too rigid for natural
    image descriptions, while higher values (0.8-1.0) increase creativity but risk less accurate
    interpretations of visual content. 0.7 provides optimal balance for conversational AI
    handling both text and images.'''

print("✅ Multimodal chatbot initialized successfully!")
✅ Multimodal chatbot initialized successfully!Ejemplo de interacción solo con texto
Comencemos con un ejemplo simple solo con texto para probar nuestro chatbot:
# Example text query
text_query = "Explain how transformer models work in machine learning in 4 simple steps."

print("Sending text query to Gemini...\n")
response = chatbot.send_message(text_query)
display(Markdown("### Response:"))
display(Markdown(response))
Sending text query to Gemini...<IPython.core.display.Markdown object><IPython.core.display.Markdown object>Ejemplo de análisis de imagen
Ahora probemos la capacidad del chatbot para analizar una imagen:
# Function to create a sample test image
def create_test_plot():
    """Create a sample plot for testing image analysis."""
    plt.figure(figsize=(10, 6))

    # Create some sample data
    x = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
    y1 = [3, 5, 7, 9, 11, 13, 15, 17, 19, 21]
    y2 = [2, 4, 6, 8, 10, 12, 14, 16, 18, 20]

    # Plot the data
    plt.plot(x, y1, 'b-', label='Series A')
    plt.plot(x, y2, 'r--', label='Series B')

    # Add labels and title
    plt.xlabel('X-Axis')
    plt.ylabel('Y-Axis')
    plt.title('Sample Data Visualization')
    plt.legend()
    plt.grid(True)

    # Save the plot to a BytesIO object
    buf = BytesIO()
    plt.savefig(buf, format='png')
    buf.seek(0)

    # Convert to PIL Image
    test_image = PILImage.open(buf)
    plt.close()

    return test_image

# Create a test image
test_image = create_test_plot()

# Display the image
display(Markdown("### Test Image:"))
display_image(test_image)

# Ask the chatbot to analyze the image
image_query = "What does this image show? Please analyze this chart in detail."

print("\nSending image for analysis...\n")
response = chatbot.send_message(image_query, test_image)
display(Markdown("### Response:"))
display(Markdown(response))
<IPython.core.display.Markdown object><IPython.core.display.Image object>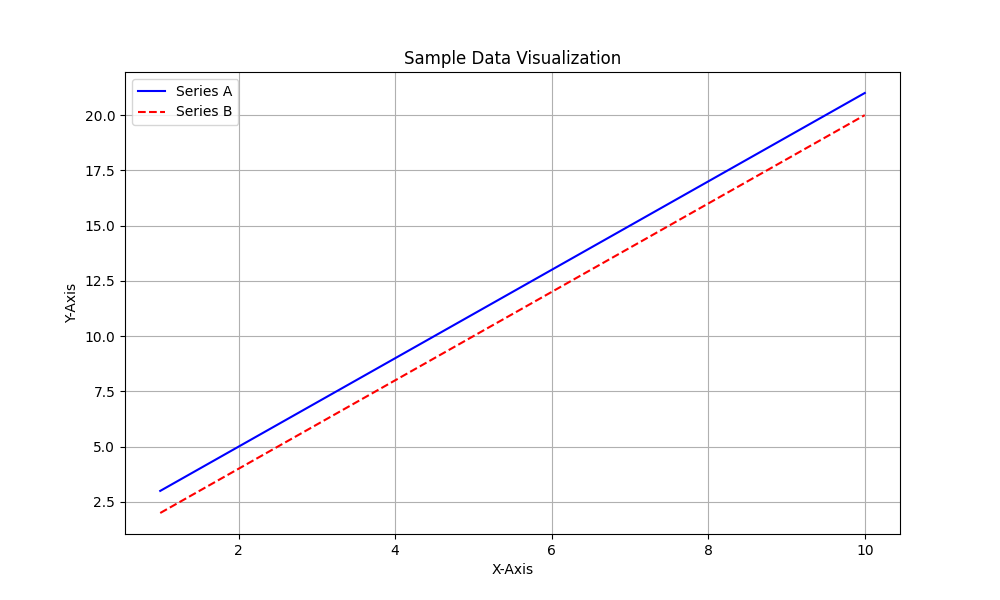
Sending image for analysis...<IPython.core.display.Markdown object><IPython.core.display.Markdown object>Prompting multimodal
Ejemplo combinado de texto e imagen (multimodal)
Ahora probemos el chatbot con una entrada combinada de texto e imagen:
# Create a multimodal prompt
multimodal_query = "Based on the trends shown in this chart, what might be a reasonable prediction for the next three data points in Series A? Explain your reasoning."

print("Sending multimodal query (text + image)...\n")
response = chatbot.send_message(multimodal_query, test_image)
display(Markdown("### Response:"))
display(Markdown(response))
Sending multimodal query (text + image)...<IPython.core.display.Markdown object><IPython.core.display.Markdown object>Característica avanzada: Streaming de respuestas
Demostremos cómo transmitir respuestas del modelo en tiempo real:
display(Markdown("### Streaming Example"))
print("Sending query with streaming enabled...\n")

streaming_query = "Write a short paragraph explaining how neural networks learn from data."
print("Response (streaming):")
chatbot.send_message(streaming_query, stream=True)
<IPython.core.display.Markdown object>Sending query with streaming enabled...
Response (streaming):
Neural networks learn from data through a process of iterative adjustment. Initially, the network's connections (weights) are assigned random values. As data is fed into the network, it produces an output, which is then compared to the desired output. The difference between the predicted and actual output, known as the loss, is used to adjust the weights in the network. This adjustment is typically done using an optimization algorithm like gradient descent, which iteratively modifies the weights to minimize the loss. By repeatedly processing data and adjusting its weights, the network gradually learns to map inputs to the desired outputs, effectively learning the underlying patterns in the data."Neural networks learn from data through a process of iterative adjustment. Initially, the network's connections (weights) are assigned random values. As data is fed into the network, it produces an output, which is then compared to the desired output. The difference between the predicted and actual output, known as the loss, is used to adjust the weights in the network. This adjustment is typically done using an optimization algorithm like gradient descent, which iteratively modifies the weights to minimize the loss. By repeatedly processing data and adjusting its weights, the network gradually learns to map inputs to the desired outputs, effectively learning the underlying patterns in the data.\n"Función interactiva para pruebas de usuario
def process_user_query(text_input=None, image_path=None):
    """
    Process a user query with optional image.

    Args:
        text_input: User's text query
        image_path: Path to an image file (optional)
    """
    image = None
    if image_path:
        image = load_image_from_path(image_path)
        if image:
            image = resize_image(image)
            display(Markdown("### Input Image:"))
            display_image(image)

    display(Markdown(f"### Query: {text_input}"))
    response = chatbot.send_message(text=text_input, image=image)
    display(Markdown("### Response:"))
    display(Markdown(response))

#example:
#process_user_query("What's in this image?", "/content/earth.jpg")
#uncomment to run
# format ( text , path to image)
Personalizando los parámetros del ChatBot
Puedes ajustar varios parámetros para cambiar el comportamiento del chatbot:
# Function to create a new chatbot with custom
''' Temperature set to 0.7 to balance creativity and accuracy in multimodal responses.
        Lower values (0.1-0.3) produce more deterministic outputs but may be too rigid for natural
        image descriptions, while higher values (0.8-1.0) increase creativity but risk less accurate
        interpretations of visual content. 0.7 provides optimal balance for conversational AI
        handling both text and images.'''

def create_custom_chatbot(
    temperature=0.7,
    max_tokens=2048,
    system_prompt="You are a helpful assistant that provides detailed, accurate information."
):
    """
    Create a new chatbot with custom parameters.

    Args:
        temperature: Controls randomness (0.0-1.0)
        max_tokens: Maximum response length
        system_prompt: Initial instructions

    Returns:
        Configured chatbot instance
    """
    return GeminiMultimodalChatBot(
        client=client,
        temperature=temperature,
        max_tokens=max_tokens,
        system_prompt=system_prompt
    )
# Example of creating a more creative chatbot
creative_bot = create_custom_chatbot(
    temperature=0.9,  # Higher temperature for more creative responses
    max_tokens=4096,
    system_prompt="You are a highly creative assistant. Provide imaginative, detailed responses that explore interesting possibilities."
)

# Example of creating a more precise, factual chatbot
precise_bot = create_custom_chatbot(
    temperature=0.1,  # Lower temperature for more deterministic responses
    max_tokens=2048,
    system_prompt="You are a precise, factual assistant. Provide concise, accurate information with minimal speculation."
)
Manejo de errores y limitación de velocidad
En aplicaciones de producción, querrás un manejo robusto de errores y limitación de velocidad.
def send_message_with_retry(
    chatbot: GeminiMultimodalChatBot,
    text: str = None,
    image: PILImage.Image = None,
    max_retries: int = 3,
    retry_delay: int = 2
):
    """
    Send a message with automatic retry for handling rate limits or transient errors.

    Args:
        chatbot: GeminiMultimodalChatBot instance
        text: Text prompt
        image: Image prompt (optional)
        max_retries: Maximum number of retry attempts
        retry_delay: Seconds to wait between retries

    Returns:
        Model response or error message
    """
    retries = 0

    while retries <= max_retries:
        try:
            response = chatbot.send_message(text=text, image=image)
            return response

        except Exception as e:
            error_message = str(e).lower()

            # Handle rate limiting
            if "rate limit" in error_message or "quota" in error_message:
                retries += 1
                if retries <= max_retries:
                    wait_time = retry_delay * retries
                    print(f"Rate limit reached. Retrying in {wait_time} seconds...")
                    time.sleep(wait_time)
                else:
                    return f"Error: Maximum retries reached due to rate limiting. Please try again later."

            # Handle other errors
            else:
                return f"Error communicating with Gemini API: {str(e)}"

    return "Failed to get response after multiple attempts."
Conclusión y próximos pasos
Has construido con éxito un chatbot multimodal usando la API de Gemini de Google que puede:
- Procesar entradas de texto
- Analizar e interpretar imágenes para la comprensión visual
- Manejar entradas combinadas de texto e imagen para conversaciones multimodales enriquecidas
- Mantener un historial de conversación continuo
- Transmitir respuestas en tiempo real para una experiencia de usuario dinámica
Recuerda que el uso responsable de la IA es fundamental: asegúrate de que tu chatbot cumpla con las pautas éticas, respete la privacidad del usuario y comunique claramente las capacidades y limitaciones a los usuarios.
📚 Referencias útiles de la API
Generación de texto
Aprende a:- Generar texto en lenguaje natural a partir de prompts
- Usar el streaming de respuestas para interacciones en tiempo real
- Configurar los parámetros del modelo
Visión
Explora cómo:- Analizar y comprender el contenido de las imágenes
🛠️ Ejemplos relacionados
- Crea una aplicación de chat con Gemini
Un tutorial práctico que te guía a través de:- Configurar una interfaz de chat basada en la web
- Integrar el manejo de entradas de texto e imagen
- Transmitir respuestas del modelo con actualizaciones en vivo
- Mantener el historial de la sesión con estado persistente
🚀 Continúa tu descubrimiento de la API de Gemini
Comienza con la API de Gemini
Perfecto para principiantes para:- Configurar credenciales de API y autenticación
- Realizar tu primera llamada a la API
- Comprender la estructura central de solicitud/respuesta
Profundiza con:
- Ejemplos de código en GitHub
- Experimentación a través de Google AI Studio